Spark en local sur plusieurs gigaoctets
Ce que vous allez construire
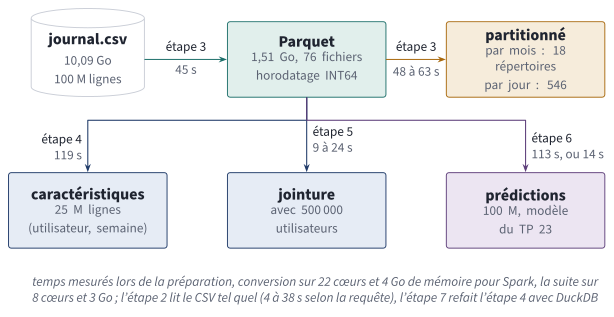
Le parcours du TP et les temps mesurés lors de la préparation. Chaque flèche est un script que vous écrivez.
PDF vectorielÉtape 0 : l'environnement (20 min)
java -version                          # 17 ou 21 ; sinon : sudo apt install openjdk-17-jre-headless
df -h ~ /tmp                           # 25 Go libres dans ~ ; /tmp est-il un tmpfs ?
mkdir -p ~/tp30 && cd ~/tp30
curl -LO https://menraromial.com/ingenierie-deploiement/kits/tp30-kit.tar.gz
tar xzf tp30-kit.tar.gz --strip-components=1 && rm tp30-kit.tar.gz
ls                                     # commun.py  generer_journal.py  inspecter_parquet.py  requirements.txt
pyspark==4.2.0
pandas==2.3.3
pyarrow==25.0.1
duckdb==1.5.5
scikit-learn==1.9.1
joblib==1.6.0
pandas est volontairement en version 2 : PySpark 4.2 affiche PySpark does not yet fully support pandas >= 3.0.0 avec pandas 3. scikit-learn doit être la version exacte qui a entraîné le modèle du TP 23, sans quoi le fichier du modèle ne se recharge pas proprement.
python3 -m venv .venv && source .venv/bin/activate
pip install -r requirements.txt        # 27 s et 1,1 Go lors de la préparation
cp ~/tp23/listify-ml/model.joblib .    # le modèle produit par dvc repro (TP 23)
alias borne='systemd-run --user --scope --quiet -p MemoryMax=6G -p MemorySwapMax=0'
borne true && echo "le plafond mémoire fonctionne"
Gardez l'environnement activé dans chaque terminal du TP. On verra à l'étape 6 ce qui se passe sinon.
Ouvrez commun.py. Il contient la fonction session(), qui crée la session Spark avec les réglages ci-dessus et active le journal d'événements (spark.eventLog.enabled), ainsi que quelques fonctions qui interrogent l'API de l'interface de Spark pour afficher dans le terminal les chiffres que vous lirez aussi à l'écran. Adaptez les deux variables à votre machine :
| Votre machine | Réglage conseillé |
|---|---|
| 8 Go de mémoire | export TP30_COEURS=4 TP30_MEMOIRE=2g, MemoryMax=4G dans l'alias borne, et un journal de 30 millions de lignes à l'étape 1 |
| 16 Go | export TP30_COEURS=8 (mémoire : 3 Go par défaut) |
| 32 Go et plus | aucun réglage : tous les cœurs, 3 Go |
Étape 1 : fabriquer le journal (15 min)
Le générateur reprend les titres et les catégories des vraies tâches de Listify (le fichier du TP 26), et produit un journal chronologique d'actions : 500 000 utilisateurs d'activité très inégale, et un compte particulier, l'utilisateur 42, qui est la synchronisation automatique d'un calendrier et produit 10 % des événements.
mkdir -p data
python generer_journal.py ~/tp26/base/taches_completes.csv data/journal.csv 100
ls -l data/journal.csv && head -3 data/journal.csv
bloc 20/20 écrit (128 s)
100000000 lignes écrites dans data/journal.csv en 128 s
-rw-rw-r-- 1 etudiant etudiant 10092568727 ... data/journal.csv
"horodatage","utilisateur","tache","action","categorie","client","duree_ms","titre"
"2025-01-01T00:00:01",42,264868,"consultation","admin","android",10,"imprimer les billets de train"
"2025-01-01T00:00:01",43034,5088111,"consultation","maison","ios",14,"Ranger les plantes"
Le générateur est déterministe : vous devez obtenir exactement 10 092 568 727 octets. Si votre machine n'a que 8 Go de mémoire, remplacez 100 par 30.
Étape 2 : lire le CSV, et apprendre à regarder (40 min)
"""Étape 2 : lire le journal CSV, avec et sans schéma, et regarder ce que fait Spark."""
from pyspark.sql import functions as F

from commun import DATA, SCHEMA, chrono, pause, session

spark = session("tp30-etape2")
csv = str(DATA / "journal.csv")

with chrono("inferSchema + count"):
    devine = spark.read.csv(csv, header=True, inferSchema=True)
    print(devine.count(), "lignes")
devine.printSchema()

journal = spark.read.csv(csv, header=True, schema=SCHEMA)
with chrono("schéma fourni + count"):
    print(journal.count(), "lignes")

par_categorie = journal.groupBy("categorie").count().orderBy("categorie")
par_categorie.explain()
with chrono("groupBy categorie"):
    par_categorie.show()

with chrono("actions par client, pivot sans liste"):
    journal.groupBy("client").pivot("action").count().show()

ACTIONS = ["consultation", "modification", "creation", "completion", "suppression"]
with chrono("actions par client, pivot avec liste"):
    journal.groupBy("client").pivot("action", ACTIONS).count().show()

pause(spark)
borne python etape2_csv.py --pause
Pendant que le script tourne, ouvrez http://localhost:4040, l'interface de la session. L'option --pause la garde ouverte à la fin du script, jusqu'à ce que vous appuyiez sur Entrée. Voici ce que la préparation a mesuré, sur 22 cœurs :
[inferSchema + count] 30.3 s
[schéma fourni + count] 4.1 s
[groupBy categorie] 17.5 s
[actions par client, pivot sans liste] 38.2 s
[actions par client, pivot avec liste] 20.3 s
Allez chercher dans l'interface l'explication de chaque écart, sans lire la suite :
- Onglet Jobs. Combien de jobs lance
inferSchema? Et le pivot sans liste ? L'un devine les types en lisant tout le fichier une première fois, l'autre cherche les valeurs distinctes deactionpour savoir quelles colonnes créer. Dans les deux cas, 9,4 Gio sont lus deux fois. Donner le schéma et la liste des valeurs, c'est épargner une lecture complète. - Onglet Stages. L'étape de lecture compte 76 tâches, une par tranche de 128 Mio du fichier. Ouvrez-la : la ligne Duration du tableau Summary Metrics donne la durée des tâches (minimum, médiane, maximum).
- Le plan.
explain()a affiché deuxExchange: unhashpartitioningpour le regroupement, unrangepartitioningpour le tri. Deux shuffles, donc trois étapes. - Le comptage (4,1 s) est quatre fois plus rapide que le regroupement (17,5 s), pour les mêmes octets lus. Pour compter des lignes, Spark n'a pas besoin de découper chaque ligne en colonnes.
Point de contrôle 2
- 100 000 000 lignes, et par catégorie : admin 25 733 548, courses 16 423 782, loisirs 15 808 748, maison 18 088 851, travail 23 945 071.
- Vous savez retrouver, dans l'interface, le nombre de jobs, d'étapes et de tâches d'une requête, et la durée médiane et maximale de ses tâches.
- Au runbook : pour chaque écart de temps, la cause que vous avez lue dans l'interface.
Étape 3 : Parquet, ou l'art de ne pas lire (50 min)
"""Étape 3 : convertir le journal en Parquet, et mesurer ce que le format change.

Usage : python etape3_parquet.py convertir [micros]
        python etape3_parquet.py interroger <répertoire>
        python etape3_parquet.py partitionner [mois] [jour]
"""
import sys

from pyspark.sql import functions as F

from commun import DATA, SCHEMA, chrono, lignes_lues, pause, session

mode = sys.argv[1]


def mars():                        # une expression F.col(...) exige une session déjà créée
    return (F.col("horodatage") >= "2026-03-01") & (F.col("horodatage") < "2026-04-01")


if mode == "convertir":
    micros = len(sys.argv) > 2 and sys.argv[2] == "micros"
    reglages = {"spark.sql.parquet.outputTimestampType": "TIMESTAMP_MICROS"} if micros else {}
    spark = session("tp30-conversion", **reglages)
    journal = spark.read.csv(str(DATA / "journal.csv"), header=True, schema=SCHEMA)
    sortie = DATA / ("journal-micros.parquet" if micros else "journal.parquet")
    with chrono(f"écriture de {sortie.name}"):
        journal.write.mode("overwrite").parquet(str(sortie))

elif mode == "interroger":
    spark = session("tp30-interroger")
    journal = spark.read.parquet(str(DATA / sys.argv[2]))
    for i in (1, 2):                     # la seconde fois, sans le coût du premier accès
        with chrono(f"{sys.argv[2]} : nombre par catégorie ({i})"):
            journal.groupBy("categorie").count().collect()
        with chrono(f"{sys.argv[2]} : durée moyenne en mars 2026 ({i})"):
            r = journal.where(mars()).agg(F.avg("duree_ms"), F.count("*")).collect()[0]
        print(f"  lignes lues par le scan : {lignes_lues(spark):,}".replace(",", " "))
    print("mars 2026 :", r[1], "événements, durée moyenne", round(r[0], 3), "ms")
    journal.where(mars()).agg(F.avg("duree_ms")).explain()

elif mode == "partitionner":
    spark = session("tp30-partitions")
    journal = spark.read.parquet(str(DATA / "journal-micros.parquet"))
    grains = {"mois": F.date_format("horodatage", "yyyy-MM"), "jour": F.to_date("horodatage")}
    choisis = sys.argv[2:] or list(grains)
    for choix in choisis:
        grain, _, variante = choix.partition("-")
        sortie = str(DATA / f"journal-par-{choix}.parquet")
        source = journal.withColumn(grain, grains[grain])
        if variante in ("melange", "regroupe"):
            source = source.repartition(200)                 # données redistribuées au hasard
        if variante == "regroupe":
            source = source.repartition(grain)               # puis regroupées par la colonne de partition
        with chrono(f"écriture partitionnée par {choix}"):
            source.write.mode("overwrite").partitionBy(grain).parquet(sortie)
        relu = spark.read.parquet(sortie)
        with chrono(f"par {choix} : nombre par catégorie, tout le journal"):
            relu.groupBy("categorie").count().collect()
        filtre = (F.col(grain) == "2026-03") if grain == "mois" else F.col(grain).between("2026-03-01", "2026-03-31")
        with chrono(f"par {choix} : durée moyenne en mars 2026"):
            relu.where(filtre).agg(F.avg("duree_ms")).collect()
    relu.where(filtre).agg(F.avg("duree_ms")).explain()

pause(spark)
La première version de ce script définissait le filtre mars comme une constante, en tête de fichier. Elle a échoué avant même de démarrer, avec AssertionError sur SparkContext._active_spark_context. Une expression F.col(...) a besoin d'une session existante, d'où la fonction mars(), appelée après session().
3.1 Convertir, avec les réglages par défaut
borne python etape3_parquet.py convertir
python inspecter_parquet.py data/journal.parquet
borne python etape3_parquet.py interroger journal.parquet
[écriture de journal.parquet] 43.6 s
76 fichiers  76 groupes de lignes  100 000 000 lignes  1 436 Mio de données
  tache           381.7 Mio   26.6 %
  utilisateur     356.6 Mio   24.8 %
  horodatage      336.2 Mio   23.4 %
  titre           158.5 Mio   11.0 %
  duree_ms        106.7 Mio    7.4 %
  categorie        36.2 Mio    2.5 %
  action           36.1 Mio    2.5 %
  client           24.2 Mio    1.7 %
colonne horodatage : type INT96, min/max présents : False
[journal.parquet : nombre par catégorie (2)] 1.1 s
[journal.parquet : durée moyenne en mars 2026 (2)] 1.5 s
  lignes lues par le scan : 100 000 000
mars 2026 : 5679276 événements, durée moyenne 35.369 ms
Le fichier fait 1,52 Go au lieu de 10,09, et le comptage par catégorie passe de 17,5 s à 1,1 s. Mais regardez les deux dernières lignes de l'inspection, puis le compteur du scan : pour une moyenne sur un mois, Spark lit les 100 millions de lignes. Le filtre figure pourtant dans le plan (PushedFilters). C'est le piège de l'exemple 36.8 : Spark 4.2 écrit encore les horodatages au type INT96, pour lequel Parquet ne garde ni minimum ni maximum.
Vous trouverez le compteur dans l'interface : onglet SQL / DataFrame, cliquez sur la requête, puis regardez le nœud Scan parquet et sa ligne number of output rows.
3.2 Convertir, avec des horodatages standard
borne python etape3_parquet.py convertir micros
python inspecter_parquet.py data/journal-micros.parquet
borne python etape3_parquet.py interroger journal-micros.parquet
[écriture de journal-micros.parquet] 45.2 s
colonne horodatage : type INT64, min/max présents : True
  premier groupe : 2024-12-31 23:00:01+00:00 -> 2025-01-08 04:52:55+00:00
[journal-micros.parquet : durée moyenne en mars 2026 (2)] 0.3 s
  lignes lues par le scan : 5 699 430
mars 2026 : 5679276 événements, durée moyenne 35.369 ms
Même résultat, en lisant 5,7 millions de lignes au lieu de 100. Le compte n'est pas exactement celui de mars (5 679 276). Spark saute les groupes de lignes entiers dont le min et le max excluent mars, puis, dans les groupes restants, les pages hors période grâce à l'index de colonnes de Parquet. Il lit donc un peu au-delà des bords du mois, jamais moins.
Remarquez aussi le premier horodatage : 2024-12-31 23:00:01+00:00, alors que le CSV commence le 1ᵉʳ janvier 2025 à minuit. Le CSV ne précisait pas de fuseau. Spark l'a lu à l'heure de la session (Europe/Paris, UTC+1 en hiver) et Parquet l'a rangé en UTC. Un journal sans fuseau explicite est une source classique de décalages d'une heure entre deux systèmes.
3.3 Partitionner, et le piège des petits fichiers
borne python etape3_parquet.py partitionner mois jour
Lors de la préparation, sur 22 cœurs avec 3 Go, le partitionnement par mois a réussi. Celui par jour a échoué :
[écriture partitionnée par mois] 48.3 s
[par mois : nombre par catégorie, tout le journal] 2.2 s
[par mois : durée moyenne en mars 2026] 0.5 s
Caused by: java.lang.OutOfMemoryError: Java heap space
	at org.apache.spark.sql.execution.datasources.FileFormatDataWriter...
Chaque tâche qui écrit des partitions garde des écrivains Parquet ouverts, avec leurs tampons en mémoire, et 22 tâches simultanées ont dépassé les 3 Go du tas Java. Avec TP30_COEURS=8, la même écriture passe :
TP30_COEURS=8 borne python etape3_parquet.py partitionner jour
find data/journal-par-jour.parquet -name '*.parquet' | wc -l
[écriture partitionnée par jour] 53.6 s
[par jour : nombre par catégorie, tout le journal] 2.8 s
[par jour : durée moyenne en mars 2026] 0.4 s
620
Le plan montre cette fois PartitionFilters: [... (jour >= 2026-03-01), (jour <= 2026-03-31)] : Spark ne liste même pas les 515 autres répertoires. Il y a 620 fichiers pour 546 jours, parce que le journal est trié par date : chaque tâche de lecture couvre environ une semaine et n'écrit que dans sept ou huit répertoires.
Voyons maintenant ce qui arrive quand les données ne sont pas rangées, par exemple après une jointure ou un repartition qui les a mélangées :
TP30_COEURS=8 borne python etape3_parquet.py partitionner jour-melange jour-regroupe
| Écriture par jour | Temps d'écriture | Fichiers | Taille | Comptage complet | Un mois |
|---|---|---|---|---|---|
| journal trié | 53,6 s | 620 | 1,6 Go | 2,8 s | 0,4 s |
après repartition(200) | 361,4 s | 109 201 | 3,5 Go | 43,6 s | 3,1 s |
puis repartition("jour") | 62,6 s | 547 | 1,6 Go | 2,3 s | 0,5 s |
Après le mélange, chacune des 200 tâches contient des lignes de chacun des 546 jours, et en écrit un fichier dans chaque répertoire : fichiers de 27 Kio en moyenne. Ils se compressent mal (3,5 Go au lieu de 1,6), et relire le jeu de données prend quinze fois plus de temps, parce qu'ouvrir et lire le pied de 109 201 fichiers coûte plus cher que de lire leurs données. Redistribuer par la colonne de partition avant d'écrire rassemble chaque jour dans une seule tâche et règle le problème.
Point de contrôle 3
journal-micros.parquetexiste, et l'inspection affichemin/max présents : True.- Pour la requête de mars, vous avez relevé dans l'onglet SQL les lignes lues par le scan, avec et sans statistiques.
- Au runbook : le tableau des trois écritures par jour, avec vos chiffres, et une règle en une phrase sur
partitionBy.
Étape 4 : une table de caractéristiques pour un modèle (40 min)
Un modèle qui prédirait, par exemple, qu'un utilisateur va abandonner Listify n'apprendrait pas sur 100 millions d'événements bruts. Il apprendrait sur une ligne par utilisateur et par semaine, qui résume son activité. Calculer ce résumé, c'est le travail typique de Spark dans une chaîne de ML (chapitre 36, §9).
"""Étape 4 : une table de caractéristiques par utilisateur et par semaine, pour un futur modèle."""
from pyspark.sql import functions as F

from commun import DATA, chrono, pause, session, shuffle_total

spark = session("tp30-caracteristiques")
journal = spark.read.parquet(str(DATA / "journal-micros.parquet"))

ROBOT = 42      # la synchronisation d'un calendrier : ce n'est pas un comportement humain
caracteristiques = (
    journal.where(F.col("utilisateur") != ROBOT)
    .withColumn("semaine", F.date_trunc("week", "horodatage").cast("date"))
    .groupBy("utilisateur", "semaine")
    .agg(F.count("*").alias("actions"),
         F.sum((F.col("action") == "creation").cast("int")).alias("creations"),
         F.sum((F.col("action") == "completion").cast("int")).alias("completions"),
         F.round(F.avg(F.hour("horodatage")), 1).alias("heure_moyenne"),
         F.percentile_approx("duree_ms", 0.5).alias("duree_mediane_ms"),
         F.mode("categorie").alias("categorie_principale"))
    .withColumn("taux_completion",
                F.when(F.col("creations") > 0, F.round(F.col("completions") / F.col("creations"), 2)))
)
caracteristiques.explain()

avant = shuffle_total(spark)
with chrono("calcul et écriture des caractéristiques"):
    caracteristiques.write.mode("overwrite").parquet(str(DATA / "caracteristiques.parquet"))
print(f"shuffle écrit : {(shuffle_total(spark) - avant) / 2**20:.1f} Mio")

table = spark.read.parquet(str(DATA / "caracteristiques.parquet"))
print(table.count(), "lignes (utilisateur, semaine)")
table.orderBy("utilisateur", "semaine").show(5)
table.describe("actions", "taux_completion", "duree_mediane_ms").show()

pause(spark)
TP30_COEURS=8 borne python etape4_caracteristiques.py
[calcul et écriture des caractéristiques] 119.2 s
shuffle écrit : 1719.4 Mio
25060030 lignes (utilisateur, semaine)
+-----------+----------+-------+---------+-----------+-------------+----------------+--------------------+---------------+
|utilisateur|   semaine|actions|creations|completions|heure_moyenne|duree_mediane_ms|categorie_principale|taux_completion|
+-----------+----------+-------+---------+-----------+-------------+----------------+--------------------+---------------+
|          1|2025-01-27|      1|        0|          0|         14.0|              12|             loisirs|           NULL|
|          1|2025-02-03|      1|        0|          0|          9.0|              23|             courses|           NULL|
...
|summary|           actions|    taux_completion|  duree_mediane_ms|
|  count|          25060030|            6611327|          25060030|
|   mean|3.5913963391105277|0.41479264147725553|30.434616359198294|
|    max|               335|               15.0|               720|
Trois observations à noter au runbook :
- Le robot est exclu. Gardé, il produirait 78 lignes (une par semaine) de plus de 100 000 actions chacune. Aucun modèle de comportement humain ne doit apprendre là-dessus. Filtrer tôt, avant le shuffle, économise aussi 10 % du travail.
- Un taux de complétion de 15 n'est pas une erreur de calcul : un utilisateur peut compléter cette semaine des tâches créées les semaines précédentes. Une caractéristique se définit avec soin, et se vérifie avec
describe(). - Le plan montre
ObjectHashAggregateau lieu duHashAggregatedes requêtes simples. La médiane approchée et la catégorie la plus fréquente ne se résument pas en un nombre : chaque tâche transporte, pour chaque groupe, une structure entière (un résumé des durées, un compteur par catégorie). Sans ces deux colonnes, la préparation a mesuré 39,1 s et 708 Mio de shuffle au lieu de 119,2 s et 1 719 Mio. Elles triplent le coût du calcul : une question à poser à l'équipe qui les demande.
Étape 5 : la jointure et la clé lourde (35 min)
"""Étape 5 : joindre le journal à la table des utilisateurs, et rencontrer la clé déséquilibrée.

Usage : python etape5_jointure.py preparer | auto | tri-fusion | sans-aqe | diffusion
"""
import sys

from pyspark.sql import functions as F

from commun import DATA, chrono, derniere_etape, etapes_lourdes, pause, session, shuffle_total

mode = sys.argv[1]
# tri-fusion et diffusion : on interdit la diffusion automatique, comme si la table des utilisateurs était
# trop grosse (des millions de comptes) ; en mode diffusion, on la force quand même par un indice explicite
reglages = {} if mode in ("preparer", "auto") else {"spark.sql.autoBroadcastJoinThreshold": "-1"}
if mode == "sans-aqe":                    # sans exécution adaptative : les 200 partitions restent 200 tâches
    reglages["spark.sql.adaptive.enabled"] = "false"
spark = session(f"tp30-jointure-{mode}", **reglages)

if mode == "preparer":
    PAYS = F.array(*[F.lit(p) for p in ["FR", "BE", "CH", "CA", "SN", "CI", "CM", "MA", "TN", "DZ"]])
    utilisateurs = spark.range(1, 500_001).select(
        F.col("id").cast("int").alias("utilisateur"),
        F.concat(F.lit("u"), F.sha2(F.col("id").cast("string"), 256).substr(1, 11)).alias("pseudo"),
        F.concat(F.sha2(F.col("id").cast("string"), 224).substr(1, 10), F.lit("@exemple.org")).alias("courriel"),
        F.element_at(PAYS, (F.col("id") % 10 + 1).cast("int")).alias("pays"),
        F.date_add(F.lit("2024-01-01"), (F.col("id") % 540).cast("int")).alias("inscription"),
        F.when(F.col("id") % 7 == 0, "premium").otherwise("gratuit").alias("formule"))
    utilisateurs.write.mode("overwrite").parquet(str(DATA / "utilisateurs.parquet"))
    print(spark.read.parquet(str(DATA / "utilisateurs.parquet")).count(), "utilisateurs")

else:
    journal = spark.read.parquet(str(DATA / "journal-micros.parquet"))
    utilisateurs = spark.read.parquet(str(DATA / "utilisateurs.parquet"))
    if mode == "diffusion":
        utilisateurs = F.broadcast(utilisateurs)        # on envoie la table entière à chaque tâche
    requete = (journal.join(utilisateurs, "utilisateur")
               .groupBy("pays", "formule").agg(F.count("*").alias("actions"), F.avg("duree_ms").alias("duree_moyenne")))
    requete.explain()
    debut, avant = derniere_etape(spark), shuffle_total(spark)
    with chrono(f"jointure ({mode})"):
        resultat = requete.orderBy("pays", "formule").collect()
    print(f"shuffle écrit : {(shuffle_total(spark) - avant) / 2**20:.1f} Mio")
    etapes_lourdes(spark, debut)
    for ligne in resultat[:4]:
        print(" ", ligne["pays"], ligne["formule"], ligne["actions"], round(ligne["duree_moyenne"], 2))

pause(spark)
export TP30_COEURS=8
borne python etape5_jointure.py preparer && du -sh data/utilisateurs.parquet     # 14M
for m in auto tri-fusion sans-aqe diffusion; do borne python etape5_jointure.py $m; done
| Mode | Stratégie dans le plan | Temps | Shuffle | Étape de la jointure |
|---|---|---|---|---|
auto (défaut) | BroadcastHashJoin | 9,3 s | 0 | |
tri-fusion | SortMergeJoin | 24,3 s | 817,5 Mio | 15 tâches, médiane 7,3 s, max 9,6 s |
sans-aqe | SortMergeJoin | 23,4 s | 817,8 Mio | 200 tâches, médiane 0,4 s, max 6,3 s |
diffusion (indice) | BroadcastHashJoin | 9,9 s | 0 |
Chaque ligne demande une lecture attentive :
auto. Le fichier des utilisateurs pèse 14,2 Mo, plus que le seuil de diffusion automatique (10 Mo). Spark diffuse pourtant : la requête n'utilise que 3 colonnes sur 6, et il réduit son estimation de taille en proportion.tri-fusion. Les deux tables passent par le shuffle. L'exécution adaptative a regroupé les 200 partitions en 15 tâches, si bien que le déséquilibre se voit à peine (9,6 s au plus contre 7,3 s en médiane).sans-aqe. Sans ce regroupement, le déséquilibre saute aux yeux : la moitié des tâches dure moins de 0,4 s, et une seule dure 6,3 s. Retrouvez-la dans l'onglet Stages, triez les tâches par durée : c'est celle qui lit dix millions de lignes, celles de l'utilisateur 42.diffusion. L'indiceF.broadcastl'emporte sur le seuil interdit. Pas de shuffle, et l'utilisateur 42 ne gêne plus personne.
Étape 6 : prédire 100 millions de lignes (35 min)
C'est la prédiction par lots du chapitre 30, à l'échelle : appliquer le modèle de Listify à chaque ligne du journal, et mesurer son accord avec la catégorie enregistrée.
"""Étape 6 : appliquer le modèle de Listify à tout le journal, prédiction par lots (chapitre 30).

Usage : python etape6_prediction.py naif | distincts
"""
import sys

import joblib
import pandas as pd
from pyspark.sql import functions as F

from commun import DATA, ICI, chrono, pause, session

MODELE = str(ICI / "model.joblib")          # le modèle entraîné au TP 23 (dvc repro)
mode = sys.argv[1]
spark = session(f"tp30-prediction-{mode}")
journal = spark.read.parquet(str(DATA / "journal-micros.parquet"))
# le journal dit « admin », le modèle a appris l'étiquette officielle « administratif » (params.yaml)
verite = F.when(F.col("categorie") == "admin", "administratif").otherwise(F.col("categorie"))


def predire(lots):
    """Exécuté dans chaque tâche : le modèle est chargé une fois, puis appliqué lot par lot."""
    modele = joblib.load(MODELE)
    for lot in lots:
        yield pd.DataFrame({"verite": lot["verite"], "predite": modele.predict(lot[["titre"]])})


if mode == "naif":
    predictions = (journal.select("titre", verite.alias("verite"))
                   .mapInPandas(predire, "verite string, predite string"))
else:
    # 100 millions de lignes, mais combien de titres différents ?
    with chrono("titres distincts"):
        titres = journal.select("titre").distinct().toPandas()
    print(len(titres), "titres distincts")
    with chrono("prédiction sur le driver"):
        titres["predite"] = joblib.load(MODELE).predict(titres[["titre"]])
    table = spark.createDataFrame(titres)
    predictions = journal.select("titre", verite.alias("verite")).join(F.broadcast(table), "titre")

with chrono(f"prédiction de tout le journal ({mode})"):
    r = predictions.agg(F.count("*").alias("n"),
                        F.avg((F.col("verite") == F.col("predite")).cast("int")).alias("precision")).collect()[0]
print(f"{r['n']} prédictions, accord avec la catégorie du journal : {r['precision']:.4f}")

pause(spark)
mapInPandas confie chaque partition à un processus Python, qui reçoit les lignes par lots de 10 000 au format Arrow, charge le modèle une fois par tâche et prédit lot par lot. C'est le motif de la prédiction par lots distribuée : aucun shuffle, un travail parfaitement parallèle.
TP30_COEURS=8 borne python etape6_prediction.py naif
Lors de la préparation, la première exécution a échoué en quinze secondes :
org.apache.spark.api.python.PythonException: ... An exception was thrown from the Python worker:
ModuleNotFoundError: No module named 'pyarrow'
Le script avait été lancé par .venv/bin/python, sans activer l'environnement. Le driver tournait donc dans l'environnement virtuel, mais Spark lance ses processus Python avec la commande python3 qu'il trouve dans le PATH, celle du système, qui n'a pas pyarrow. Activez l'environnement, ou fixez PYSPARK_PYTHON, ce que fait désormais commun.py par précaution (os.environ.setdefault("PYSPARK_PYTHON", sys.executable)).
[prédiction de tout le journal (naif)] 113.4 s
100000000 prédictions, accord avec la catégorie du journal : 0.9289
Environ 880 000 prédictions par seconde sur 8 cœurs. Maintenant, posez-vous la question que pose le commentaire du second mode : combien de titres différents y a-t-il dans ces 100 millions de lignes ?
TP30_COEURS=8 borne python etape6_prediction.py distincts
[titres distincts] 5.3 s
4395 titres distincts
[prédiction sur le driver] 1.0 s
[prédiction de tout le journal (distincts)] 8.1 s
100000000 prédictions, accord avec la catégorie du journal : 0.9289
Même résultat, à la quatrième décimale près, en 14,4 s au lieu de 113,4. Le modèle est déterministe : deux titres identiques reçoivent la même prédiction. Au lieu de prédire 100 millions de fois, on prédit les 4 395 titres distincts sur le driver, puis on diffuse la petite table de correspondance et on la joint au journal. Ce n'est pas une astuce de Spark, c'est une astuce de données, et elle vaut sur n'importe quel moteur. Elle a une limite, que vous écrirez au runbook : elle suppose que la prédiction ne dépend que du titre.
Étape 7 : et sans Spark ? (20 min)
La même table de caractéristiques qu'à l'étape 4, avec DuckDB, sur la même machine :
"""Étape 7 : la table de caractéristiques de l'étape 4, avec DuckDB, sur une seule machine."""
import resource
import sys
import time

import duckdb

SQL = """
copy (
  select utilisateur,
         date_trunc('week', horodatage)::date                         as semaine,
         count(*)                                                     as actions,
         sum((action = 'creation')::int)                              as creations,
         sum((action = 'completion')::int)                            as completions,
         round(avg(hour(horodatage)), 1)                              as heure_moyenne,
         {lourds}
  from read_parquet('data/journal-micros.parquet/*.parquet')
  where utilisateur <> 42
  group by all
) to 'data/caracteristiques-duckdb.parquet' (format parquet)
"""
con = duckdb.connect()
con.sql("set memory_limit = '4GB'")          # comme Spark, on borne la mémoire
if "--fils" in sys.argv:
    con.sql(f"set threads = {sys.argv[sys.argv.index('--fils') + 1]}")
LOURDS = """approx_quantile(duree_ms, 0.5)                               as duree_mediane_ms,
         mode(categorie)                                              as categorie_principale"""
SQL = SQL.format(lourds=LOURDS if "--leger" not in sys.argv else "avg(duree_ms) as duree_moyenne_ms")
debut = time.perf_counter()
con.sql(SQL)
print(f"[DuckDB {' '.join(sys.argv[1:])} : calcul et écriture des caractéristiques] {time.perf_counter() - debut:.1f} s")
print(con.sql("select count(*) from 'data/caracteristiques-duckdb.parquet'").fetchone()[0], "lignes")
print(f"pic mémoire : {resource.getrusage(resource.RUSAGE_SELF).ru_maxrss / 2**20:.2f} Gio")
borne python etape7_duckdb.py --leger
borne python etape7_duckdb.py; echo "code de sortie : $?"
[DuckDB --leger : calcul et écriture des caractéristiques] 16.3 s
25060030 lignes
pic mémoire : 4.13 Gio
code de sortie : 137
Sans médiane ni mode, DuckDB calcule les 25 millions de lignes en 16,3 s, contre 39,1 s pour Spark sur 8 cœurs. La version complète, elle, a été tuée par le plafond de 6 Go (code 137), malgré memory_limit = '4GB', et de nouveau avec 8 puis 4 fils d'exécution. Pour 25 millions de groupes, DuckDB garde en mémoire l'état de la médiane et du mode de chaque groupe, et cet état échappe à sa limite. Spark, limité à 3 Go, est allé au bout en 119 s : sa mémoire de calcul est gérée par tranches, et peut déborder sur disque quand elle ne suffit pas.
Le chapitre 36 disait « commencez par une machine et un moteur en colonnes ». Cette étape en montre la limite : sur une requête simple, DuckDB est deux fois plus rapide ; sur une requête qui accumule beaucoup d'état, c'est Spark qui arrive au bout. Écrivez au runbook laquelle des deux vous choisiriez pour la table de l'étape 4, et pourquoi.
Accès aux interfaces
| Composant | Adresse | Quand |
|---|---|---|
| Interface de la session Spark | http://localhost:4040 | pendant qu'un script tourne ; avec --pause, jusqu'à ce que vous appuyiez sur Entrée. Si le port est pris (une autre session ouverte), Spark prend 4041, puis 4042 |
| Serveur d'historique de Spark | http://localhost:18080 | à tout moment, une fois lancé : il relit le journal d'événements de toutes les sessions passées |
Le serveur d'historique est livré avec PySpark :
export SPARK_HOME=$(python -c "import pyspark, os; print(os.path.dirname(pyspark.__file__))")
SPARK_HISTORY_OPTS="-Dspark.history.fs.logDirectory=file://$HOME/tp30/evenements" \
  $SPARK_HOME/sbin/start-history-server.sh
curl -s localhost:18080/api/v1/applications | python -c "import sys, json; print(len(json.load(sys.stdin)), 'applications')"
Lors de la préparation, il listait les 26 sessions du TP, dont tp30-jointure-sans-aqe (36 s) avec son étape déséquilibrée, consultable longtemps après la fin du script. C'est l'outil pour comparer deux exécutions à tête reposée, ou pour comprendre après coup un job de nuit qui a échoué.
Nettoyage
Rien ne tourne en permanence, sauf le serveur d'historique. Pour l'arrêter :
$SPARK_HOME/sbin/stop-history-server.sh
Les données occupent environ 21 Go. Pour supprimer ce qui ne sert qu'à ce TP, en gardant le journal Parquet de référence et la table de caractéristiques :
cd ~/tp30
rm -rf data/journal-par-jour-melange.parquet data/journal-par-*.parquet data/journal.parquet   # 9,7 Go
rm -rf spark-tmp/*                         # fichiers temporaires d'une session interrompue
Pour tout supprimer (irréversible, mais tout se régénère en quelques minutes à partir du kit) :
rm -rf ~/tp30
ls -d /tmp/blockmgr-* /tmp/spark-* 2>/dev/null   # restes d'anciennes sessions dans /tmp ? à supprimer aussi
Point de contrôle final
- Le journal CSV fait 10 092 568 727 octets (ou votre version réduite, notée au runbook)
- Vous savez lire dans l'interface de Spark les jobs, les étapes, la durée des tâches et les lignes lues par un scan
- Le Parquet a des horodatages INT64 avec statistiques, et la requête d'un mois lit moins de 6 millions de lignes
- Le tableau des trois écritures partitionnées par jour est au runbook
- La table de caractéristiques existe, et vous savez ce que coûtent la médiane et le mode
- Vous avez vu la tâche de l'utilisateur 42 dans l'onglet Stages, et vous savez l'éviter
- Les 100 millions de prédictions donnent 0,9289 d'accord par les deux méthodes
- Le runbook dit quand vous choisiriez DuckDB, et quand Spark
Banque de pannes du TP 30 (réservé enseignant : ne lisez pas si vous jouez le jeu)
Colonne « Origine » : vécue signifie rencontrée lors de la validation du TP ; prévisible signifie déduite de l'architecture ou de la documentation.
| Symptôme | Cause | Remède | Origine |
|---|---|---|---|
L'éditeur de code et d'autres applications plantent pendant un job Spark ; journalctl -k : Out of memory: Killed process ... (java) | Mémoire épuisée ; /tmp en tmpfs rempli par les fichiers de shuffle de Spark | spark.local.dir sur disque ; plafond par systemd-run --user --scope -p MemoryMax=6G ; moins de cœurs | vécue |
df -h /tmp montre des gigaoctets occupés, /tmp/blockmgr-* | Fichiers de shuffle orphelins de sessions tuées | Les supprimer quand aucune JVM ne tourne (pgrep java) | vécue |
java.lang.OutOfMemoryError: Java heap space pendant un partitionBy | Trop de tâches simultanées, chacune avec ses écrivains Parquet | TP30_COEURS=8 (ou 4), ou plus de mémoire | vécue |
AssertionError sur SparkContext._active_spark_context au démarrage du script | Expression F.col(...) construite avant la création de la session | Construire les expressions après session() | vécue |
ModuleNotFoundError: No module named 'pyarrow' dans un Python worker | Environnement non activé : Spark lance le python3 du système | source .venv/bin/activate, ou PYSPARK_PYTHON | vécue |
| La requête d'un mois lit 100 millions de lignes | Horodatages INT96, sans statistiques min/max | spark.sql.parquet.outputTimestampType=TIMESTAMP_MICROS | vécue |
| Un pivot lit le fichier deux fois | pivot("action") sans liste de valeurs | Donner la liste | vécue |
| 109 201 fichiers de 27 Kio, relecture quinze fois plus lente | partitionBy après un mélange des données | repartition(colonne) avant l'écriture | vécue |
DuckDB tué (137) malgré memory_limit | Agrégats mode et quantile sur 25 millions de groupes | Version sans ces agrégats, ou Spark | vécue |
| Colonne Input de l'onglet Stages à quelques centaines de Kio pour un Parquet | Le lecteur vectorisé ne remonte pas toutes ses lectures (chapitre 36, §5.1) | Lire number of output rows du scan dans l'onglet SQL | vécue (chapitre 36) |
Java gateway process exited before sending its port number | Java absent ou trop ancien | Installer Java 17 ou 21 | prévisible |
| L'interface n'est pas sur 4040 | Une autre session tient le port | 4041, 4042... ; la ligne session ... : interface sur donne l'adresse | prévisible |
No space left on device pendant une écriture | Disque plein : 21 Go de données plus les fichiers temporaires | Supprimer les variantes partitionnées ; journal de 30 millions de lignes | prévisible |
Panne à injecter en temps limité : retirer spark.local.dir de commun.py sur une machine où /tmp est un tmpfs, lancer l'étape 4, et faire suivre df -h /tmp et free -h pendant l'exécution. Faire expliquer pourquoi la mémoire libre baisse alors que la JVM est plafonnée à 3 Go.
Pour aller plus loin (bonus)
- Saler la clé. Reprenez la jointure
sans-aqeen ajoutant au journal un sel aléatoire de 0 à 9 pour l'utilisateur 42 seulement, et en dupliquant dix fois sa ligne dans la table des utilisateurs. Mesurez la tâche la plus longue. - Delta Lake. Installez
delta-spark, écrivez la table de caractéristiques au format Delta, supprimez un utilisateur (DELETE), puis relisez la version précédente (versionAsOf). Combien de fichiers ont été réécrits pour une seule suppression ? - Le coût du CSV. Chronométrez la lecture du CSV avec
TP30_COEURS=1, puis 2, 4, 8 et 16. Tracez le temps en fonction du nombre de cœurs : à partir de quand le disque devient-il la limite ? - Le DAG. Écrivez une tâche Airflow (chapitre 32) qui lance l'étape 4 chaque lundi avec
SparkSubmitOperator, sur les seuls événements de la semaine écoulée. Quelle partition de l'étape 3 choisissez-vous en entrée ?
Questions de compréhension (à préparer pour le TD et l'examen)
- Pourquoi
inferSchema=Truedouble-t-il le temps de lecture d'un CSV ? Citez une autre opération de ce TP qui a le même défaut. - Expliquez pourquoi le même filtre sur l'horodatage lit 100 millions de lignes dans un fichier et 5,7 millions dans l'autre, alors que les deux ont le même contenu.
- D'où viennent les 109 201 fichiers de l'écriture mélangée ? Donnez le calcul, et la correction.
- Pourquoi la médiane et le mode coûtent-ils beaucoup plus cher qu'une moyenne dans un regroupement distribué ?
- L'exécution adaptative a masqué le déséquilibre de la jointure. Est-ce une bonne chose ? Qu'est-ce qu'elle n'a pas corrigé ?
- La prédiction sur les titres distincts est huit fois plus rapide. Dans quels cas cette astuce devient-elle fausse ?
- Pourquoi un
/tmpen mémoire est-il dangereux pour Spark, alors qu'il accélère la plupart des programmes ?