La boucle de dérive complète, avec réentraînement automatique
Ce que vous allez construire
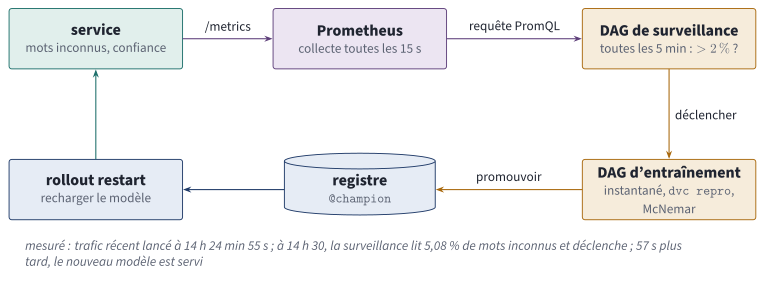
La boucle de ce TP, et sa chronologie mesurée lors de la préparation. Personne n'a tapé de commande entre la dérive et le redéploiement.
PDF vectorielC'est le dernier niveau de l'échelle du chapitre 29 : le déclencheur de l'entraînement n'est plus le calendrier, mais la dérive observée. Gardez en tête ce que le chapitre 35 a aussi montré : ce signal ne voit pas la dérive de concept. La boucle que vous construisez ici ne dispense pas d'étiquettes ; elle réagit vite à ce qui se voit sans elles.
Étape 0 : remettre la chaîne en route (15 min)
L'ordre de démarrage compte :
podman start gitea mlflow-db mlflow-minio mlflow-serveur listify-control-plane
until curl -sf http://localhost:3300/api/healthz >/dev/null; do sleep 2; done   # Gitea d'abord
podman start act-runner                                                           # le runner ensuite
podman logs --tail 1 act-runner                  # ... declare successfully, ou NewParallelExecutor
Lors de la préparation, les deux conteneurs avaient été démarrés ensemble. Le runner, prêt avant Gitea, a échoué à s'annoncer (fail to invoke Declare ... unexpected EOF) et s'est arrêté ; la CI poussée ensuite est restée « en file » pendant dix minutes, sans autre message. Un conteneur qui dépend d'un autre ne démarre pas en même temps que lui : on attend que le premier réponde.
Étape 1 : le service publie ses signaux (1 h)
1.1 Les métriques
Ajoutez à service/service.py les quatre métriques du chapitre 35, calculées à chaque prédiction. Voici les ajouts : les imports, les métriques, le vocabulaire gardé en mémoire au chargement, une fonction qui compte les mots, et la route /metrics.
from fastapi import FastAPI, HTTPException, Response
from prometheus_client import (CONTENT_TYPE_LATEST, REGISTRY, CollectorRegistry, Counter, Histogram,
                               generate_latest, multiprocess)

# ---------- Signaux de dérive (chapitre 35, TP 29) ----------
MOTS = Counter("listify_modele_mots_total", "Mots des titres reçus")
MOTS_INCONNUS = Counter("listify_modele_mots_inconnus_total", "Mots absents du vocabulaire du modèle")
CONFIANCE = Histogram("listify_modele_confiance", "Probabilité de la catégorie proposée",
                      buckets=(0.5, 0.6, 0.7, 0.8, 0.9, 0.95, 1.0))
PREDICTIONS = Counter("listify_modele_predictions_total", "Catégories proposées", ["categorie"])

# dans cycle_de_vie, après le chargement du modèle :
    vectoriseur = modele.named_steps["tfidf"].named_transformers_["titre"]
    etat["vocabulaire"] = vectoriseur.vocabulary_
    etat["analyse"] = vectoriseur.build_analyzer()


def observer_mots(titres):
    mots = [m for t in titres for m in etat["analyse"](t) if " " not in m]    # unigrammes seulement
    MOTS.inc(len(mots))
    MOTS_INCONNUS.inc(sum(m not in etat["vocabulaire"] for m in mots))


@app.get("/metrics")
def metrics():
    if "PROMETHEUS_MULTIPROC_DIR" in os.environ:          # sous Gunicorn : agréger les fichiers des workers
        registre = CollectorRegistry()
        multiprocess.MultiProcessCollector(registre)
    else:
        registre = REGISTRY
    return Response(generate_latest(registre), media_type=CONTENT_TYPE_LATEST)

# dans suggestion(), avant le return :
    observer_mots([tache.titre])
    CONFIANCE.observe(float(probas[meilleure]))
    PREDICTIONS.labels(categorie).inc()
On compte les mots avec l'analyseur du modèle lui-même (build_analyzer) : il découpe et met en minuscules exactement comme à l'entraînement. Compter avec un découpage maison, c'est mesurer autre chose que ce que le modèle voit, le décalage du chapitre 27.
1.2 Plusieurs workers, un seul jeu de compteurs
Le service tourne avec deux workers Gunicorn, donc deux processus qui comptent chacun de leur côté. C'est le piège du TP 21 : sans précaution, /metrics ne montrerait que les compteurs du worker qui répond. On reprend la solution du TP 21, avec un fichier de configuration :
"""Configuration de Gunicorn : 2 workers, métriques Prometheus partagées (comme au TP 21)."""
import os
import shutil

from prometheus_client import multiprocess

bind = "0.0.0.0:8000"
workers = 2
worker_class = "uvicorn.workers.UvicornWorker"
timeout = 60

METRICS_DIR = os.environ.get("PROMETHEUS_MULTIPROC_DIR")


def on_starting(server):
    # le répertoire doit exister et être vide au démarrage du maître
    if METRICS_DIR:
        shutil.rmtree(METRICS_DIR, ignore_errors=True)
        os.makedirs(METRICS_DIR)


def child_exit(server, worker):
    # un worker meurt : ses métriques « vivantes » ne doivent plus compter
    if METRICS_DIR:
        multiprocess.mark_process_dead(worker.pid)
Dans service/Containerfile, copiez ce fichier, déclarez le répertoire partagé et lancez Gunicorn avec sa configuration :
COPY service.py gunicorn.conf.py ./

# métriques Prometheus partagées entre les workers de Gunicorn (TP 21)
ENV PROMETHEUS_MULTIPROC_DIR=/tmp/prometheus

# ... (inchangé)
CMD ["gunicorn", "--config", "gunicorn.conf.py", "service:app"]
Ajoutez prometheus-client==0.26.0 à service/requirements.txt.
1.3 Vérifier en local, puis livrer
Avant de confier la modification à la CI, qui prend sept minutes, vérifiez en local (environnement virtuel avec les dépendances du service, pile MLflow démarrée) :
cd ~/tp23/listify-ml/service
export MLFLOW_TRACKING_URI=http://localhost:5001 MLFLOW_S3_ENDPOINT_URL=http://localhost:9000 \
       AWS_ACCESS_KEY_ID=minio AWS_SECRET_ACCESS_KEY=minio12345 PROMETHEUS_MULTIPROC_DIR=/tmp/prom-test
gunicorn --config gunicorn.conf.py --bind 127.0.0.1:8095 service:app &
for t in "acheter du pain" "payer le loyer" "voir Kévin" "relancer zorglub"; do
  curl -s -X POST localhost:8095/suggestion -H 'Content-Type: application/json' -d "{\"titre\":\"$t\"}" >/dev/null
done
curl -s localhost:8095/metrics | grep -E "^listify_modele_(mots|confiance_count)"
listify_modele_mots_total 10.0
listify_modele_mots_inconnus_total 1.0
listify_modele_confiance_count 4.0
Dix mots, un inconnu (« zorglub »), quatre prédictions, bien agrégés sur les deux workers. Arrêtez ce test (kill %1), commitez et poussez :
cd ~/tp23/listify-ml
git add service && git commit -m "Service : signaux de dérive exportés pour Prometheus"
git push forge main
1.4 Une seule réplique, et pourquoi
Dans listify-ml-config, passez le service à une réplique :
replicas: 1 # une réplique : Prometheus la collecte par le port publié (TP 29)
Le Prometheus de ce TP interroge le service par le port publié du cluster (30080), donc par le Service Kubernetes, qui répartit les requêtes entre les pods. Avec deux répliques, chaque collecte tomberait sur l'un ou l'autre, et Prometheus verrait un compteur qui saute d'une valeur à l'autre. Avec plusieurs répliques, il faut collecter chaque pod, ce que faisait le ServiceMonitor du TP 21. On simplifie ici pour se concentrer sur la boucle ; le bonus 1 rétablit les deux répliques.
Commitez et poussez listify-ml-config. Quelques minutes plus tard :
curl -s localhost:30080/sante
curl -s localhost:30080/metrics | grep -E "^listify_modele_mots"
{"etat":"ok","service":"576f165","modele":"m-d200a41b44814684b1d5df2727464e33","chargement_s":5.342}
listify_modele_mots_total 0.0
listify_modele_mots_inconnus_total 0.0
Étape 2 : Prometheus (20 min)
Un Prometheus en conteneur, sur le poste, suffit à ce TP :
global:
  scrape_interval: 15s
scrape_configs:
  - job_name: modele-categorie
    static_configs:
      - targets: ["host.containers.internal:30080"]     # le service, par le port publié du cluster
podman run -d --name prometheus-ml -p 9091:9090 \
  -v ~/tp29/prometheus.yml:/etc/prometheus/prometheus.yml:Z,ro docker.io/prom/prometheus:latest
curl -s http://localhost:9091/api/v1/targets | grep -o '"health":"[a-z]*"'      # "health":"up"
Le port 9091, comme au TP 21, parce que 9090 est souvent pris par Cockpit. Ouvrez http://localhost:9091 et essayez la requête que la surveillance utilisera :
sum(increase(listify_modele_mots_inconnus_total[10m])) / sum(increase(listify_modele_mots_total[10m]))
Elle calcule la part de mots inconnus sur les dix dernières minutes. increase sait traiter la remise à zéro d'un compteur, qui se produit à chaque redémarrage du service, donc à chaque changement de modèle.
Étape 3 : le DAG de surveillance (45 min)
Placez ce DAG à côté de celui du TP 26, dans dags/ :
"""DAG de surveillance : déclenche le réentraînement quand trop de mots échappent au modèle."""
import json
import os
import urllib.parse
import urllib.request

import pendulum
from airflow.providers.standard.operators.trigger_dagrun import TriggerDagRunOperator
from airflow.sdk import Variable, dag, task

PROMETHEUS = os.environ.get("PROMETHEUS_URL", "http://localhost:9091")
FENETRE = "10m"
SEUIL = 0.02                         # 2 % de mots inconnus (chapitre 35, §7)
MOTS_MIN = 500                       # en dessous, la mesure est trop bruitée pour décider
REPOS = pendulum.duration(minutes=30)  # pas deux réentraînements en moins de 30 minutes


def prometheus(expression: str) -> float:
    url = f"{PROMETHEUS}/api/v1/query?" + urllib.parse.urlencode({"query": expression})
    resultat = json.load(urllib.request.urlopen(url, timeout=10))["data"]["result"]
    return float(resultat[0]["value"][1]) if resultat else 0.0


@dag(
    dag_id="surveillance_listify",
    schedule="*/5 * * * *",                                  # toutes les cinq minutes
    start_date=pendulum.datetime(2026, 1, 1, tz="Europe/Paris"),
    catchup=False,
    max_active_runs=1,
    tags=["listify", "ml", "surveillance"],
)
def surveillance_listify():
    @task.short_circuit
    def derive_detectee() -> bool:
        mots = prometheus(f"sum(increase(listify_modele_mots_total[{FENETRE}]))")
        inconnus = prometheus(f"sum(increase(listify_modele_mots_inconnus_total[{FENETRE}]))")
        part = inconnus / mots if mots else 0.0
        print(f"{mots:.0f} mots sur {FENETRE}, dont {part:.2%} inconnus du modèle (seuil {SEUIL:.0%})")
        if mots < MOTS_MIN or part < SEUIL:
            return False
        dernier = Variable.get("dernier_reentrainement", default=None)
        if dernier and pendulum.now("UTC") - pendulum.parse(dernier) < REPOS:
            print(f"dérive confirmée, mais un réentraînement a déjà été lancé à {dernier}")
            return False
        Variable.set("dernier_reentrainement", pendulum.now("UTC").isoformat())
        print("dérive confirmée : on déclenche le réentraînement")
        return True

    derive_detectee() >> TriggerDagRunOperator(
        task_id="declencher_reentrainement",
        trigger_dag_id="entrainement_listify",
        logical_date="{{ logical_date }}",                   # l'instantané ira jusqu'à maintenant
    )


surveillance_listify()
Les choix de ce DAG viennent tous du chapitre 35. On exige un volume minimal de mots avant de décider, parce qu'une part calculée sur quelques dizaines de mots n'est que du bruit (exemple 35.1). Une période de repos empêche de relancer un entraînement toutes les cinq minutes : juste après un redéploiement, la fenêtre de dix minutes contient encore le trafic mesuré avec l'ancien modèle, et le signal resterait au-dessus du seuil. La date de repos est gardée dans une variable Airflow, parce qu'une tâche ne partage rien d'une exécution à l'autre. Enfin, @task.short_circuit arrête l'exécution quand la fonction renvoie False : la tâche suivante est ignorée, et rien n'est déclenché.
La date logique transmise au DAG d'entraînement est celle de la surveillance, donc maintenant. Son extraction ({{ ds }}, TP 26) prendra toutes les tâches créées avant aujourd'hui.
source ~/tp26/.venv-airflow/bin/activate && source ~/tp26/env-airflow
airflow standalone                     # dans un terminal à part ; environnement activé (TP 26)
# dans un autre terminal, mêmes variables :
airflow dags reserialize
airflow dags list | grep listify       # entrainement_listify et surveillance_listify
Étape 4 : une situation de départ qui va dériver (20 min)
Pour voir la boucle agir, il faut un champion ancien face à un trafic récent. Videz le registre (comme au TP 26), puis entraînez et déployez un champion sur les données d'avant juillet 2025 :
cd ~/tp23/listify-ml && source .venv/bin/activate        # environnement du projet, comme au TP 26
python -c "from mlflow import MlflowClient; MlflowClient().delete_registered_model('listify-categorie')"
deactivate
source ~/tp26/.venv-airflow/bin/activate && source ~/tp26/env-airflow
airflow dags test entrainement_listify 2025-07-07
curl -s localhost:30080/sante
9928 tâches créées avant le 2025-07-07 -> data/taches.csv
aucun champion : la version 1 le devient (précision 0.9068)
deployment "modele-categorie" successfully rolled out
{"etat":"ok","service":"576f165","modele":"m-40d168c030c2438aa8b6a2988069bef2","chargement_s":5.366}
Étape 5 : provoquer la dérive (45 min)
Activez la surveillance, puis rejouez contre le service des titres récents, créés depuis janvier 2026, comme le ferait l'application. Le script boucle sur ces titres à la cadence demandée :
"""Rejoue contre le service des titres de tâches récents, comme le ferait l'application.

Usage : python rejouer_trafic.py <base.csv> <date de début> [requêtes par seconde]
"""
import csv
import json
import sys
import time
import urllib.request

base, debut = sys.argv[1], sys.argv[2]
cadence = float(sys.argv[3]) if len(sys.argv) > 3 else 10.0
with open(base, newline="") as f:
    titres = [ligne["titre"] for ligne in csv.DictReader(f) if ligne["cree_le"] >= debut]
print(f"{len(titres)} titres créés à partir du {debut}, rejoués à {cadence:.0f} requêtes par seconde")

envoyees, erreurs = 0, 0
while True:                                   # on boucle sur les titres, comme un trafic continu
    for titre in titres:
        corps = json.dumps({"titre": titre}).encode()
        requete = urllib.request.Request("http://localhost:30080/suggestion", corps,
                                         {"Content-Type": "application/json"})
        try:
            urllib.request.urlopen(requete, timeout=5).read()
        except Exception:
            erreurs += 1
        envoyees += 1
        if envoyees % 1000 == 0:
            print(f"{time.strftime('%H:%M:%S')} {envoyees} requêtes, {erreurs} erreurs", flush=True)
        time.sleep(1 / cadence)
airflow dags unpause surveillance_listify
date +%T
python ~/tp29/rejouer_trafic.py ~/tp26/base/taches_completes.csv 2026-01-05 10
Laissez tourner et observez, dans l'interface d'Airflow (vue « Grid » des deux DAG) et dans Prometheus. Voici la chronologie obtenue lors de la préparation :
| Heure | Événement |
|---|---|
| 14:24:55 | Début du trafic récent |
| 14:25:00 | Surveillance : 0 mots sur 10m (Prometheus n'a pas encore collecté) ; rien |
| 14:26:25 | Prometheus, requête à la main : 4,6 % de mots inconnus |
| 14:30:00 | Surveillance : 12105 mots sur 10m, dont 5.08% inconnus du modèle (seuil 2%), puis dérive confirmée : on déclenche le réentraînement |
| 14:30:04 | Entraînement : 24000 tâches créées avant le 2026-09-24 |
| 14:30:43 | Promotion : candidat 87,50 % contre champion 80,37 %, 407 désaccords contre 65, khi deux 246,36 ; PROMU ; redéploiement |
| 14:30:57 | Nouveau modèle servi |
| 14:35:00 | Surveillance : 23672 mots sur 10m, dont 3.36% inconnus, puis dérive confirmée, mais un réentraînement a déjà été lancé à 2026-09-24T12:30:01 (heure UTC) ; rien |
| 14:36:14 | Prometheus, sur cinq minutes : 0,69 % de mots inconnus |
| 14:40:00 | Surveillance : 23633 mots sur 10m, dont 1.46% inconnus du modèle (seuil 2%) ; rien, et cette fois sans l'aide du repos |
| 14:41:09 | Prometheus, sur cinq minutes : 1,37 % |
La boucle complète, du déclenchement au nouveau modèle servi, a pris 57 secondes. Regardez la ligne de 14 h 35 : sur dix minutes, la fenêtre mélange encore le trafic mesuré avec l'ancien modèle et celui du nouveau, et la part reste au-dessus du seuil (3,36 %). Sans la période de repos, la surveillance aurait relancé un entraînement inutile. Sur cinq minutes, qui ne contiennent que le nouveau modèle, le signal oscille entre 0,7 et 1,4 % selon les titres que le script rejoue à ce moment-là ; à 14 h 40, la fenêtre de dix minutes elle-même est redescendue sous le seuil, et la surveillance s'est tue d'elle-même. Le script de trafic, lui, a compté une requête en échec sur 6000 : celle qui est arrivée pendant le remplacement de l'unique réplique. Le délai de détection, lui, dépend de la période de la surveillance et de la fenêtre : ici cinq minutes au plus pour la première lecture utile.
Point de contrôle 5
- Le DAG
entrainement_listifya une exécutionmanual__…déclenchée par la surveillance, avec la décisionPROMU. /santeaffiche un nouvel identifiant de modèle, et le même commit de service qu'avant : seul le modèle a changé.- La part de mots inconnus retombe sous le seuil, et les exécutions suivantes de la surveillance ne déclenchent plus rien.
- Au runbook : votre propre chronologie, sur le modèle du tableau ci-dessus.
Étape 6 : éprouver la boucle (30 min)
Une boucle automatique doit aussi savoir ne pas agir. Vérifiez trois comportements, et notez-les au runbook :
- Le repos. Vous l'avez peut-être déjà vu à la lecture qui suit le redéploiement. Sinon, rejouez aussitôt du trafic encore plus récent, par exemple
2026-03-01: si le signal dépasse de nouveau le seuil dans les trente minutes, la surveillance doit écrireun réentraînement a déjà été lancéet ne rien déclencher. - Le volume minimal. Arrêtez le trafic. Après dix minutes, la surveillance voit moins de 500 mots et ne décide rien, quel que soit le pourcentage.
- Le refus. Relancez le trafic récent après la période de repos : le candidat, entraîné sur les mêmes données, est identique au champion ; McNemar le refuse, et le service n'est pas redéployé. La boucle peut donc s'emballer en réentraînements inutiles, mais pas en redéploiements.
Une dernière réflexion, à écrire : que ferait cette boucle face à la dérive de concept du chapitre 35, §5 ?
Accès aux interfaces
Pendant le TP, les composants exposent les interfaces suivantes :
| Composant | Adresse | Identifiants |
|---|---|---|
| Service de prédiction (documentation OpenAPI) | http://localhost:30080/docs | aucun |
| Métriques du service | http://localhost:30080/metrics | aucun |
| Prometheus | http://localhost:9091 | aucun |
| Airflow | http://localhost:8080 | admin, mot de passe dans ~/tp26/airflow/simple_auth_manager_passwords.json.generated |
| MLflow | http://localhost:5001 | aucun |
| Console MinIO | http://localhost:9001 | minio / minio12345 |
| Gitea | http://localhost:3300 | votre compte etudiant |
| Argo CD | kubectl -n argocd port-forward service/argocd-server 8443:443, puis https://localhost:8443 | admin, mot de passe : kubectl -n argocd get secret argocd-initial-admin-secret -o jsonpath='{.data.password}' | base64 -d |
Nettoyage
Rien n'est détruit automatiquement : gardez l'environnement tant que vous en avez besoin pour le runbook. Pour arrêter sans rien perdre (données et configuration conservées) :
# dans les terminaux concernés : Ctrl+C sur le script de trafic et sur « airflow standalone »
podman stop prometheus-ml act-runner gitea mlflow-serveur mlflow-minio mlflow-db listify-control-plane
Pour reprendre plus tard : l'étape 0, puis podman start prometheus-ml, puis airflow standalone.
Pour supprimer ce qui a été créé dans ce TP seulement (le cluster et la pile restent) :
podman rm -f prometheus-ml
source ~/tp26/.venv-airflow/bin/activate && source ~/tp26/env-airflow
airflow dags pause surveillance_listify
airflow variables delete dernier_reentrainement
Et pour tout supprimer à la fin du semestre (irréversible : cluster, forge, registre, données) :
KIND_EXPERIMENTAL_PROVIDER=podman kind delete cluster --name listify
podman rm -f prometheus-ml act-runner gitea mlflow-serveur mlflow-minio mlflow-db
podman volume rm gitea-data runner-data           # les données de la forge et du runner
podman network rm mlflow-net
rm -rf ~/tp26/airflow                             # la base et les journaux d'Airflow
Point de contrôle final
-
/metricsexpose les quatre métriques, agrégées sur les deux workers - Prometheus collecte le service (
health: up) - Le DAG de surveillance tourne toutes les cinq minutes, et lit la part de mots inconnus
- Une dérive provoquée a été détectée, et a déclenché un entraînement, une promotion et un redéploiement, sans commande manuelle
- Le signal est retombé après le redéploiement, sans nouveau déclenchement
- Les trois comportements de l'étape 6 sont vérifiés
- Runbook à jour, avec votre chronologie
Banque de pannes du TP 29 (réservé enseignant : ne lisez pas si vous jouez le jeu)
Colonne « Origine » : vécue signifie rencontrée lors de la validation du TP ; prévisible signifie déduite de l'architecture ou des TP précédents.
| Symptôme | Cause | Remède | Origine |
|---|---|---|---|
La CI reste « en file » indéfiniment ; journal du runner : fail to invoke Declare ... unexpected EOF | Runner démarré avant que Gitea réponde | Démarrer Gitea, attendre /api/healthz, puis le runner (étape 0) | vécue |
La première surveillance après le lancement du trafic lit 0 mots | Prometheus n'avait pas encore collecté de valeur dans la fenêtre | Normal : la lecture suivante décide | vécue |
/metrics ne montre que la moitié des requêtes, et des valeurs qui sautent | PROMETHEUS_MULTIPROC_DIR absent : chaque worker a ses propres compteurs | Étape 1.2 (TP 21) | prévisible |
| Compteurs qui montent et descendent d'une collecte à l'autre | Deux répliques collectées à travers le Service | Une réplique (étape 1.4), ou collecte par pod | prévisible |
| La lecture suivant le redéploiement dépasse encore le seuil (3,36 %) | La fenêtre de dix minutes contient encore le trafic de l'ancien modèle | Période de repos : sans elle, un entraînement de plus toutes les cinq minutes | vécue |
| Le DAG d'entraînement déclenché reste en file | Il est en pause ; une exécution déclenchée attend aussi | airflow dags unpause entrainement_listify | prévisible (TP 26) |
airflow standalone : FileNotFoundError: 'airflow' | Environnement non activé | TP 26, étape 5 | prévisible (TP 26) |
| L'entraînement déclenché ne prend que des données anciennes | logical_date non transmise : l'exécution n'a pas de date, ou une date fausse | logical_date="{{ logical_date }}" dans le déclencheur | prévisible |
| Une requête en échec pendant le redéploiement | Une seule réplique : le rollout restart la remplace, et le service est brièvement indisponible | Accepté dans ce TP ; en production, deux répliques au moins (bonus 1) | vécue |
Prometheus : cible down, connection refused | Service arrêté, ou port publié du nœud tombé (TP 25) | curl localhost:30080/sante ; podman restart listify-control-plane | prévisible |
Panne à injecter en temps limité : mettre SEUIL = 0.0. Faire prédire ce qui va se passer (un déclenchement à chaque lecture, freiné seulement par le repos), puis faire justifier le seuil de 2 % à partir de la figure 35.1.
Pour aller plus loin (bonus)
- Deux répliques, correctement collectées. Rétablissez
replicas: 2et remplacez le Prometheus en conteneur par celui du TP 21 (kube-prometheus-stack) avec unServiceMonitor: chaque pod est collecté séparément, et la requête somme les deux. - Une alerte pour les humains. Ajoutez une règle Prometheus qui alerte quand la part de mots inconnus dépasse 2 % pendant quinze minutes, et reliez-la à Alertmanager. Pourquoi garder une alerte humaine quand la boucle réagit seule ?
- La confiance comme second signal. Ajoutez à la surveillance une condition sur la confiance moyenne (
rate(listify_modele_confiance_sum[10m]) / rate(listify_modele_confiance_count[10m])). Les deux signaux doivent-ils être réunis par un « et » ou par un « ou » ? Justifiez avec la figure 35.1. - Un budget de réentraînement. Limitez la boucle à trois entraînements déclenchés par semaine, et prévoyez ce qui se passe au-delà.
Questions de compréhension (à préparer pour le TD et l'examen)
- Pourquoi compter les mots avec l'analyseur du modèle plutôt qu'avec un découpage écrit pour l'occasion ?
- À quoi servent le volume minimal et la période de repos ? Décrivez ce qui se passerait sans chacun d'eux.
- La boucle a mis 57 secondes à redéployer, mais la dérive avait commencé cinq minutes plus tôt. D'où vient ce délai, et comment le réduire ? Qu'est-ce que cela coûterait ?
- Pourquoi une seule réplique dans ce TP ? Que faudrait-il changer pour en avoir plusieurs ?
- Cette boucle aurait-elle réagi à la dérive de concept du chapitre 35 ? Que faudrait-il lui ajouter ?
- Une boucle entièrement automatique réentraîne et redéploie sans humain. Quels garde-fous du bloc 2 empêchent qu'elle mette un mauvais modèle en production ?