Servir le modèle avec KServe
Ce que vous allez construire
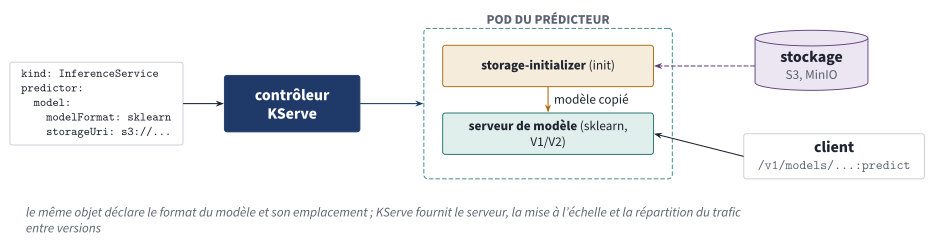
Ce que KServe fabrique à partir d'un InferenceService (figure 34.3). Dans ce TP, le stockage est le MinIO du TP 24, et le client est curl, puis un script de vérification.
Étape 0 : le cluster et la pile (15 min)
On réutilise le cluster du TP 27 : il sait déjà joindre MinIO par host.containers.internal.
podman start mlflow-db mlflow-minio mlflow-serveur listify-control-plane
kubectl config use-context kind-listify
kubectl get nodes                                  # Ready, au bout d'une minute
kubectl -n listify-ml get pods                     # le service du TP 27 tourne toujours
Étape 1 : installer KServe (40 min)
1.1 cert-manager
En mode Standard, KServe ne dépend que de cert-manager, qui fabrique les certificats de ses webhooks. On installe la version que KServe 0.20 épingle dans son propre script :
kubectl apply -f https://github.com/cert-manager/cert-manager/releases/download/v1.17.0/cert-manager.yaml
kubectl -n cert-manager wait --for=condition=Available deploy --all --timeout=300s
Il a été prêt en 18 secondes lors de la préparation.
1.2 KServe, dans le bon ordre
mkdir -p ~/tp28 && cd ~/tp28
for f in kserve-crds.yaml kserve.yaml kserve-cluster-resources.yaml; do
  curl -sLO https://github.com/kserve/kserve/releases/download/v0.20.0/$f
done
ls -lh kserve*.yaml

kubectl apply --server-side -f kserve-crds.yaml          # 1. les définitions de ressources
kubectl create namespace kserve                           # 2. l'espace de noms
kubectl apply --server-side -f kserve.yaml                # 3. les contrôleurs
kubectl -n kserve wait --for=condition=Available deploy --all --timeout=600s
kubectl apply --server-side -f kserve-cluster-resources.yaml   # 4. les environnements de service
L'ordre compte. La première tentative, lors de la préparation, a appliqué kserve.yaml seul, comme dans les versions plus anciennes, et a échoué :
no matches for kind "ClusterStorageContainer" in version "serving.kserve.io/v1alpha1"
ensure CRDs are installed first
Error from server (NotFound): namespaces "kserve" not found
Depuis la version 0.20, les définitions de ressources et l'espace de noms sont livrés à part. --server-side est nécessaire, comme pour Argo CD au TP 20 : kserve.yaml pèse 7 Mo.
kubectl -n kserve get pods
kubectl get clusterservingruntimes
kserve-controller-manager-7d776947c9-7z8pg              2/2   Running   0     46s
kserve-localmodel-controller-manager-79bdb6979d-b7tvs   1/1   Running   0     46s
llmisvc-controller-manager-69559f8dc9-jzmq5             1/1   Running   0     46s

kserve-autogluonserver kserve-huggingfaceserver kserve-huggingfaceserver-multinode kserve-lgbserver
kserve-mlserver kserve-paddleserver kserve-pmmlserver kserve-predictiveserver kserve-sklearnserver
kserve-tensorflow-serving kserve-torchserve kserve-tritonserver kserve-vllmserver kserve-xgbserver
Trois contrôleurs, prêts 54 secondes après le début, et quatorze environnements de service (ClusterServingRuntime) : un serveur prêt à l'emploi par famille de modèles. C'est kserve-sklearnserver qui servira Listify.
Étape 2 : déposer le modèle (20 min)
KServe ne lit ni le registre MLflow ni son alias champion (chapitre 34, §3.3) : il lit un emplacement dans un stockage objet. Le serveur scikit-learn attend un fichier model.joblib. C'est précisément ce que produit dvc repro (TP 23). Déposez-le dans un compartiment dédié de MinIO :
cd ~/tp23/listify-ml
podman run --rm --network mlflow-net -v $PWD/model.joblib:/m/model.joblib:Z,ro --entrypoint sh \
  quay.io/minio/mc:latest -c "mc alias set local http://mlflow-minio:9000 minio minio12345 >/dev/null \
  && mc mb -p local/modeles && mc cp /m/model.joblib local/modeles/listify/v1/model.joblib"
L'emplacement contient un numéro de version (v1) : changer de modèle, ce sera changer d'emplacement, donc modifier une ligne de manifeste, versionnable dans le dépôt de configuration du TP 27.
Étape 3 : l'InferenceService (45 min)
3.1 Les identifiants du stockage
Le conteneur d'initialisation de KServe télécharge le modèle avant le démarrage du serveur. Il trouve l'adresse et les identifiants de MinIO dans un Secret annoté, rattaché à un compte de service :
apiVersion: v1
kind: Secret
metadata:
  name: minio-modeles
  namespace: listify-ml
  annotations:                                   # lues par le conteneur d'initialisation de KServe
    serving.kserve.io/s3-endpoint: host.containers.internal:9000
    serving.kserve.io/s3-usehttps: "0"
    serving.kserve.io/s3-verifyssl: "0"
    serving.kserve.io/s3-region: us-east-1
type: Opaque
stringData:
  AWS_ACCESS_KEY_ID: minio
  AWS_SECRET_ACCESS_KEY: minio12345
---
apiVersion: v1
kind: ServiceAccount
metadata:
  name: lecteur-modeles
  namespace: listify-ml
secrets:
  - name: minio-modeles
3.2 Le service, en quinze lignes
apiVersion: serving.kserve.io/v1beta1
kind: InferenceService
metadata:
  name: listify-categorie
  namespace: listify-ml
  annotations:
    serving.kserve.io/deploymentMode: Standard   # pas de Knative : Deployment, Service et HPA ordinaires
spec:
  predictor:
    serviceAccountName: lecteur-modeles
    minReplicas: 1
    model:
      modelFormat:
        name: sklearn
      storageUri: s3://modeles/listify/v1
L'annotation est indispensable : l'installation par défaut de KServe 0.20 suppose Knative, que nous n'avons pas installé (chapitre 34, §3.2).
kubectl apply -f kserve/
kubectl -n listify-ml get isvc listify-categorie --watch
NAME                URL                                               READY   ...   AGE
listify-categorie   http://listify-categorie-listify-ml.example.com   True    ...   36s
36 secondes entre l'application des manifestes et le premier READY True. Regardez ce que KServe a fabriqué :
kubectl -n listify-ml get deploy,svc,hpa | grep listify-categorie
POD=$(kubectl -n listify-ml get pods -o name | grep predictor)
kubectl -n listify-ml get $POD -o jsonpath='{range .spec.initContainers[*]}{.name} {.image} {.args}{"\n"}{end}'
kubectl -n listify-ml logs $POD -c storage-initializer | tail -2
storage-initializer kserve/storage-initializer:v0.20.0 ["s3://modeles/listify/v1","/mnt/models"]
... Successfully copied s3://modeles/listify/v1 to /mnt/models
... Model downloaded in 0.744203127000219 seconds.
Un Deployment, un Service, un HorizontalPodAutoscaler, un conteneur d'initialisation qui télécharge le modèle, un serveur qui le sert : tout ce qu'on avait écrit à la main au TP 25, sauf l'API elle-même.
Étape 4 : interroger le modèle, et le premier piège (30 min)
kubectl -n listify-ml port-forward svc/listify-categorie-predictor 8090:80 &
curl -s localhost:8090/v1/models/listify-categorie
{"name":"listify-categorie","ready":true}
Le protocole V1, hérité de TensorFlow Serving, attend une liste d'instances :
curl -s -X POST localhost:8090/v1/models/listify-categorie:predict \
  -H 'Content-Type: application/json' -d '{"instances": [["acheter du pain"], ["payer le loyer"]]}'
{"error":"Specifying the columns using strings is only supported for dataframes."}
Le serveur transmet au modèle un tableau NumPy, sans noms de colonnes. Or notre pipeline sélectionne sa colonne par son nom, titre : c'est le ColumnTransformer ajouté au chapitre 31 pour que le modèle accepte un tableau pandas. Le piège du chapitre 31, §5.3, réapparaît de l'autre côté : cette fois, c'est le serveur qui n'envoie pas ce que le modèle attend.
Le protocole V2 (Open Inference Protocol) permet de nommer les entrées, et de demander au serveur d'en faire un tableau pandas :
curl -s -X POST localhost:8090/v2/models/listify-categorie/infer -H 'Content-Type: application/json' \
  -d '{"inputs": [{"name": "titre", "shape": [2], "datatype": "BYTES", "data": ["acheter du pain", "payer le loyer"]}]}'
{"error":"Expected 2D array, got 1D array instead: ..."}
curl -s -X POST localhost:8090/v2/models/listify-categorie/infer -H 'Content-Type: application/json' \
  -d '{"parameters": {"content_type": "pd"},
       "inputs": [{"name": "titre", "shape": [2], "datatype": "BYTES", "data": ["acheter du pain", "payer le loyer"]}]}'
{"model_name":"listify-categorie", ..., "outputs":[{"name":"output-0","shape":[2],"datatype":"BYTES",
 "parameters":null,"data":["courses","administratif"]}]}
C'est le paramètre content_type: pd qui fait construire au serveur un tableau pandas, avec la colonne titre. Notez au runbook les trois requêtes et leurs réponses : elles montrent que le contrat d'entrée d'un modèle (chapitre 33, §1) ne disparaît pas avec KServe. Il se déplace dans le protocole.
Étape 5 : comparer au service du TP 25 (30 min)
Le service écrit à la main tourne toujours. Mesurez les deux dans les mêmes conditions : une redirection de port vers chacun, ce qui revient à interroger un seul pod de chaque côté.
kubectl -n listify-ml port-forward svc/modele-categorie 8091:80 &

hey -n 2000 -c 10 -m POST -T application/json \
  -d '{"parameters": {"content_type": "pd"}, "inputs": [{"name": "titre", "shape": [1], "datatype": "BYTES", "data": ["acheter du pain"]}]}' \
  http://localhost:8090/v2/models/listify-categorie/infer

hey -n 2000 -c 10 -m POST -T application/json -d '{"titre":"acheter du pain"}' \
  http://localhost:8091/suggestion

podman exec listify-control-plane crictl stats | grep -E "kserve-container|service"
Résultats de la préparation :
| KServe (serveur scikit-learn) | Service du TP 25 (FastAPI) | |
|---|---|---|
| Débit | 514 requêtes/s | 215 requêtes/s |
| Médiane | 19 ms | 42 ms |
| 99ᵉ percentile | 27 ms | 129 ms |
| Mémoire du conteneur | 246 Mo | 421 à 446 Mo |
| Image du serveur | 185 Mo (sklearnserver), plus 96 Mo pour l'initialisation | 313 Mo (compressée dans le nœud) |
| Ce que renvoie une prédiction | La catégorie | La catégorie et la confiance, validées par Pydantic |
| Lignes écrites par l'équipe | 15 (l'InferenceService) | Une API, un Containerfile, quatre manifestes |
Ne concluez pas trop vite. Le service du TP 25 fait plus : il calcule la confiance (predict_proba), valide l'entrée avec des bornes, et charge le client MLflow pour lire l'alias champion. La bonne question est : de quoi avez-vous besoin ? Si la confiance et la validation fine sont indispensables, KServe demande un transformateur ou un serveur personnalisé, et une part de l'avantage disparaît.
Étape 6 : changer de version (30 min)
Entraînez un modèle v2 sur toutes les données (par exemple en relançant le DAG du TP 26 à une date récente), déposez son model.joblib sous modeles/listify/v2/, puis changez une seule ligne :
kubectl -n listify-ml patch isvc listify-categorie --type merge \
  -p '{"spec":{"predictor":{"model":{"storageUri":"s3://modeles/listify/v2"}}}}'
kubectl -n listify-ml get pods --watch
Le nouveau pod a servi 19 secondes après le patch, et l'ancien a été retiré : un déploiement progressif ordinaire. Dans une chaîne GitOps, cette ligne vivrait dans listify-ml-config, et la promotion d'un modèle deviendrait un commit, ce qui rend la version servie lisible dans l'historique (question du bonus 4 du TP 27).
Étape 7 : deux vérifications qui comptent (45 min)
7.1 Le canari n'existe pas en mode Standard
Le chapitre 34 mentionne canaryTrafficPercent, qui envoie une part du trafic à la nouvelle version. Essayez-le :
kubectl -n listify-ml patch isvc listify-categorie --type merge \
  -p '{"spec":{"predictor":{"canaryTrafficPercent":20,"model":{"storageUri":"s3://modeles/listify/v1"}}}}'
sleep 30
kubectl -n listify-ml get pods | grep predictor
kubectl -n listify-ml get isvc listify-categorie -o jsonpath='{.status.components.predictor.traffic}'
Lors de la préparation : un seul pod, celui de v1, et aucune répartition du trafic. La commande a été acceptée sans erreur, puis ignorée : 100 % du trafic est parti sur la version qu'on voulait tester sur 20 %. En mode Standard, la répartition canari n'est pas prise en charge ; elle suppose Knative. La leçon dépasse KServe : un champ accepté n'est pas un champ appliqué. On vérifie l'effet, pas la réponse de l'API.
7.2 La version de scikit-learn du serveur
POD=$(kubectl -n listify-ml get pods -o name | grep predictor)
kubectl -n listify-ml exec $POD -c kserve-container -- \
  python -c "import sklearn, sys; print('scikit-learn', sklearn.__version__, '| python', sys.version.split()[0])"
kubectl -n listify-ml logs $POD -c kserve-container | grep InconsistentVersionWarning | head -1
scikit-learn 1.5.2 | python 3.11.15
... InconsistentVersionWarning: Trying to unpickle estimator TfidfVectorizer from version 1.9.1 when using version 1.5.2.
Le serveur de KServe 0.20 embarque scikit-learn 1.5.2 ; notre modèle a été entraîné avec la 1.9.1. C'est le TP 22 à l'échelle d'une plateforme : l'environnement est une entrée du modèle. Le serveur a chargé le modèle et répond, mais cela ne prouve pas que ses réponses soient les bonnes. Vérifiez-le, en comparant les prédictions de KServe à celles du même fichier chargé localement, avec la bonne version :
import json, urllib.request
import joblib, numpy as np, pandas as pd

modele = joblib.load("model.joblib")                         # le fichier déposé en v1, scikit-learn 1.9.1
titres = pd.read_csv("../tp26/base/taches_completes.csv").titre.tolist()[-4800:]
local = modele.predict(pd.DataFrame({"titre": titres}))

distant = []
for i in range(0, len(titres), 400):
    lot = titres[i:i + 400]
    corps = {"parameters": {"content_type": "pd"},
             "inputs": [{"name": "titre", "shape": [len(lot)], "datatype": "BYTES", "data": lot}]}
    requete = urllib.request.Request("http://localhost:8090/v2/models/listify-categorie/infer",
                                     json.dumps(corps).encode(), {"Content-Type": "application/json"})
    distant += json.load(urllib.request.urlopen(requete))["outputs"][0]["data"]

distant = np.array(distant)
print(f"{len(titres)} titres | accord : {(distant == local).mean():.2%} | désaccords : {(distant != local).sum()}")
cd ~/tp23/listify-ml && source .venv/bin/activate && python verifier_kserve.py
4800 titres | accord : 100.00% | désaccords : 0
Cette fois, les prédictions sont identiques. Ce n'est pas une garantie : une autre différence de versions, un autre type de modèle, ou un changement d'algorithme par défaut (le solveur de scikit-learn 0.22, chapitre 28) pourrait donner un autre résultat. Ce script est donc un test, à placer dans la chaîne du TP 27 avant toute promotion vers KServe. L'autre remède est de fournir son propre environnement de service (ServingRuntime) avec les versions de l'entraînement.
Étape 8 : fin de séance (10 min)
kill %1 %2                                 # les redirections de port
kubectl -n listify-ml delete -f kserve/    # ou gardez l'InferenceService pour la suite
podman stop mlflow-serveur mlflow-minio mlflow-db listify-control-plane
Au runbook : l'ordre d'installation de KServe, les trois requêtes de l'étape 4, le tableau de l'étape 5, et les deux vérifications de l'étape 7 avec votre conclusion.
Point de contrôle final
- cert-manager et KServe installés,
kserve-sklearnserverdisponible - Le modèle est dans MinIO, sous un emplacement versionné
- L'
InferenceServiceestREADY True, en mode Standard - Une prédiction réussit en protocole V2 avec
content_type: pd, et l'échec en V1 est expliqué - Le tableau comparatif avec le service du TP 25 est rempli, et discuté
- Un changement de version a été chronométré
- Le canari ignoré et la version de scikit-learn sont vérifiés et commentés
- Runbook à jour
Banque de pannes du TP 28 (réservé enseignant : ne lisez pas si vous jouez le jeu)
Colonne « Origine » : vécue signifie rencontrée lors de la validation du TP ; prévisible signifie déduite de l'outil ou des TP précédents.
| Symptôme | Cause | Remède | Origine |
|---|---|---|---|
no matches for kind "ClusterStorageContainer", namespaces "kserve" not found | kserve.yaml appliqué seul : depuis 0.20, CRD et espace de noms sont à part | Étape 1.2, dans l'ordre | vécue |
V1 : Specifying the columns using strings is only supported for dataframes. | Le serveur envoie un tableau NumPy ; le modèle sélectionne sa colonne par nom | Protocole V2 avec content_type: pd | vécue |
V2 : Expected 2D array, got 1D array instead | Paramètre content_type: pd absent | L'ajouter | vécue |
curl localhost:8090 échoue après un changement de version | La redirection de port visait l'ancien pod | Relancer port-forward | vécue |
canaryTrafficPercent accepté, mais 100 % du trafic sur la nouvelle version | Canari non pris en charge en mode Standard | Knative, ou deux InferenceService et une répartition en amont | vécue |
InconsistentVersionWarning dans les journaux du serveur | scikit-learn 1.5.2 dans sklearnserver, 1.9.1 à l'entraînement | Vérifier les prédictions (§7.2), ou ServingRuntime personnalisé | vécue |
InferenceService bloqué, pod sans conteneur principal, erreur dans storage-initializer | Secret non annoté, compte de service absent, ou s3-endpoint en localhost | Étape 3.1 : le point de vue est celui du pod | prévisible |
READY False, message sur Knative | Annotation deploymentMode: Standard oubliée | L'ajouter | prévisible |
FileNotFoundError dans le serveur | Le dossier ne contient pas model.joblib (par exemple le dossier MLflow, avec model.skops) | Déposer le fichier produit par dvc repro | prévisible |
Panne à injecter en temps limité : changer s3-endpoint en localhost:9000 dans le Secret et supprimer le pod. Faire lire le journal de storage-initializer, et rattacher la panne aux points de vue réseau des TP 19, 20 et 25.
Pour aller plus loin (bonus)
- Un transformateur. Écrivez un transformateur KServe (un petit serveur Python) qui reçoit
{"titre": "..."}, construit la requête V2 attendue par le prédicteur, et renvoie la catégorie. Qu'y gagne-t-on pour les clients ? Que coûte le saut réseau supplémentaire (chapitre 30, §6.2) ? - Son propre environnement de service. Déclarez un
ServingRuntimequi utilise une image avec scikit-learn 1.9.1 (par exemple à partir de celle du TP 27), et faites-le utiliser par l'InferenceService. L'avertissement disparaît-il ? - GitOps. Placez
kserve/10-inferenceservice.yamldanslistify-ml-config, et faites écrire par le DAG du TP 26 le nouvel emplacement du modèle promu. La promotion devient un commit. - Le mode Knative. Sur un cluster jetable, installez KServe en mode Knative, activez
minReplicas: 0, et mesurez le démarrage à froid après cinq minutes d'inactivité. Reliez à l'exemple 34.3.
Questions de compréhension (à préparer pour le TD et l'examen)
- Qu'est-ce que KServe a fabriqué à partir de l'
InferenceService? Comparez, ligne à ligne, avec ce que vous aviez écrit au TP 25. - Pourquoi la requête V1 a-t-elle échoué, et pourquoi la requête V2 avec
content_type: pda-t-elle réussi ? Où se trouve le contrat d'entrée du modèle dans chacune des deux architectures ? - Le service KServe est plus rapide et plus léger que celui du TP 25. Citez deux raisons qui ne tiennent pas à KServe lui-même.
canaryTrafficPercenta été accepté puis ignoré. Quelle règle générale en tirez-vous pour vérifier une configuration ?- Le serveur utilise scikit-learn 1.5.2 pour un modèle entraîné avec la 1.9.1. Les prédictions ont été identiques sur 4 800 titres. Pourquoi cela ne suffit-il pas à conclure, et que mettriez-vous en place ?
- KServe lit un emplacement, pas l'alias
championdu registre. Est-ce un défaut ou un avantage ? Argumentez du point de vue de GitOps.