Le DAG d'entraînement complet, avec promotion conditionnelle
Ce que vous allez construire
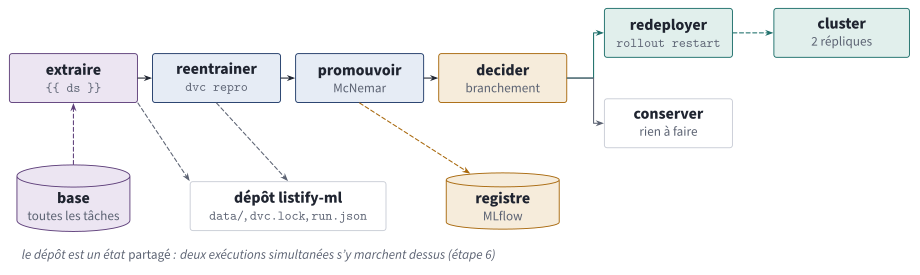
Le DAG du TP. Airflow décide quand tourner et quoi faire du résultat ; DVC continue de garantir ce qui est calculé ; le registre tranche ; Kubernetes sert.
PDF vectorielUn choix de conception mérite d'être posé dès le départ : le DAG n'appelle pas les étapes prepare, train et evaluate une à une. Il lance dvc repro, qui connaît déjà ces étapes, leurs dépendances et ce qu'il faut recalculer. Décrire deux fois le même graphe, une fois dans dvc.yaml et une fois dans Airflow, serait la dette de la « jungle de pipelines » du chapitre 27. Chaque outil garde son rôle.
Étape 0 : préparer le poste (30 min)
0.1 Les services des TP précédents
podman start mlflow-db mlflow-minio mlflow-serveur listify-control-plane
kubectl --context kind-listify -n listify-ml get pods          # les deux répliques du TP 25
Si l'API du cluster refuse la connexion juste après le démarrage, patientez une minute : le nœud redémarre ses composants.
0.2 Airflow, dans son propre environnement
Airflow a beaucoup de dépendances, qui ne doivent pas se mêler à celles du projet (scikit-learn, pandas, MLflow). Il vit donc dans son environnement virtuel ; les tâches, elles, activeront celui du projet.
mkdir -p ~/tp26 && cd ~/tp26
python3 -m venv .venv-airflow
source .venv-airflow/bin/activate
pip install "apache-airflow==3.3.2"
airflow version                     # 3.3.2
Créez ~/tp26/env-airflow, à charger dans chaque terminal qui parle à Airflow :
export AIRFLOW_HOME=~/tp26/airflow
export AIRFLOW__CORE__DAGS_FOLDER=~/tp23/listify-ml/dags
export AIRFLOW__CORE__LOAD_EXAMPLES=False
Le dossier des DAG est dans le dépôt listify-ml : le DAG est du code, versionné avec le reste.
source ~/tp26/env-airflow
airflow db migrate
0.3 La base de Listify, simulée
En production, l'extraction interrogerait la base PostgreSQL de Listify. Ici, on la simule par un fichier qui contient toutes les tâches, avec leur date de création : l'export v2 du kit, qui couvre de janvier 2025 à mars 2026.
mkdir -p ~/tp26/base
cp ~/tp22/tp22-kit/data/export_taches_final_v2.csv ~/tp26/base/taches_completes.csv
wc -l ~/tp26/base/taches_completes.csv          # 24001 lignes, en-tête compris
Étape 1 : une extraction idempotente (30 min)
Chaque exécution doit figer un instantané : les tâches créées avant sa date logique (chapitre 32, §5.1). Créez src/extraire.py dans le dépôt :
"""Étape extraire : fige un instantané des tâches créées avant une date.

Idempotente : relancée pour la même date, elle réécrit exactement le même fichier.

Usage : python src/extraire.py <base.csv> <instantané.csv> <date de fin, AAAA-MM-JJ, exclue>
"""
import csv
import sys

if __name__ == "__main__":
    source, destination, date_fin = sys.argv[1], sys.argv[2], sys.argv[3]
    with open(source, newline="") as f:
        lecteur = csv.reader(f)
        entete = next(lecteur)
        lignes = [l for l in lecteur if l[0] < date_fin]      # dates ISO : l'ordre du texte est celui du temps
    with open(destination, "w", newline="") as f:
        ecrivain = csv.writer(f)
        ecrivain.writerow(entete)
        ecrivain.writerows(lignes)
    print(f"{len(lignes)} tâches créées avant le {date_fin} -> {destination}")
Vérifiez l'idempotence : deux extractions pour la même date doivent produire deux fichiers identiques.
cd ~/tp23/listify-ml && source .venv/bin/activate
python src/extraire.py ~/tp26/base/taches_completes.csv /tmp/a.csv 2025-07-07
python src/extraire.py ~/tp26/base/taches_completes.csv /tmp/b.csv 2025-07-07
cmp /tmp/a.csv /tmp/b.csv && echo "idempotente"
9928 tâches créées avant le 2025-07-07 -> /tmp/a.csv
9928 tâches créées avant le 2025-07-07 -> /tmp/b.csv
idempotente
La comparaison de dates sous forme de texte fonctionne parce que le format ISO (2025-07-07) range les dates dans l'ordre alphabétique et chronologique. Avec des dates au format 07/07/2025, ce raccourci serait faux, et c'est pourquoi prepare.py refuse les dates illisibles (TP 23).
Étape 2 : une décision lisible par l'orchestrateur (15 min)
Le script promouvoir.py du TP 24 affiche sa décision ; l'orchestrateur a besoin de la lire. Ajoutez-lui l'écriture d'un petit fichier decision.json, aux deux endroits où la décision est prise :
import json          # en tête du fichier, avec les autres imports

    # dans la branche « aucun champion », juste avant sys.exit(0) :
        with open("decision.json", "w") as f:
            json.dump({"decision": "promu", "version": version.version, "raison": "premier champion"}, f)

    # tout à la fin, après les étiquettes de la version :
    with open("decision.json", "w") as f:                  # lu par l'orchestrateur (TP 26)
        json.dump({"decision": decision, "version": version.version, "raison": raison}, f)
Ajoutez decision.json au .gitignore : c'est un résultat d'exécution, pas une source.
Étape 3 : le DAG (45 min)
"""DAG hebdomadaire : réentraîner le modèle de Listify, le promouvoir s'il le mérite, le redéployer."""
import json
import os
from pathlib import Path

import pendulum
from airflow.sdk import dag, task

DEPOT = Path(__file__).resolve().parents[1]                  # le DAG vit dans le dépôt listify-ml
BASE = os.environ.get("LISTIFY_BASE", str(Path.home() / "tp26" / "base" / "taches_completes.csv"))
ENV = f"cd {DEPOT} && . .venv/bin/activate && . ./.env-mlflow && export MLFLOW_DISABLE_AGENT_HINT=1"
KUBECTL = "kubectl --context kind-listify -n listify-ml"


@dag(
    dag_id="entrainement_listify",
    schedule="0 3 * * 1",                                    # chaque lundi à 3 h
    start_date=pendulum.datetime(2025, 6, 2, tz="Europe/Paris"),
    catchup=False,
    max_active_runs=1,                                       # jamais deux entraînements en parallèle
    default_args={"retries": 1, "retry_delay": pendulum.duration(minutes=2)},
    tags=["listify", "ml"],
)
def entrainement_listify():
    @task.bash
    def extraire() -> str:
        # les tâches créées AVANT la date logique : rejouer une date redonne le même fichier
        return f"{ENV} && python src/extraire.py {BASE} data/taches.csv " "{{ ds }}"

    @task.bash
    def reentrainer() -> str:
        return f"{ENV} && dvc repro && dvc push"

    @task.bash
    def promouvoir() -> str:
        return f"{ENV} && python src/promouvoir.py run.json data/prepared/test.csv"

    @task.branch
    def decider() -> str:
        decision = json.loads((DEPOT / "decision.json").read_text())
        print(f"décision : {decision}")
        return "redeployer" if decision["decision"] == "promu" else "conserver"

    @task.bash
    def redeployer() -> str:
        return (f"{KUBECTL} rollout restart deploy/modele-categorie && "
                f"{KUBECTL} rollout status deploy/modele-categorie --timeout=300s")

    @task
    def conserver():
        print("le champion reste en place ; aucun redéploiement")

    extraire() >> reentrainer() >> promouvoir() >> decider() >> [redeployer(), conserver()]


entrainement_listify()
Cinq points à comprendre avant d'exécuter.
{{ ds }}est la date logique, au formatAAAA-MM-JJ. Avec le calendrier par défaut d'Airflow 3, c'est le lundi du déclenchement (chapitre 32, §5.1). L'extraction prend les tâches créées avant ce lundi.@task.bashrenvoie une commande, qu'Airflow exécute dans un shell. Chaque commande commence parENV: se placer dans le dépôt, activer son environnement, charger les variables MLflow. Le code métier reste dans le dépôt, testé ; le DAG ne fait que l'enchaîner.- La décision passe par un fichier, pas par XCom : elle est produite par un script qui ignore tout d'Airflow, et un fichier est la frontière la plus simple entre les deux mondes.
@task.branchrenvoie le nom de la tâche à exécuter ; l'autre est marquée ignorée.max_active_runs=1empêche deux exécutions planifiées de tourner ensemble. L'étape 6 montrera ce qu'il ne couvre pas.
Vérifiez qu'Airflow lit le DAG sans erreur :
source ~/tp26/.venv-airflow/bin/activate && source ~/tp26/env-airflow
airflow dags reserialize
airflow dags list | grep entrainement
Étape 4 : mettre au point avec airflow dags test (1 h)
Pour que l'histoire se déroule dans l'ordre chronologique, repartez d'un registre vide (dans le dépôt, environnement du projet activé) :
python -c "from mlflow import MlflowClient; MlflowClient().delete_registered_model('listify-categorie')"
airflow dags test exécute le DAG entier, en une fois, pour la date logique qu'on lui donne, sans ordonnanceur. C'est l'outil de mise au point.
4.1 Premier lundi : le premier champion
airflow dags test entrainement_listify 2025-07-07
Extraits du journal, obtenus lors de la préparation (83 secondes au total) :
9928 tâches créées avant le 2025-07-07 -> data/taches.csv
run b159bdad : 7942 tâches, 899 termes
{"precision": 0.9068, ..., "n_test": 1986}
candidat enregistré : version 1 (run b159bdad)
aucun champion : la version 1 le devient (précision 0.9068)
décision : {'decision': 'promu', 'version': '1', 'raison': 'premier champion'}
deployment "modele-categorie" successfully rolled out
DagRun Finished: ..., logical_date=2025-07-07 00:00:00+00:00, ..., state=success
Vérifiez que le service sert bien le nouveau modèle : curl -s localhost:30080/sante affiche un nouvel identifiant.
4.2 Une semaine plus tard
airflow dags test entrainement_listify 2025-07-14
10310 tâches créées avant le 2025-07-14 -> data/taches.csv
candidat enregistré : version 2 (run b1b2f9de)
champion (v1) : 1852 bonnes réponses (0.8982)
candidat (v2) : 1862 bonnes réponses (0.9030)
désaccords : candidat seul juste 10, champion seul juste 0 ; khi deux 8.10, p 0.00
PROMU : la version 2 devient championne
deployment "modele-categorie" successfully rolled out
Une seule semaine de données a suffi à rendre le candidat significativement meilleur : sur les 10 tâches de test où les deux modèles divergent, le candidat a raison 10 fois. Relisez le chapitre 30 : ce sont très probablement des titres personnels apparus dans la semaine (nouveaux collègues, nouveaux dossiers), que l'ancien champion n'avait jamais vus.
4.3 Six mois plus tard
airflow dags test entrainement_listify 2026-01-05
19855 tâches créées avant le 2026-01-05 -> data/taches.csv
candidat enregistré : version 3 (run e3662243)
champion (v2) : 3158 bonnes réponses (0.7953)
candidat (v3) : 3457 bonnes réponses (0.8706)
désaccords : candidat seul juste 369, champion seul juste 70 ; khi deux 202.29, p 0.00
PROMU : la version 3 devient championne
deployment "modele-categorie" successfully rolled out
Sur les tâches récentes, le champion de juillet ne fait plus que 79,5 %. Laissé en place six mois, il aurait perdu 7,5 points sans qu'aucune alerte ne se déclenche : c'est la dérive silencieuse du chapitre 27, et la raison d'être de l'entraînement continu.
4.4 Rejouer la même date
airflow dags test entrainement_listify 2026-01-05
19855 tâches créées avant le 2026-01-05 -> data/taches.csv
candidat enregistré : version 4 (run e3662243)
champion (v3) : 3457 bonnes réponses (0.8706)
candidat (v4) : 3457 bonnes réponses (0.8706)
désaccords : candidat seul juste 0, champion seul juste 0 ; khi deux 0.00, p 1.00
REFUSÉ : le champion reste la version 3 (la version 4 devient challenger)
le champion reste en place ; aucun redéploiement
Cette exécution a pris 22 secondes au lieu de 83 : l'extraction a produit un fichier identique, et dvc repro n'a rien recalculé (le run MLflow est le même, e3662243). L'extraction et le pipeline sont idempotents.
Le registre, lui, ne l'est pas : il a enregistré une version 4, copie exacte de la version 3. À vous : modifiez promouvoir.py pour qu'il ne réenregistre pas un modèle déjà présent dans le registre (indice : comparez model_id à la source des versions existantes). Relancez la même date et vérifiez que le registre ne bouge plus.
Point de contrôle 4
- Les quatre exécutions sont vertes ; les deux branches (
redeployer,conserver) ont été empruntées. - Au registre : version 3 championne, version 4 challenger (ou pas de version 4 si vous avez rendu la promotion idempotente).
curl localhost:30080/santeaffiche l'identifiant du modèle de la version 3.- Au runbook : le tableau des quatre exécutions (date, instantané, précisions, désaccords, décision, durée).
Étape 5 : l'ordonnanceur réel (30 min)
dags test n'est qu'un outil de mise au point. En fonctionnement, ce sont l'ordonnanceur, le serveur d'API et le processeur de DAG qui travaillent (chapitre 32, §3). airflow standalone les lance tous, pour un poste de développement :
source ~/tp26/.venv-airflow/bin/activate        # indispensable, voir l'encadré
source ~/tp26/env-airflow
airflow standalone
Quand le journal affiche Airflow is ready, ouvrez http://localhost:8080. Le mot de passe du compte admin est affiché dans le journal et enregistré dans ~/tp26/airflow/simple_auth_manager_passwords.json.generated.
Activez le DAG, dans l'interface ou en ligne de commande :
airflow dags unpause entrainement_listify
Avec catchup=False, l'ordonnanceur crée immédiatement une exécution : celle du dernier lundi écoulé (scheduled__…). Suivez-la dans la vue « Grid » de l'interface.
Étape 6 : rattraper le passé, et ses deux pièges (45 min)
On veut rejouer trois lundis d'août 2025 :
airflow backfill create --dag-id entrainement_listify --from-date 2025-08-04 --to-date 2025-08-19
Lors de la préparation, cette commande a été lancée pendant que tournait l'exécution planifiée de l'étape 5. Voici ce qui s'est passé, et c'est l'objet de cette étape.
6.1 Premier piège : un état partagé
scheduled__2026-09-21T01:00:00+00:00   success
backfill__2025-08-18T01:00:00+00:00    failed
backfill__2025-08-11T01:00:00+00:00    failed
backfill__2025-08-04T01:00:00+00:00    success
Le journal de la tâche reentrainer en échec :
'data/taches.csv.dvc' didn't change, skipping
ERROR: failed to reproduce 'prepare': '.../listify-ml/data/prepared' is busy, it is being blocked by:
  (PID 80316): .../listify-ml/.venv/bin/dvc repro
L'exécution planifiée et le rattrapage tournaient en même temps, dans le même dossier. max_active_runs=1 limite les exécutions planifiées entre elles ; le rattrapage a son propre compteur. DVC a refusé de travailler sur un dossier déjà verrouillé, ce qui est une chance : la ligne didn't change, skipping montre qu'avant d'échouer, l'extraction de l'une avait déjà été écrasée par celle de l'autre. Sans verrou, un modèle aurait été entraîné sur les données d'un autre jour, en silence.
Réparer. Les tâches en échec se rejouent en les « nettoyant » :
airflow tasks clear entrainement_listify --start-date 2025-08-10 --end-date 2025-08-19 --only-failed --yes
Elles repartent, l'une après l'autre, et réussissent. Attention : si le DAG est en pause, elles restent en file d'attente, rattrapage compris.
Prévenir. À court terme : ne jamais lancer un rattrapage quand une exécution planifiée est en cours ou imminente, et le lancer avec --max-active-runs 1. Sur le fond : une exécution ne devrait jamais partager son espace de travail avec une autre. Chaque exécution devrait travailler dans son clone du dépôt, ou mieux dans son conteneur. C'est ce que font la chaîne du TP 27 et les pipelines du chapitre 34.
6.2 Second piège : juger le passé avec un modèle du futur
Relisez les décisions des trois exécutions d'août, une fois réparées :
backfill 2025-08-04 : champion (v1) 0.9389 | candidat (v2) 0.8756 | REFUSÉ
backfill 2025-08-11 : champion (v1) 0.9413 | candidat (v3) 0.8754 | REFUSÉ
backfill 2025-08-18 : champion (v1) 0.9444 | candidat (v4) 0.8760 | REFUSÉ
Les candidats d'août sont tous refusés face à un champion à 94 %. Or ce champion est celui de l'exécution planifiée du 21 septembre 2026, passée avant eux : il a été entraîné sur toutes les données, y compris les tâches d'août qui servent de jeu de test aux candidats. Il a vu les réponses de l'examen. Sa précision est contaminée, et la décision est fausse.
La leçon dépasse Airflow : un rattrapage rejoue les calculs, pas le monde. Le registre, lui, est dans l'état d'aujourd'hui. Deux remèdes, à discuter au runbook :
- ne pas exécuter la branche de promotion lors d'un rattrapage historique (on reconstitue des modèles et des métriques, on ne décide rien) ;
- ne comparer que des modèles dont les données d'entraînement s'arrêtent avant le début du jeu de test.
Point de contrôle 6
- Les trois exécutions d'août sont vertes après nettoyage.
- Le runbook explique, avec les journaux, pourquoi deux d'entre elles avaient échoué.
- Le runbook explique pourquoi leurs décisions de promotion ne valent rien, chiffres à l'appui.
Étape 7 : fin de séance (15 min)
cd ~/tp23/listify-ml
git add src/extraire.py src/promouvoir.py dags .gitignore
git commit -m "Entraînement continu : DAG Airflow avec promotion et redéploiement"
Arrêtez airflow standalone (Ctrl+C), puis la pile si vous n'enchaînez pas sur le TP 27 :
podman stop mlflow-serveur mlflow-minio mlflow-db listify-control-plane
Point de contrôle final
- L'extraction est idempotente (
cmpsur deux extractions de la même date) -
promouvoir.pyécritdecision.json - Le DAG est chargé sans erreur d'import
- Quatre exécutions par
dags test: deux promotions avec redéploiement, un refus, et le rejeu d'une date - Le service sert le modèle promu par la dernière promotion
- L'ordonnanceur réel a exécuté le lundi le plus récent
- Le rattrapage d'août est vert, et ses deux pièges sont analysés au runbook
Banque de pannes du TP 26 (réservé enseignant : ne lisez pas si vous jouez le jeu)
Colonne « Origine » : vécue signifie rencontrée lors de la validation du TP ; prévisible signifie déduite de l'architecture.
| Symptôme | Cause | Remède | Origine |
|---|---|---|---|
standalone : FileNotFoundError: ... 'airflow', interface muette, exécutions en file indéfiniment | Environnement virtuel non activé : standalone appelle airflow par le PATH | source ~/tp26/.venv-airflow/bin/activate avant airflow standalone | vécue |
reentrainer échoue : '.../data/prepared' is busy, it is being blocked by: (PID …) dvc repro | Deux exécutions simultanées dans le même dépôt (rattrapage pendant une exécution planifiée) | airflow tasks clear … --only-failed ; ne pas chevaucher ; à terme, un espace de travail par exécution | vécue |
Exécutions « nettoyées » qui restent queued | Le DAG est en pause ; la pause bloque aussi le rattrapage | airflow dags unpause | vécue |
AlreadyRunningBackfill: Another backfill is running for Dag … | Un rattrapage existe déjà (même avec des exécutions en échec) | Nettoyer ses tâches plutôt que d'en créer un second | vécue |
| Tous les candidats d'un rattrapage sont refusés face à un champion à 94 % | Le champion a été entraîné sur des données postérieures, qui contiennent le jeu de test des candidats | §6.2 : pas de promotion pendant un rattrapage, ou comparaison restreinte | vécue |
| Registre qui grossit d'une version à chaque rejeu | promouvoir.py enregistre sans vérifier que le modèle existe déjà | Exercice de l'étape 4.4 | vécue |
| L'extraction ne retient aucune tâche, sans erreur | Tâche recopiée d'un exemple Airflow 2, qui lit data_interval_end : égal à la date logique avec le calendrier par défaut d'Airflow 3 | {{ ds }}, ou CronDataIntervalTimetable explicite (chapitre 32, §5.1) | prévisible |
redeployer échoue : connexion refusée à l'API du cluster | Le nœud kind vient de démarrer, ou sa publication de port est tombée | Attendre ; sinon podman restart listify-control-plane (TP 25) | prévisible |
decider échoue : FileNotFoundError: decision.json | promouvoir.py du TP 24 non modifié | Étape 2 | prévisible |
Panne à injecter en temps limité : remplacer {{ ds }} par {{ data_interval_start | ds }} et demander pourquoi le résultat ne change pas, puis ce qui changerait avec CronDataIntervalTimetable.
Pour aller plus loin (bonus)
- Un espace de travail par exécution. Modifiez le DAG pour que chaque exécution travaille dans un clone temporaire du dépôt (
git worktree add /tmp/listify-{{ run_id }}), supprimé à la fin. Relancez le scénario de l'étape 6 : le verrou DVC disparaît-il ? Que faut-il partager entre les clones (indice : le cache DVC) ? - Pas de décision pendant un rattrapage. Ajoutez une tâche de branchement qui saute
promouvoirquand lerun_idcommence parbackfill__. Rejouez août et comparez. - Une alerte au lieu d'un simple message. Remplacez
conserverpar une tâche qui envoie une alerte à Alertmanager (chapitre 26) quand le candidat est refusé plusieurs semaines de suite. - Déclencher sur les données. Transformez l'extraction en un DAG séparé qui produit un asset Airflow, et faites déclencher l'entraînement par la mise à jour de cet asset plutôt que par l'horloge.
Questions de compréhension (à préparer pour le TD et l'examen)
- Pourquoi le DAG lance-t-il
dvc reproplutôt que d'appeler lui-mêmeprepare,trainetevaluate? Qu'est-ce qui se passerait si l'on ajoutait une étape àdvc.yaml? - Que représente
{{ ds }}pour une exécution planifiée ? Et pour un rattrapage du 11 août ? - Le rejeu du 5 janvier a pris 22 secondes au lieu de 83. Quelles propriétés, et de quels outils, l'expliquent ? Qu'est-ce qui, en revanche, n'est pas idempotent ?
- Une semaine de données a suffi à faire promouvoir un candidat (10 désaccords contre 0). Est-ce plausible ? Qu'est-ce que cela dit de la fréquence de réentraînement à retenir (chapitre 29, §5) ?
- Expliquez à un collègue pourquoi
max_active_runs=1n'a pas empêché deux exécutions de se chevaucher, et proposez une architecture qui rend ce chevauchement inoffensif. - Pourquoi les décisions des rattrapages d'août sont-elles fausses ? Proposez une règle qui empêche ce genre de comparaison.