Servir le modèle promu sur le cluster
Ce que vous allez construire
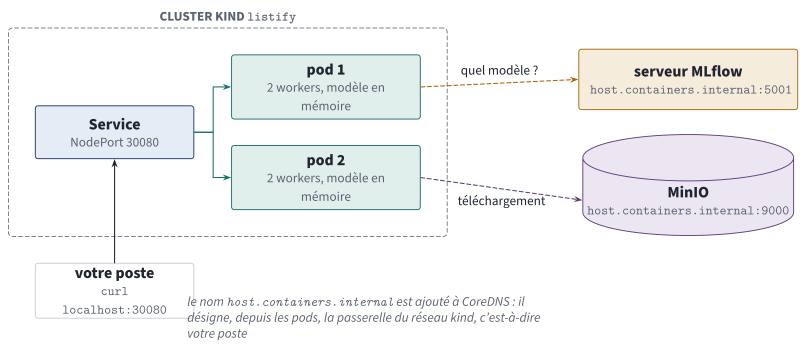
Le service dans le cluster, le registre sur le poste. Les pods ne connaissent aucun chemin de fichier : ils demandent au registre quel modèle servir, puis le téléchargent depuis le stockage objet.
PDF vectorielÉtape 0 : préparer la pile et le cluster (30 min)
0.1 La pile MLflow du TP 24
podman start mlflow-db mlflow-minio mlflow-serveur
curl -s -o /dev/null -w "MLflow %{http_code}\n" "http://localhost:5001/api/2.0/mlflow/experiments/search?max_results=1"
curl -s -o /dev/null -w "MinIO  %{http_code}\n" http://localhost:9000/minio/health/live
Les deux doivent répondre 200. Vérifiez ensuite qu'un champion existe :
cd ~/tp23/listify-ml && source .venv/bin/activate && source .env-mlflow
python -c "
from mlflow import MlflowClient
v = MlflowClient().get_model_version_by_alias('listify-categorie', 'champion')
print('champion : version', v.version, '|', v.source)"
0.2 Le cluster
Le cluster du semestre 2 a peut-être été supprimé depuis. On en recrée un, avec un port publié pour joindre le service depuis le poste :
kind: Cluster
apiVersion: kind.x-k8s.io/v1alpha4
name: listify
nodes:
  - role: control-plane
    extraPortMappings:
      - containerPort: 30080
        hostPort: 30080
        protocol: TCP
KIND_EXPERIMENTAL_PROVIDER=podman kind create cluster --config kind.yaml
kubectl --context kind-listify wait --for=condition=Ready nodes --all --timeout=180s
node/listify-control-plane condition met
Étape 1 : construire l'image du service (45 min)
Créez un dossier service/ dans le dépôt listify-ml. Le code est celui du chapitre 33, à une différence près : l'adresse du registre n'a plus de valeur par défaut, elle doit venir de l'environnement.
"""Service de prédiction de catégorie pour Listify."""
import os
import time
from contextlib import asynccontextmanager

import mlflow
import pandas as pd
from fastapi import FastAPI, HTTPException
from pydantic import BaseModel, Field

MODELE_URI = os.environ.get("MODELE_URI", "models:/listify-categorie@champion")
etat: dict = {}


@asynccontextmanager
async def cycle_de_vie(app: FastAPI):
    debut = time.perf_counter()
    mlflow.set_tracking_uri(os.environ["MLFLOW_TRACKING_URI"])
    etat["modele"] = mlflow.sklearn.load_model(MODELE_URI)          # saveur native : donne predict_proba
    etat["version"] = mlflow.models.get_model_info(MODELE_URI).model_id
    etat["chargement_s"] = round(time.perf_counter() - debut, 3)
    yield
    etat.clear()


app = FastAPI(title="Listify, suggestion de catégorie", lifespan=cycle_de_vie)


class Tache(BaseModel):
    titre: str = Field(min_length=1, max_length=200, examples=["acheter du pain"])


class Suggestion(BaseModel):
    titre: str
    categorie: str
    confiance: float


class Lot(BaseModel):
    titres: list[str] = Field(min_length=1, max_length=256)


@app.get("/sante")
def sante():
    return {"etat": "ok", "modele": etat.get("version"), "chargement_s": etat.get("chargement_s")}


@app.post("/suggestion", response_model=Suggestion)
def suggestion(tache: Tache):
    modele = etat.get("modele")
    if modele is None:
        raise HTTPException(status_code=503, detail="modèle non chargé")
    probas = modele.predict_proba(pd.DataFrame({"titre": [tache.titre]}))[0]
    meilleure = probas.argmax()
    return Suggestion(titre=tache.titre, categorie=modele.classes_[meilleure], confiance=float(probas[meilleure]))


@app.post("/suggestions")
def suggestions(lot: Lot):
    predictions = etat["modele"].predict(pd.DataFrame({"titre": lot.titres}))
    return {"categories": list(predictions)}
fastapi==0.141.1
gunicorn==26.2.0
mlflow==3.16.1
boto3==1.40.0
pandas==3.0.6
scikit-learn==1.9.1
uvicorn[standard]==0.53.0
FROM docker.io/library/python:3.13-slim

ENV PYTHONDONTWRITEBYTECODE=1 PYTHONUNBUFFERED=1
WORKDIR /app

COPY requirements.txt .
RUN pip install --no-cache-dir -r requirements.txt

COPY service.py .

RUN useradd --create-home --uid 10001 service
USER service

EXPOSE 8000
CMD ["gunicorn", "service:app", "-k", "uvicorn.workers.UvicornWorker", \
     "-w", "2", "-b", "0.0.0.0:8000", "--timeout", "60"]
cd service
podman build -t listify-modele:1 -f Containerfile .
podman images | grep listify-modele
localhost/listify-modele 1 946 MB
La construction a demandé 3 min 37 s lors de la préparation, et l'image pèse 946 Mo : les bibliothèques scientifiques, comme au chapitre 33, §7. Notez l'ordre des couches : requirements.txt est copié et installé avant service.py, pour que modifier le code ne reconstruise que la dernière couche.
Étape 2 : charger l'image dans le cluster (15 min)
Le cluster ne connaît pas le dépôt d'images de votre poste. Le plus direct, pour ce TP, est de lui livrer l'image sous forme d'archive :
cd ..
podman save -o listify-modele.tar localhost/listify-modele:1
ls -lh listify-modele.tar
KIND_EXPERIMENTAL_PROVIDER=podman kind load image-archive listify-modele.tar --name listify
L'archive pèse 902 Mo et son chargement a pris 16 secondes. Ajoutez-la au .gitignore : ce n'est pas un fichier à versionner.
Étape 3 : ouvrir la route du cluster vers le registre (30 min)
Les pods doivent joindre MLflow et MinIO, qui tournent sur votre poste. Depuis un pod, localhost désigne le pod : c'est le problème des points de vue réseau des TP 19 et 20. La passerelle du réseau kind, elle, désigne votre poste :
IP=$(podman inspect listify-control-plane --format '{{.NetworkSettings.Networks.kind.Gateway}}')
echo "passerelle du réseau kind : $IP"
passerelle du réseau kind : 10.89.5.1
Plutôt que de coller cette adresse dans les manifestes, donnez-lui le nom que Podman utilise déjà dans ses conteneurs. On ajoute pour cela un bloc hosts au serveur DNS du cluster :
kubectl --context kind-listify -n kube-system get cm coredns -o yaml > coredns.yaml
Insérez ces quatre lignes dans le Corefile, juste avant la ligne prometheus :9153 (avec votre adresse) :
        hosts {
           10.89.5.1 host.containers.internal
           fallthrough
        }
kubectl --context kind-listify apply -f coredns.yaml
kubectl --context kind-listify -n kube-system rollout restart deploy/coredns
kubectl --context kind-listify -n kube-system rollout status deploy/coredns --timeout=120s
Vérifiez depuis un pod jetable :
kubectl --context kind-listify run verif --rm -i --restart=Never --image=docker.io/library/busybox:1.36 -- \
  sh -c "nslookup host.containers.internal | tail -3; wget -qO- --timeout=5 http://host.containers.internal:5001/health"
Name:	host.containers.internal
Address: 10.89.5.1

OK
Point de contrôle 3 : quand le serveur MLflow refuse les requêtes du cluster
Si, plus tard, vos pods échouent avec ce message dans leurs journaux :
MlflowException: API request to endpoint /api/2.0/mlflow/registered-models/alias failed with
error code 403 != 200. Response body: 'Invalid Host header - possible DNS rebinding attack detected'
c'est que le serveur MLflow n'accepte que certains noms dans l'en-tête Host. C'est une protection contre le détournement DNS, active par défaut. Relancez le serveur du TP 24 en déclarant les noms légitimes :
podman rm -f mlflow-serveur
podman run -d --name mlflow-serveur --network mlflow-net -p 5001:5000 \
  -e MLFLOW_S3_ENDPOINT_URL=http://mlflow-minio:9000 \
  -e AWS_ACCESS_KEY_ID=minio -e AWS_SECRET_ACCESS_KEY=minio12345 \
  mlflow-serveur:3.16.1 mlflow server --host 0.0.0.0 --port 5000 \
    --backend-store-uri postgresql://mlflow:mlflow@mlflow-db:5432/mlflow \
    --default-artifact-root s3://mlflow-artefacts/ --no-serve-artifacts \
    --allowed-hosts "localhost:5001,127.0.0.1:5001,host.containers.internal:5001"
C'est la panne qui a coûté le plus de temps lors de la préparation de ce TP : les pods redémarraient en boucle, et le message était enfoui dans une trace de gunicorn.
Étape 4 : écrire les manifestes (45 min)
Créez un dossier k8s/ dans le dépôt.
apiVersion: v1
kind: Namespace
metadata:
  name: listify-ml
apiVersion: v1
kind: ConfigMap
metadata:
  name: modele-config
  namespace: listify-ml
data:
  MLFLOW_TRACKING_URI: "http://host.containers.internal:5001"
  MLFLOW_S3_ENDPOINT_URL: "http://host.containers.internal:9000"
  MODELE_URI: "models:/listify-categorie@champion"
---
apiVersion: v1
kind: Secret
metadata:
  name: modele-stockage
  namespace: listify-ml
type: Opaque
stringData:
  AWS_ACCESS_KEY_ID: minio
  AWS_SECRET_ACCESS_KEY: minio12345
La configuration est séparée de l'image (facteur III des Twelve-Factor Apps, chapitre 24) : la même image sert en développement et en production, seules les valeurs changent. Les identifiants du stockage vont dans un Secret ; en production, il serait chiffré ou tiré d'un gestionnaire de secrets (chapitre 9), jamais commité tel quel.
apiVersion: apps/v1
kind: Deployment
metadata:
  name: modele-categorie
  namespace: listify-ml
  labels: {app: modele-categorie}
spec:
  replicas: 2
  selector:
    matchLabels: {app: modele-categorie}
  template:
    metadata:
      labels: {app: modele-categorie}
    spec:
      securityContext:
        runAsNonRoot: true
        runAsUser: 10001
      containers:
        - name: service
          image: localhost/listify-modele:1
          imagePullPolicy: IfNotPresent
          ports:
            - {name: http, containerPort: 8000}
          envFrom:
            - configMapRef: {name: modele-config}
            - secretRef: {name: modele-stockage}
          readinessProbe:                      # le modèle met quelques secondes à charger
            httpGet: {path: /sante, port: http}
            initialDelaySeconds: 5
            periodSeconds: 3
            failureThreshold: 20
          livenessProbe:                       # plus patiente que le chargement
            httpGet: {path: /sante, port: http}
            initialDelaySeconds: 90
            periodSeconds: 20
          resources:
            requests: {cpu: 200m, memory: 500Mi}
            limits: {cpu: "1", memory: 1Gi}
Trois réglages méritent l'attention, et découlent directement des mesures du chapitre 33.
- La sonde de disponibilité est patiente :
failureThreshold: 20avecperiodSeconds: 3laisse jusqu'à 60 secondes au chargement du modèle. Trop courte, elle ferait tourner en boucle un pod qui allait devenir sain. - La sonde de vivacité l'est encore plus (
initialDelaySeconds: 90). C'est la règle du chapitre 33, §3 : la vivacité doit être plus lente que le démarrage le plus lent. - Les ressources : 500 Mio demandés, 1 Gio en limite, pour un service qui consomme environ 220 Mio par worker. L'étape 8 montre ce qui arrive quand on les fixe trop bas.
apiVersion: v1
kind: Service
metadata:
  name: modele-categorie
  namespace: listify-ml
spec:
  type: NodePort
  selector: {app: modele-categorie}
  ports:
    - {name: http, port: 80, targetPort: http, nodePort: 30080}
Étape 5 : déployer et vérifier (30 min)
kubectl --context kind-listify apply -f k8s/
kubectl --context kind-listify -n listify-ml rollout status deploy/modele-categorie --timeout=240s
kubectl --context kind-listify -n listify-ml get pods
deployment "modele-categorie" successfully rolled out
NAME                                READY   STATUS    RESTARTS   AGE
modele-categorie-6997467f9b-dw27z   1/1     Running   0          2m
modele-categorie-6997467f9b-lddjm   1/1     Running   0          2m
Pendant le déploiement, observez les pods dans un autre terminal (kubectl get pods -w) : ils restent 0/1 Running tout le temps du chargement du modèle, puis passent à 1/1. Interrogez ensuite le service :
curl -s localhost:30080/sante
curl -s -X POST localhost:30080/suggestion -H 'Content-Type: application/json' -d '{"titre":"  Acheter du PAIN "}'
curl -s -X POST localhost:30080/suggestions -H 'Content-Type: application/json' \
     -d '{"titres":["payer le loyer","ranger le garage","réserver le cinéma"]}'
{"etat":"ok","modele":"m-a06fae96df8d48e3ac2b3cd7d7c35ef5","chargement_s":30.093}
{"titre":"  Acheter du PAIN ","categorie":"courses","confiance":0.9967693161966668}
{"categories":["administratif","maison","loisirs"]}
Le champ chargement_s est instructif : 30 secondes au premier démarrage, parce que les deux répliques téléchargeaient le modèle en même temps. Les démarrages suivants ont pris 15,5 secondes. C'est ce chiffre qui justifie la patience des sondes.
Point de contrôle 5
kubectl -n listify-ml get deploymontre2/2prêtes./santerenvoie l'identifiant du modèle journalisé, le même que celui du champion au registre.- Le titre brut (majuscules, espaces) donne la bonne catégorie : le prétraitement voyage dans le modèle (chapitre 31, §5.3).
- Si un pod reste
0/1plus de deux minutes :kubectl -n listify-ml logs <pod>, et remontez la trace jusqu'à la première exception. Les causes fréquentes sont au point de contrôle 3 et dans la banque de pannes.
Étape 6 : mesurer dans le cluster (20 min)
hey -n 2000 -c 20 -m POST -T application/json \
    -d '{"titre":"acheter du pain"}' http://localhost:30080/suggestion
Requests/sec: 400.74
50%  in 0.0293 secs
95%  in 0.0917 secs
99%  in 0.2321 secs
[200] 2000 responses
Comparez au chapitre 33, où le même service, lancé directement sur le poste avec 4 workers, tenait 952 requêtes par seconde. Ici, 2 répliques de 2 workers donnent 401 requêtes par seconde. L'écart s'explique : le trafic traverse en plus le NodePort, le réseau du cluster et le conteneur du nœud, et les quatre workers se partagent les mêmes cœurs. Un déploiement ne se dimensionne pas sur des chiffres mesurés ailleurs : on remesure là où le service tournera.
Notez au runbook le débit obtenu et le 99ᵉ percentile, puis répondez : combien de répliques pour tenir 600 requêtes par seconde en restant sous 65 % d'occupation (chapitre 33, §5) ?
Étape 7 : changer de modèle sans toucher à l'image (30 min)
C'est l'étape qui justifie tout le reste. Le service charge models:/listify-categorie@champion au démarrage. Déplacez l'alias, puis redéployez.
# dans le dépôt, avec l'environnement MLflow chargé
python -c "
from mlflow import MlflowClient
MlflowClient().set_registered_model_alias('listify-categorie', 'champion', '2')
v = MlflowClient().get_model_version_by_alias('listify-categorie', 'champion')
print('champion -> version', v.version, '|', v.source)"
champion -> version 2 | models:/m-704e1ffe9cea4f45af7fcbca72d131a9
curl -s localhost:30080/sante                     # avant : l'ancien modèle
kubectl --context kind-listify -n listify-ml rollout restart deploy/modele-categorie
kubectl --context kind-listify -n listify-ml rollout status deploy/modele-categorie --timeout=300s
curl -s localhost:30080/sante                     # après : le nouveau
{"etat":"ok","modele":"m-a06fae96df8d48e3ac2b3cd7d7c35ef5","chargement_s":15.322}
deployment "modele-categorie" successfully rolled out
{"etat":"ok","modele":"m-704e1ffe9cea4f45af7fcbca72d131a9","chargement_s":15.559}
Aucune image reconstruite, aucun manifeste modifié. Le déploiement progressif du chapitre 24 s'applique tel quel : Kubernetes démarre le nouveau pod, attend qu'il soit prêt (donc que le modèle soit chargé), puis arrête l'ancien. À aucun moment le service n'est indisponible.
Le retour arrière est le même geste dans l'autre sens : remettez l'alias sur la version précédente et relancez le redéploiement. Faites-le, et notez au runbook le temps total que cela prend.
Étape 8 : casser, observer, réparer (30 min)
Le chapitre 33 a mesuré environ 220 Mio par worker. Voyons ce qui arrive quand on l'ignore :
kubectl --context kind-listify -n listify-ml set resources deploy/modele-categorie \
  --requests=memory=200Mi --limits=memory=300Mi
sleep 45
kubectl --context kind-listify -n listify-ml get pods
modele-categorie-65ddb99dff-8ll75   1/1   Running     0             2m54s
modele-categorie-65ddb99dff-bgx9k   1/1   Running     0             2m32s
modele-categorie-85ff4766bb-mbzj6   0/1   OOMKilled   1 (41s ago)   50s
kubectl --context kind-listify -n listify-ml describe pod modele-categorie-85ff4766bb-mbzj6 | grep -E "Reason|Exit Code"
      Reason:       OOMKilled
      Exit Code:    137
Deux enseignements, à noter au runbook.
- Le code 137 veut dire « tué par le noyau », faute de mémoire. Le service n'a pas planté : il a été arrêté parce qu'il dépassait sa limite. Le diagnostic ne se trouve pas dans les journaux de l'application, qui s'arrêtent net, mais dans l'état du pod.
- Les anciennes répliques ont continué à servir. Le déploiement progressif refuse de retirer les pods sains tant que le nouveau n'est pas prêt : la production a survécu à une mauvaise configuration. Vérifiez-le avec
curl localhost:30080/santependant que le nouveau pod tourne en boucle.
Réparez :
kubectl --context kind-listify -n listify-ml set resources deploy/modele-categorie \
  --requests=cpu=200m,memory=500Mi --limits=cpu=1,memory=1Gi
kubectl --context kind-listify -n listify-ml rollout status deploy/modele-categorie --timeout=300s
Étape 9 : fin de séance (15 min)
cd ~/tp23/listify-ml
git add service k8s kind.yaml
git commit -m "Service de prédiction déployé sur le cluster"

podman stop mlflow-serveur mlflow-minio mlflow-db
Gardez le cluster et le déploiement : le TP 26 et le TP 27 les réutilisent. Au runbook : les commandes de déploiement, le débit mesuré, le temps de chargement du modèle, et les trois pannes rencontrées avec leur symptôme.
Point de contrôle final
- L'image du service est construite et chargée dans le cluster
- Les pods résolvent
host.containers.internalet atteignent MLflow et MinIO - Deux répliques sont
1/1, avec sondes et limites -
curl localhost:30080/suggestionrenvoie une catégorie et une confiance - Le débit et les percentiles sont mesurés et notés
- Un changement d'alias suivi d'un redéploiement change le modèle servi, sans reconstruire l'image
- La panne
OOMKilleda été provoquée, diagnostiquée et réparée - Runbook à jour
Banque de pannes du TP 25 (réservé enseignant : ne lisez pas si vous jouez le jeu)
Colonne « Origine » : vécue signifie rencontrée lors de la validation du TP ; prévisible signifie déduite de l'architecture.
| Symptôme | Cause | Remède | Origine |
|---|---|---|---|
Pods en CrashLoopBackOff, trace gunicorn: Worker failed to boot et, plus haut, Invalid Host header - possible DNS rebinding attack detected | MLflow 3 n'accepte que les noms d'hôte déclarés ; les pods l'appellent par host.containers.internal | Relancer le serveur avec --allowed-hosts (point de contrôle 3) | vécue |
Could not connect to the endpoint URL: "http://localhost:9000/..." depuis le poste | Le conteneur MinIO s'est arrêté, ou sa publication de port a disparu après un redémarrage | podman ps, puis podman start mlflow-minio ; vérifier avec ss -tln | vécue |
The connection to the server 127.0.0.1:<port> was refused alors que le nœud kind tourne | La publication de port du nœud est tombée (Podman sans privilèges) | podman restart listify-control-plane, puis attendre que l'API réponde | vécue |
Un pod reste 0/1 Running une trentaine de secondes, sans erreur | Normal pendant le chargement du modèle (15 à 30 s) ; anormal au-delà de deux minutes | Sonde de disponibilité assez patiente (failureThreshold: 20) | vécue |
OOMKilled, code de sortie 137 | Limite mémoire inférieure à ce que consomme le service (environ 220 Mio par worker) | Étape 8 | vécue (provoquée) |
set resources refusé : requests: Invalid value: "500Mi": must be less than or equal to memory limit of 300Mi | On a baissé la limite sans baisser la demande | Modifier les deux ensemble | vécue |
ErrImageNeverPull ou ImagePullBackOff | L'image n'a pas été chargée dans le cluster, ou son nom diffère de celui du manifeste (localhost/listify-modele:1) | Refaire kind load image-archive et vérifier le nom avec podman images | prévisible |
Le service répond 503 modèle non chargé | Le chargement a échoué mais le processus vit encore | Lire les journaux ; vérifier les variables du ConfigMap et du Secret | prévisible |
/sante renvoie encore l'ancien modèle après une promotion | Les répliques n'ont pas redémarré | kubectl rollout restart (étape 7) | prévisible |
Panne à injecter en temps limité : remplacer MLFLOW_TRACKING_URI par http://localhost:5001 dans le ConfigMap. Les pods échouent sur un refus de connexion, et il faut refaire le raisonnement sur les points de vue réseau.
Pour aller plus loin (bonus)
- Une mise à l'échelle automatique. Installez
metrics-server, ajoutez unHorizontalPodAutoscalersur l'utilisation processeur, puis relancez le tir de charge. Combien de temps avant que les nouvelles répliques absorbent le trafic, sachant qu'un démarrage coûte 15 secondes (chapitre 33, §3) ? - Un Ingress plutôt qu'un NodePort. Reprenez l'Ingress du semestre 2 et exposez le service sur un nom, avec TLS.
- Recharger sans redéployer. Ajoutez une route
POST /rechargerprotégée qui relit l'alias. Quels problèmes cela crée-t-il (chapitre 33, §8), et comment les limiter ? - Un déploiement canari. Déployez une seconde version du service pointant sur
@challenger, et routez 10 % du trafic vers elle. Comparez les distributions de catégories prédites.
Questions de compréhension (à préparer pour le TD et l'examen)
- Pourquoi les pods ne peuvent-ils pas joindre MLflow par
localhost:5001? Qu'est-ce quehost.containers.internaldésigne exactement, et qui le leur apprend ? - Qu'est-ce qui distingue la sonde de disponibilité de la sonde de vivacité pour ce service ? Que se passerait-il si la seconde avait un délai initial de 10 secondes ?
- Le service a été mesuré à 952 requêtes par seconde sur le poste et à 401 dans le cluster. Citez trois causes possibles, et dites comment vous les départageriez.
- Expliquez, à quelqu'un qui découvre le registre, pourquoi changer de modèle n'a demandé ni reconstruction d'image ni modification de manifeste.
- Un pod affiche
OOMKilledet le code 137. Où cherchez-vous l'information, et pourquoi les journaux de l'application ne suffisent-ils pas ? - Pendant la panne de l'étape 8, le service a continué à répondre. Quel mécanisme de Kubernetes l'a permis, et à quelle condition sur les sondes fonctionne-t-il ?