Instrumenter l'entraînement avec MLflow
Ce que vous allez construire
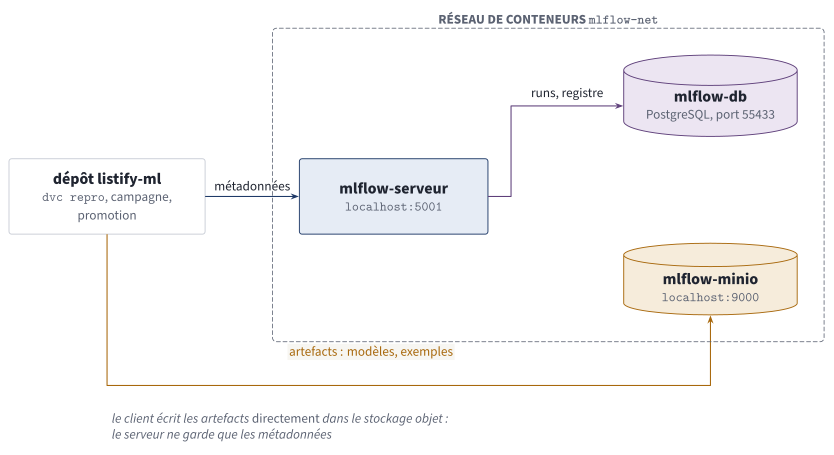
Trois conteneurs et un dépôt. Le serveur ne conserve que les métadonnées ; les modèles vont dans le stockage objet, écrits directement par le client.
PDF vectorielÉtape 0 : reprendre le dépôt du TP 23 (15 min)
cd ~/tp23/listify-ml
source .venv/bin/activate
git status --short          # doit être propre
dvc repro                   # « Data and pipelines are up to date. »
python -m pytest -q         # 7 tests verts
Ajoutez les deux bibliothèques du jour à requirements.txt, puis installez :
mlflow==3.16.1
boto3==1.40.0
pip install -r requirements.txt
boto3 est le client S3 : c'est lui qui déposera les modèles dans MinIO.
Étape 1 : monter la pile MLflow (50 min)
1.1 Le réseau et les deux magasins
podman network create mlflow-net

podman run -d --name mlflow-db --network mlflow-net \
  -e POSTGRES_USER=mlflow -e POSTGRES_PASSWORD=mlflow -e POSTGRES_DB=mlflow \
  -p 55433:5432 docker.io/library/postgres:16-alpine

podman run -d --name mlflow-minio --network mlflow-net \
  -e MINIO_ROOT_USER=minio -e MINIO_ROOT_PASSWORD=minio12345 \
  -p 9000:9000 -p 9001:9001 \
  quay.io/minio/minio:latest server /data --console-address ":9001"
Le port 55433 évite un conflit avec un PostgreSQL déjà installé (TP 19). MinIO expose deux ports : l'API compatible S3 sur 9000, et sa console web sur 9001 (identifiants minio / minio12345).
Créez le compartiment qui recevra les artefacts :
podman run --rm --network mlflow-net --entrypoint sh quay.io/minio/mc:latest -c \
  "mc alias set local http://mlflow-minio:9000 minio minio12345 && mc mb -p local/mlflow-artefacts"
Bucket created successfully `local/mlflow-artefacts`.
1.2 L'image du serveur
L'image officielle de MLflow ne contient pas les pilotes PostgreSQL et S3. On en construit une, en trois lignes :
FROM docker.io/library/python:3.13-slim
RUN pip install --no-cache-dir mlflow==3.16.1 psycopg2-binary==2.9.10 boto3==1.40.0
EXPOSE 5000
podman build -t mlflow-serveur:3.16.1 -f Containerfile.mlflow .
1.3 Le serveur
podman run -d --name mlflow-serveur --network mlflow-net -p 5001:5000 \
  -e MLFLOW_S3_ENDPOINT_URL=http://mlflow-minio:9000 \
  -e AWS_ACCESS_KEY_ID=minio -e AWS_SECRET_ACCESS_KEY=minio12345 \
  mlflow-serveur:3.16.1 mlflow server --host 0.0.0.0 --port 5000 \
    --backend-store-uri postgresql://mlflow:mlflow@mlflow-db:5432/mlflow \
    --default-artifact-root s3://mlflow-artefacts/ --no-serve-artifacts
Trois options méritent une explication.
--backend-store-uridésigne la base des métadonnées : expériences, runs, paramètres, métriques, registre.--default-artifact-rootfixe où atterrissent les artefacts des nouvelles expériences.--no-serve-artifactsdit au serveur de ne pas servir d'intermédiaire : les clients écrivent et lisent le stockage objet directement. Le point de contrôle 1 et la banque de pannes expliquent pourquoi ce choix est nécessaire ici.
Ouvrez http://localhost:5001 : l'interface s'affiche, encore vide. Si le port 5001 est pris, choisissez-en un autre et adaptez la suite.
Point de contrôle 1 : pourquoi --no-serve-artifacts ?
Sans cette option, le serveur joue les intermédiaires : les clients envoient et récupèrent les artefacts à travers lui (mlflow-artifacts:/...). C'est pratique (aucun identifiant S3 côté client), mais MLflow 3 accélère les téléchargements en renvoyant au client des URL pré-signées qui pointent vers le stockage objet. Or ces URL contiennent l'adresse que le serveur connaît, http://mlflow-minio:9000 : un nom qui n'existe que dans le réseau des conteneurs.
Lors de la préparation du TP, le chargement d'un modèle depuis le poste s'est donc traduit par une boucle silencieuse :
INFO mlflow.store.artifact.http_artifact_repo: Retrying 1 failed chunk(s) for model.skops.
Retries remaining: 6
C'est, une fois de plus, le problème des points de vue réseau des TP 19 et 20. Deux solutions : donner au serveur une adresse de MinIO valable partout, ou laisser chaque client parler directement au stockage avec sa propre adresse. C'est la seconde qu'on retient, parce que c'est aussi la configuration de production.
Étape 2 : configurer le client (10 min)
Votre poste doit savoir où est le serveur et comment atteindre le stockage objet. Créez un fichier .env-mlflow à la racine du dépôt (et ajoutez-le à .gitignore : il contient des identifiants) :
export MLFLOW_TRACKING_URI=http://localhost:5001
export MLFLOW_S3_ENDPOINT_URL=http://localhost:9000
export AWS_ACCESS_KEY_ID=minio
export AWS_SECRET_ACCESS_KEY=minio12345
echo ".env-mlflow" >> .gitignore
source .env-mlflow
python -c "import mlflow; print(mlflow.search_experiments())"
Notez l'asymétrie, qui est tout l'enseignement du point de contrôle 1 : le serveur connaît MinIO sous le nom mlflow-minio:9000, votre poste sous localhost:9000. Chacun utilise l'adresse qui a un sens depuis là où il se trouve.
Étape 3 : instrumenter le pipeline (1 h 15)
3.1 Les fonctions de suivi
Créez src/suivi.py. Ce module rassemble ce que l'entraînement doit enregistrer en plus des hyperparamètres : le commit Git et les empreintes DVC des données, c'est-à-dire le lignage du chapitre 28.
"""Petites fonctions de suivi partagées par les étapes du pipeline."""
import json
import subprocess
from pathlib import Path

import yaml


def params(section: str) -> dict:
    with open("params.yaml") as f:
        return yaml.safe_load(f)[section]


def empreintes_donnees() -> dict:
    """Empreintes DVC des données utilisées, lues dans dvc.lock : le lien avec le chapitre 28."""
    if not Path("dvc.lock").exists():
        return {}
    with open("dvc.lock") as f:
        lock = yaml.safe_load(f)
    etiquettes = {}
    for etape, contenu in lock.get("stages", {}).items():
        for dep in contenu.get("deps", []):
            if dep["path"].endswith(".csv") or dep["path"].startswith("data/"):
                etiquettes[f"donnees.{Path(dep['path']).name}"] = dep.get("md5", "")[:12]
    return etiquettes


def commit_git() -> str:
    try:
        sortie = subprocess.run(["git", "rev-parse", "HEAD"], capture_output=True, text=True, check=True)
        propre = subprocess.run(["git", "status", "--porcelain"], capture_output=True, text=True).stdout.strip()
        return sortie.stdout.strip()[:12] + ("" if not propre else " (modifications non commitées)")
    except Exception:
        return "inconnu"


def ecrire_reference(chemin: str, run_id: str, model_id: str) -> None:
    """Trace de l'exécution : le run MLflow et le modèle journalisé qu'elle a produit."""
    Path(chemin).write_text(json.dumps({"run_id": run_id, "model_id": model_id}, indent=2) + "\n")


def lire_reference(chemin: str) -> dict:
    return json.loads(Path(chemin).read_text())
3.2 L'entraînement
"""Étape train : entraîne le pipeline complet et enregistre l'expérience dans MLflow.

Usage : python src/train.py <train.csv> <modèle.joblib> <run.json>
"""
import sys

import joblib
import mlflow
import pandas as pd
from mlflow.models import infer_signature
from sklearn.compose import ColumnTransformer
from sklearn.feature_extraction.text import TfidfVectorizer
from sklearn.linear_model import LogisticRegression
from sklearn.pipeline import Pipeline

import suivi


def construire(p: dict) -> Pipeline:
    return Pipeline([
        ("tfidf", ColumnTransformer([("titre", TfidfVectorizer(min_df=p["min_df"],
                                                               ngram_range=(1, p["ngram_max"])), "titre")])),
        ("clf", LogisticRegression(C=p["C"], max_iter=p["max_iter"])),
    ])


if __name__ == "__main__":
    train_csv, modele_joblib, run_json = sys.argv[1], sys.argv[2], sys.argv[3]
    p = suivi.params("modele")
    train = pd.read_csv(train_csv)

    mlflow.set_experiment("listify-categorie")
    with mlflow.start_run() as run:
        mlflow.log_params(p)
        mlflow.set_tags({"commit": suivi.commit_git(), "etape": "dvc-repro", **suivi.empreintes_donnees()})
        mlflow.log_metric("lignes_entrainement", len(train))

        modele = construire(p).fit(train[["titre"]], train.categorie)
        joblib.dump(modele, modele_joblib)

        exemple = train[["titre"]].head(2)
        info = mlflow.sklearn.log_model(modele, name="modele", input_example=exemple,
                                        signature=infer_signature(exemple, modele.predict(exemple)))
        suivi.ecrire_reference(run_json, run.info.run_id, info.model_id)
        print(f"run {run.info.run_id[:8]} : {len(train)} tâches, "
              f"{len(modele.named_steps['tfidf'].named_transformers_['titre'].vocabulary_)} termes")
Trois changements par rapport au TP 23.
- Un run MLflow encadre l'entraînement. Les paramètres viennent de
params.yaml: la même source de vérité alimente DVC et MLflow, il n'y a pas deux endroits où changer une valeur. - Le modèle est journalisé avec sa signature et un exemple d'entrée (chapitre 31, §5).
- Le pipeline reçoit un tableau à une colonne.
ColumnTransformerremplace l'appel direct au vectoriseur : c'est la correction du piège du chapitre 31, §5.3, où un modèle appelé avec un tableau prédisait la catégorie du mot « titre ».
L'étape écrit enfin run.json, qui relie l'exécution DVC au run MLflow :
{
  "run_id": "ef38a9d7cac84ccb81aadbc738df4159",
  "model_id": "m-a06fae96df8d48e3ac2b3cd7d7c35ef5"
}
3.3 L'évaluation
"""Étape evaluate : mesure le modèle et complète le run MLflow ouvert par l'entraînement.

Usage : python src/evaluate.py <modèle.joblib> <test.csv> <run.json> <metrics.json>
"""
import json
import sys

import joblib
import mlflow
import pandas as pd
from sklearn.metrics import accuracy_score, recall_score

import suivi

if __name__ == "__main__":
    modele_joblib, test_csv, run_json, metrics_json = sys.argv[1:5]
    modele = joblib.load(modele_joblib)
    test = pd.read_csv(test_csv)
    predit = modele.predict(test[["titre"]])
    classes = list(modele.classes_)
    rappels = recall_score(test.categorie, predit, labels=classes, average=None)
    metrics = {
        "precision": round(accuracy_score(test.categorie, predit), 4),
        "rappel_par_categorie": {c: round(r, 4) for c, r in zip(classes, rappels)},
        "n_test": len(test),
    }
    with open(metrics_json, "w") as f:
        json.dump(metrics, f, indent=2, ensure_ascii=False)

    with mlflow.start_run(run_id=suivi.lire_reference(run_json)["run_id"]):          # on rouvre le run de l'entraînement
        mlflow.log_metric("precision_test", metrics["precision"])
        mlflow.log_metrics({f"rappel_{c}": r for c, r in metrics["rappel_par_categorie"].items()})
        mlflow.log_artifact(metrics_json)
    print(json.dumps(metrics, ensure_ascii=False))
L'évaluation rouvre le run de l'entraînement (start_run(run_id=...)) au lieu d'en créer un nouveau : un run, un modèle, toutes ses métriques au même endroit.
3.4 Le pipeline
Modifiez dvc.yaml pour que les deux étapes reçoivent run.json :
stages:
  prepare:
    cmd: python src/prepare.py data/taches.csv data/prepared
    deps:
      - src/prepare.py
      - data/taches.csv
    params:
      - donnees
    outs:
      - data/prepared
  train:
    cmd: python src/train.py data/prepared/train.csv model.joblib run.json
    deps:
      - src/train.py
      - src/suivi.py
      - data/prepared/train.csv
    params:
      - modele
    outs:
      - model.joblib
      - run.json:
          cache: false
  evaluate:
    cmd: python src/evaluate.py model.joblib data/prepared/test.csv run.json metrics.json
    deps:
      - src/evaluate.py
      - src/suivi.py
      - model.joblib
      - run.json
    metrics:
      - metrics.json:
          cache: false
run.json est déclaré cache: false : c'est une trace de quelques octets, que Git peut versionner directement.
3.5 Mettre le test à jour
Le test du TP 23 entraînait le modèle sur une liste de titres ; le pipeline attend désormais un tableau. Remplacez-le par :
def test_pipeline_accepte_un_tableau_de_titres():
    """Le modèle doit accepter ce que le service lui enverra : un tableau à une colonne."""
    titres = ["acheter du pain", "acheter du lait", "payer le loyer", "payer les impôts"] * 3
    etiquettes = ["courses", "courses", "administratif", "administratif"] * 3
    modele = construire({"min_df": 1, "ngram_max": 2, "C": 5, "max_iter": 500}).fit(
        pd.DataFrame({"titre": titres}), etiquettes)
    brut = pd.DataFrame({"titre": ["  Acheter du PAIN ", "PAYER le loyer"]})
    nettoye = pd.DataFrame({"titre": [nettoyer(t) for t in brut.titre]})
    assert len(modele.predict(brut)) == 2                      # deux entrées, deux prédictions
    assert list(modele.predict(brut)) == list(modele.predict(nettoye))
Ce test aurait attrapé le piège du chapitre 31 : il vérifie qu'on obtient deux prédictions pour deux titres.
Enfin, pytest.ini doit connaître le dossier src (les scripts s'importent entre eux) :
[pytest]
pythonpath = . src
testpaths = tests
3.6 Exécuter
source .env-mlflow
dvc repro
python -m pytest -q
Running stage 'train':
> python src/train.py data/prepared/train.csv model.joblib run.json
run ef38a9d7 : 19200 tâches, 1042 termes
Running stage 'evaluate':
> python src/evaluate.py model.joblib data/prepared/test.csv run.json metrics.json
{"precision": 0.875, "rappel_par_categorie": {...}, "n_test": 4800}
7 passed
Point de contrôle 3
Dans l'interface (http://localhost:5001), onglet Model training de l'expérience listify-categorie :
- le run apparaît, avec
C,min_df,ngram_max,max_iteren paramètres ; - ses métriques contiennent
lignes_entrainementetprecision_test; - ses étiquettes contiennent
commitet une empreinte par jeu de données (donnees.taches.csv,donnees.train.csv) ; - ses artefacts contiennent le modèle, sa signature et
metrics.json.
Vérifiez que les artefacts sont bien dans MinIO, et pas sur votre disque :
podman run --rm --network mlflow-net --entrypoint sh quay.io/minio/mc:latest -c \
  "mc alias set local http://mlflow-minio:9000 minio minio12345 >/dev/null && mc du local/mlflow-artefacts"
5.6MiB 47 objects mlflow-artefacts
Si l'étiquette commit se termine par « (modifications non commitées) », c'est normal tant que vous n'avez pas commité : l'information est précieuse, elle dit que ce run n'est pas reproductible à partir du seul commit.
Étape 4 : la campagne de réglage (45 min)
Place à la question que Claire n'avait pas su documenter : quels hyperparamètres ?
"""Campagne de réglage : essaie plusieurs configurations et les enregistre dans MLflow.

Le choix se fait sur un jeu de VALIDATION découpé dans l'entraînement ;
le jeu de test n'est pas touché (chapitre 31, §3).

Usage : python src/campagne.py
"""
import itertools

import mlflow
import pandas as pd

import suivi
from train import construire

GRILLE = {"C": [1, 5, 20], "min_df": [1, 2, 3, 5]}

if __name__ == "__main__":
    tout = pd.read_csv("data/prepared/train.csv")
    coupure = int(len(tout) * 7 / 8)                       # 10 % du total en validation
    train, val = tout.iloc[:coupure], tout.iloc[coupure:]
    base = suivi.params("modele")

    mlflow.set_experiment("listify-categorie")
    for C, min_df in itertools.product(GRILLE["C"], GRILLE["min_df"]):
        p = {**base, "C": C, "min_df": min_df}
        with mlflow.start_run(run_name=f"C{C}-min_df{min_df}"):
            mlflow.log_params(p)
            mlflow.set_tags({"campagne": "reglage-C-min_df", "commit": suivi.commit_git(),
                             **suivi.empreintes_donnees()})
            modele = construire(p).fit(train[["titre"]], train.categorie)
            mlflow.log_metric("precision_val", modele.score(val[["titre"]], val.categorie))

    runs = mlflow.search_runs(filter_string="tags.campagne = 'reglage-C-min_df'",
                              order_by=["metrics.precision_val DESC"])
    colonnes = ["tags.mlflow.runName", "params.C", "params.min_df", "metrics.precision_val"]
    print(runs[colonnes].head(12).to_string(index=False))
    print(f"\nValidation : {len(val)} tâches. Écart-type d'une précision voisine de 0,89 : "
          f"{(0.89 * 0.11 / len(val)) ** 0.5:.4f}")
python src/campagne.py
Résultat obtenu lors de la préparation (12 entraînements en 14 secondes) :
tags.mlflow.runName params.C params.min_df  metrics.precision_val
        C20-min_df2       20             2               0.898333
        C20-min_df1       20             1               0.897917
         C5-min_df2        5             2               0.894167
         C5-min_df1        5             1               0.894167
         C5-min_df3        5             3               0.892500
        C20-min_df5       20             5               0.892083
        C20-min_df3       20             3               0.891667
         C1-min_df1        1             1               0.891667
         C1-min_df2        1             2               0.889167
         C5-min_df5        5             5               0.888750
         C1-min_df3        1             3               0.882917
         C1-min_df5        1             5               0.875000

Validation : 2400 tâches. Écart-type d'une précision voisine de 0,89 : 0.0064
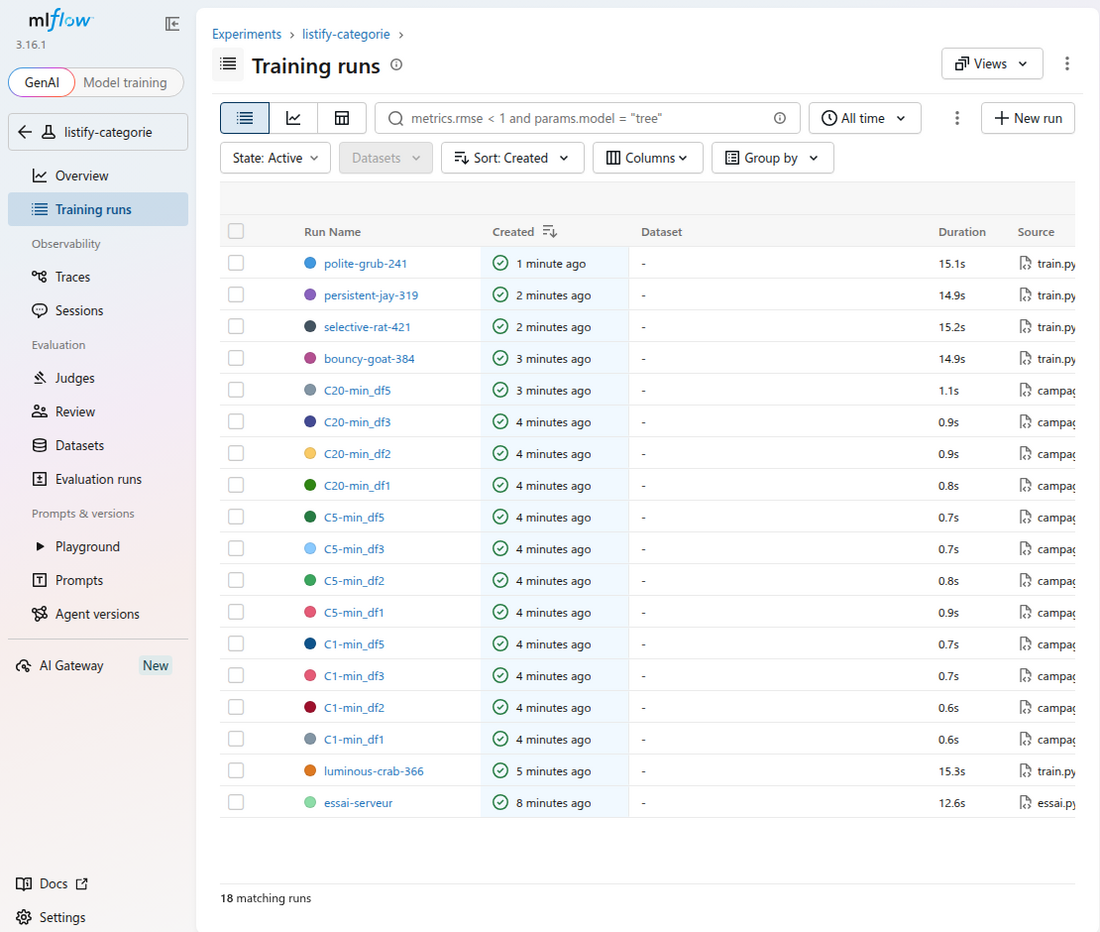
Les runs dans l'interface MLflow. La colonne Source distingue ceux du pipeline (train.py) de ceux de la campagne (campagne.py).
Dans l'interface, sélectionnez plusieurs runs et comparez-les : MLflow trace les métriques en fonction des paramètres. Ajoutez la colonne precision_val et triez.
Étape 5 : enregistrer et promouvoir (1 h)
5.1 La règle de promotion
"""Enregistre le modèle du dernier run du pipeline, puis décide s'il doit devenir champion.

La décision suit la règle du chapitre 29 : le candidat ne remplace le champion que s'il est
significativement meilleur sur LE MÊME jeu de test (test de McNemar, seuil 5 %).

Usage : python src/promouvoir.py run.json data/prepared/test.csv
"""
import math
import sys

import mlflow
import pandas as pd
from mlflow import MlflowClient

import suivi

MODELE = "listify-categorie"
SEUIL_CHI2 = 3.84                      # loi du khi deux, 1 degré de liberté, niveau 5 %


def mcnemar(ok_champion, ok_candidat):
    b = int((~ok_champion & ok_candidat).sum())          # le candidat seul a raison
    c = int((ok_champion & ~ok_candidat).sum())          # le champion seul a raison
    if b + c == 0:
        return b, c, 0.0, 1.0
    chi2 = (abs(b - c) - 1) ** 2 / (b + c)
    p = math.erfc(math.sqrt(chi2 / 2))
    return b, c, chi2, p


if __name__ == "__main__":
    run_json, test_csv = sys.argv[1], sys.argv[2]
    client = MlflowClient()
    reference = suivi.lire_reference(run_json)

    version = mlflow.register_model(f"models:/{reference['model_id']}", MODELE)
    print(f"candidat enregistré : version {version.version} (run {reference['run_id'][:8]})")

    test = pd.read_csv(test_csv)
    candidat = mlflow.sklearn.load_model(f"models:/{MODELE}/{version.version}")
    ok_candidat = candidat.predict(test[["titre"]]) == test.categorie.values

    try:
        champion = client.get_model_version_by_alias(MODELE, "champion")
    except Exception:
        champion = None

    if champion is None:
        client.set_registered_model_alias(MODELE, "champion", version.version)
        print(f"aucun champion : la version {version.version} le devient "
              f"(précision {ok_candidat.mean():.4f})")
        sys.exit(0)

    modele_champion = mlflow.sklearn.load_model(f"models:/{MODELE}/{champion.version}")
    ok_champion = modele_champion.predict(test[["titre"]]) == test.categorie.values
    b, c, chi2, p = mcnemar(ok_champion, ok_candidat)

    print(f"champion (v{champion.version}) : {ok_champion.sum()} bonnes réponses "
          f"({ok_champion.mean():.4f})")
    print(f"candidat (v{version.version}) : {ok_candidat.sum()} bonnes réponses "
          f"({ok_candidat.mean():.4f})")
    print(f"désaccords : candidat seul juste {b}, champion seul juste {c} ; "
          f"khi deux {chi2:.2f}, p {p:.2f}")

    if b > c and chi2 > SEUIL_CHI2:
        client.set_registered_model_alias(MODELE, "champion", version.version)
        decision, raison = "promu", f"mcnemar chi2={chi2:.2f} p={p:.3f}"
        print(f"PROMU : la version {version.version} devient championne")
    else:
        client.set_registered_model_alias(MODELE, "challenger", version.version)
        decision, raison = "refuse", f"mcnemar chi2={chi2:.2f} p={p:.2f}"
        print(f"REFUSÉ : le champion reste la version {champion.version} "
              f"(la version {version.version} devient challenger)")

    client.set_model_version_tag(MODELE, version.version, "decision", decision)
    client.set_model_version_tag(MODELE, version.version, "raison", raison)
Le script fait trois choses : il enregistre le modèle du dernier run du pipeline comme nouvelle version, il le compare au champion sur le même jeu de test, et il écrit sa décision dans les étiquettes de la version. Un futur lecteur saura pourquoi telle version n'a pas été promue.
5.2 Le premier champion
Le registre est vide : la première version est promue sans discussion.
python src/promouvoir.py run.json data/prepared/test.csv
candidat enregistré : version 1 (run ef38a9d7)
aucun champion : la version 1 le devient (précision 0.8750)
5.3 Le candidat de la campagne
Adoptez les paramètres retenus à l'étape 4, relancez le pipeline, puis proposez le résultat au registre :
sed -i 's/^  C: 5$/  C: 20/; s/^  min_df: 3.*/  min_df: 2/' params.yaml
dvc repro
python src/promouvoir.py run.json data/prepared/test.csv
candidat enregistré : version 2 (run c44bd7ff)
champion (v1) : 4200 bonnes réponses (0.8750)
candidat (v2) : 4204 bonnes réponses (0.8758)
désaccords : candidat seul juste 34, champion seul juste 30 ; khi deux 0.14, p 0.71
REFUSÉ : le champion reste la version 1 (la version 2 devient challenger)
Quatre tâches de mieux sur 4 800. Le test de McNemar (chapitre 29, §6) conclut à une valeur p de 0,71 : rien ne prouve que le candidat soit meilleur. Le script refuse la promotion, laisse le champion en place, et étiquette la version 2 avec la raison du refus.
C'est le résultat le plus important du TP : l'outil vous empêche de changer de modèle pour du bruit. Sans lui, la décision aurait été prise sur « 87,58 % contre 87,50 % », c'est-à-dire sur rien.
Point de contrôle 5
Dans l'interface, section Models, modèle listify-categorie :
- la version 1 porte l'alias
champion, la version 2 l'aliaschallenger; - la version 2 porte les étiquettes
decision = refuseetraison = mcnemar chi2=0.14 p=0.71; - chaque version renvoie au run qui l'a produite.
À vous : trouvez une configuration qui soit promue. Indice : ce n'est pas en changeant C d'un cran. Que faudrait-il pour que quatre tâches d'écart deviennent significatives ? Reprenez la formule du §5.1 et répondez au runbook.
Étape 6 : le lignage, de la production aux données (20 min)
Le champion est désigné par un alias. Vérifiez qu'à partir de ce seul alias, vous pouvez tout retrouver, depuis n'importe quel dossier :
cd /tmp
source ~/tp23/listify-ml/.env-mlflow
python - <<'EOF'
import mlflow, pandas as pd
from mlflow import MlflowClient

version = MlflowClient().get_model_version_by_alias("listify-categorie", "champion")
run = MlflowClient().get_run(version.run_id)
print("version", version.version, "| source", version.source)
print("paramètres", run.data.params)
print("lignage", {k: v for k, v in run.data.tags.items() if k.startswith(("commit", "donnees."))})

modele = mlflow.sklearn.load_model("models:/listify-categorie@champion")
print(modele.predict(pd.DataFrame({"titre": ["  Acheter du PAIN ", "voir Mme Durand"]})))
EOF
version 1 | source models:/m-a06fae96df8d48e3ac2b3cd7d7c35ef5
paramètres {'min_df': '3', 'ngram_max': '2', 'C': '5', 'max_iter': '500'}
lignage {'commit': '7c46418ffe88', 'donnees.taches.csv': 'f212445137a0', 'donnees.train.csv': '35dbbe9a7000'}
['courses' 'courses']
Le chargement a pris 4,8 secondes (téléchargement depuis MinIO compris). Comparez au TP 22 : la même question, « de quoi est fait le modèle en production ? », y avait demandé une demi-journée d'enquête.
Étape 7 : fin de séance (15 min)
Commitez le travail, puis arrêtez la pile (les données restent dans les volumes) :
cd ~/tp23/listify-ml
git add -A && git commit -m "Suivi MLflow : pipeline instrumenté, campagne, promotion"
dvc push

podman stop mlflow-serveur mlflow-minio mlflow-db          # en fin de séance
podman start mlflow-db mlflow-minio mlflow-serveur         # à la séance suivante
Complétez le runbook : les commandes de la pile, le contenu de .env-mlflow (sans les mots de passe), le classement de la campagne, la décision de promotion et sa justification.
Point de contrôle final
- Les trois conteneurs tournent, l'interface répond sur
localhost:5001 -
dvc reprocrée un run MLflow complet (paramètres, métriques, étiquettes de lignage, modèle signé) - Les artefacts sont dans MinIO, pas dans un dossier local
- Les 12 runs de la campagne sont comparables dans l'interface
- Le registre contient au moins deux versions, un
championet unchallenger - La version refusée porte l'étiquette de sa raison
- Depuis
/tmp, l'aliaschampiondonne le modèle, ses paramètres, son commit et l'empreinte de ses données - Runbook à jour
Banque de pannes du TP 24 (réservé enseignant : ne lisez pas si vous jouez le jeu)
Colonne « Origine » : vécue signifie rencontrée lors de la validation du TP ; prévisible signifie déduite de l'outil et évitée par construction dans l'énoncé.
| Symptôme | Cause | Remède | Origine |
|---|---|---|---|
Le chargement d'un modèle boucle sur Retrying 1 failed chunk(s) ... Retries remaining: 6 | Serveur en mode mandataire : les URL pré-signées pointent sur mlflow-minio:9000, inconnu hors du réseau de conteneurs | --no-serve-artifacts et --default-artifact-root s3://… ; endpoint S3 côté client (étapes 1.3 et 2) | vécue |
too many 503 error responses sur une expérience existante | L'emplacement des artefacts est figé à la création de l'expérience : une expérience créée en mode mandataire garde mlflow-artifacts:/ | Repartir d'une base propre, ou créer une nouvelle expérience | vécue |
ModuleNotFoundError: No module named 'src' au lancement de src/train.py | python src/train.py met src/ en tête du chemin, pas la racine | import suivi dans les scripts, et pythonpath = . src dans pytest.ini | vécue |
Un test du TP 23 échoue après le passage au ColumnTransformer | Le test entraînait sur une liste de titres ; le pipeline attend un tableau | Test réécrit à l'étape 3.5 | vécue |
WARNING ... Run with id ... has no artifacts at artifact path 'modele', registering model based on models:/m-... | Dans MLflow 3, log_model(name=...) crée un modèle journalisé distinct des artefacts du run ; runs:/<id>/modele n'existe pas | Enregistrer par models:/{model_id}, d'où le model_id dans run.json | vécue |
| Le serveur ne démarre pas : port 5000 occupé | Un autre service écoute déjà (fréquent sous Linux) | Publier sur 5001, comme dans l'énoncé | vécue |
NoCredentialsError ou EndpointConnectionError côté client | .env-mlflow non chargé dans ce terminal | source .env-mlflow | prévisible |
| Les runs de la campagne écrasent la précision de test | Confusion entre precision_val et precision_test | La campagne ne mesure que la validation ; le test reste pour la promotion | prévisible |
La promotion échoue : RESOURCE_DOES_NOT_EXIST sur le modèle enregistré | Premier passage : le modèle n'existe pas encore au registre | mlflow.register_model le crée ; l'absence de champion est gérée par le script | prévisible |
Panne à injecter en temps limité : arrêter mlflow-minio et relancer dvc repro. Les métadonnées partent, les artefacts non : le run apparaît dans l'interface mais sans modèle. Faire diagnostiquer la séparation métadonnées / artefacts.
Pour aller plus loin (bonus)
- Le seuil de significativité. Modifiez
promouvoir.pypour exiger aussi une non-régression par catégorie (aucun rappel en baisse de plus de 2 points), comme au chapitre 29, §6. Le candidat de l'étape 5.3 passerait-il ce second filtre ? - Journaliser une matrice de confusion. Ajoutez à
evaluate.pyun graphique de la matrice de confusion enregistré comme artefact (mlflow.log_figure). Quelles confusions dominent ? - Comparer sur plusieurs découpages. La campagne choisit sur une seule validation. Faites-la tourner sur trois découpages temporels différents et comparez les moyennes plutôt que les valeurs isolées (chapitre 28, §4).
- Protéger le serveur. Lisez la documentation de l'authentification de base de MLflow. Que faudrait-il pour que seuls deux comptes puissent déplacer l'alias
champion?
Questions de compréhension (à préparer pour le TD et l'examen)
- Pourquoi séparer la base de métadonnées du stockage d'artefacts ? Qu'est-ce qui se passerait si l'on mettait les modèles dans PostgreSQL ?
- Le serveur connaît MinIO sous
mlflow-minio:9000, votre poste souslocalhost:9000. Expliquez pourquoi, et ce qui casse si l'on donne la première adresse au poste. - Qu'est-ce que
run.jsonapporte, alors que DVC sait déjà refaire le modèle et que MLflow sait déjà le retrouver ? - La campagne a classé douze configurations. Pourquoi le classement des quatre premières ne veut-il rien dire, et que faudrait-il pour le rendre significatif ?
- Le candidat de l'étape 5.3 gagne 4 tâches sur 4 800. Expliquez la décision du script à quelqu'un qui vous répond « mais c'est quand même mieux ».
- Un modèle sert en production depuis trois mois. À partir du seul alias
champion, listez les commandes qui vous permettent de retrouver le jeu de données exact qui l'a produit.