Servir un modèle : API, validation, charge et conteneur
1. Du fichier de modèle au service
Le TP 23 a laissé un modèle utilisable en ligne de commande (predire.py), et le chapitre 31 l'a enregistré au registre sous l'alias champion. Il manque la dernière marche : un service que l'application interroge, celui que le chapitre 30 a décrit comme le mode « à la demande » et le « modèle-service ».
Servir un modèle, ce n'est pas « charger un joblib dans une route ». C'est publier un contrat et le tenir :
| Le contrat dit | Concrètement |
|---|---|
| Ce que le client envoie | Un titre de tâche, texte non vide, au plus 200 caractères |
| Ce qu'il reçoit | Une catégorie parmi cinq, et une confiance entre 0 et 1 |
| Ce qui se passe en cas d'entrée invalide | Une erreur 400/422 explicite, pas une erreur 500 ni une prédiction absurde |
| Ce qui se passe en cas de panne du modèle | Une erreur 503, que le client sait traiter en se passant de suggestion |
| Combien de temps cela prend | Un objectif de latence, tenu à un percentile donné |
| Quel modèle a répondu | Une version, exposée et journalisée |
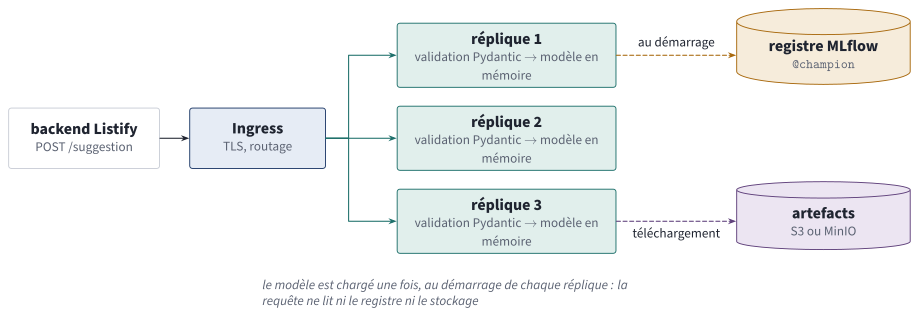
L'architecture visée. Le registre et le stockage d'artefacts sont sollicités au démarrage, jamais pendant une requête : c'est ce qui rend le service rapide et insensible à une panne du registre.
PDF vectoriel2. L'API avec FastAPI
FastAPI convient bien à ce rôle : il valide les entrées et les sorties à partir de types Python (via Pydantic), produit une documentation OpenAPI sans effort, et s'exécute sur un serveur asynchrone (Uvicorn). Voici le service complet, celui qui a servi à toutes les mesures de ce chapitre :
"""Service de prédiction de catégorie pour Listify."""
import os
import time
from contextlib import asynccontextmanager

import mlflow
import pandas as pd
from fastapi import FastAPI, HTTPException
from pydantic import BaseModel, Field

MODELE_URI = os.environ.get("MODELE_URI", "models:/listify-categorie@champion")
etat: dict = {}


@asynccontextmanager
async def cycle_de_vie(app: FastAPI):
    debut = time.perf_counter()
    mlflow.set_tracking_uri(os.environ.get("MLFLOW_TRACKING_URI", "sqlite:///mlflow.db"))
    etat["modele"] = mlflow.sklearn.load_model(MODELE_URI)          # saveur native : donne predict_proba
    etat["version"] = mlflow.models.get_model_info(MODELE_URI).model_id
    etat["chargement_s"] = round(time.perf_counter() - debut, 3)
    yield
    etat.clear()


app = FastAPI(title="Listify, suggestion de catégorie", lifespan=cycle_de_vie)


class Tache(BaseModel):
    titre: str = Field(min_length=1, max_length=200, examples=["acheter du pain"])


class Suggestion(BaseModel):
    titre: str
    categorie: str
    confiance: float


class Lot(BaseModel):
    titres: list[str] = Field(min_length=1, max_length=256)


@app.get("/sante")
def sante():
    return {"etat": "ok", "modele": etat.get("version"), "chargement_s": etat.get("chargement_s")}


@app.post("/suggestion", response_model=Suggestion)
def suggestion(tache: Tache):
    modele = etat.get("modele")
    if modele is None:
        raise HTTPException(status_code=503, detail="modèle non chargé")
    probas = modele.predict_proba(pd.DataFrame({"titre": [tache.titre]}))[0]
    meilleure = probas.argmax()
    return Suggestion(titre=tache.titre, categorie=modele.classes_[meilleure], confiance=float(probas[meilleure]))


@app.post("/suggestions")
def suggestions(lot: Lot):
    predictions = etat["modele"].predict(pd.DataFrame({"titre": lot.titres}))
    return {"categories": list(predictions)}
Quatre décisions de conception méritent d'être discutées.
Le modèle est chargé dans le cycle de vie, pas au premier appel ni à chaque requête (§3).
L'entrée et la sortie sont des classes, pas des dictionnaires. Tache décrit ce qui est accepté ; Suggestion, déclarée en response_model, garantit que le service ne renverra jamais autre chose que ces trois champs. Le contrat du §1 devient du code exécutable, et la documentation OpenAPI en découle.
Les limites sont explicites : un titre d'au plus 200 caractères, un lot d'au plus 256 titres. Ces bornes ne sont pas cosmétiques : elles protègent le service (§5).
On charge la saveur native plutôt que pyfunc. Le chapitre 31 a présenté pyfunc comme l'interface universelle ; elle n'expose que predict. Ici, le service veut aussi la confiance, donc predict_proba, qui n'existe que sur l'objet scikit-learn. On paie cette richesse par un couplage : le service sait qu'il sert un modèle scikit-learn. C'est un arbitrage assumé, à documenter.
3. Charger le modèle une fois
Le chargement du modèle depuis le registre a été mesuré à 5,0 s sur le poste de préparation (téléchargement des artefacts, désérialisation, initialisation de scikit-learn). Deux conséquences.
Charger par requête est exclu. Une latence de 5 s par prédiction, contre quelques millisecondes une fois chargé : le rapport est de mille. C'est l'erreur la plus fréquente des premiers services de ML.
Une réplique n'est pas prête dès qu'elle démarre. Il faut donc distinguer deux sondes, comme au semestre 2 :
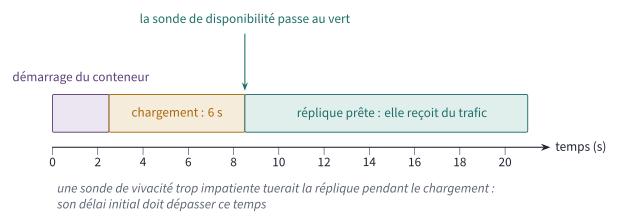
Démarrage réel d'une réplique conteneurisée, mesuré au §7 : le service répond 8,5 s après le lancement du conteneur, dont 6 s de chargement du modèle.
PDF vectoriel- La sonde de disponibilité (readiness) interroge
/sante: tant que le modèle n'est pas chargé, la réplique ne reçoit aucun trafic. - La sonde de vivacité (liveness) redémarre une réplique bloquée. Son délai initial doit dépasser le temps de chargement, sans quoi Kubernetes tuerait la réplique en plein chargement, indéfiniment.
4. Mesurer le service
Un service de prédiction se mesure comme n'importe quel service : avec un tir de charge, et en lisant des percentiles (chapitre 26). Les mesures ci-dessous ont été obtenues avec l'outil hey, sur le service ci-dessus, modèle de Listify chargé, sur un poste Linux à 22 cœurs.
hey -n 3000 -c 10 -m POST -T application/json \
    -d '{"titre":"acheter du pain"}' http://localhost:8000/suggestion
| Configuration | Concurrence | Débit (req/s) | Médiane | 95ᵉ pct | 99ᵉ pct |
|---|---|---|---|---|---|
| 1 worker | 1 | 286 | 3,3 ms | 4,3 ms | 5,5 ms |
| 1 worker | 10 | 291 | 32,6 ms | 55,7 ms | 69,4 ms |
| 1 worker | 50 | 268 | 176,7 ms | 278,3 ms | 373,2 ms |
| 4 workers | 10 | 952 | 8,4 ms | 20,0 ms | 26,7 ms |
| 4 workers | 50 | 804 | 45,4 ms | 87,1 ms | 134,5 ms |
| 4 workers | 100 | 861 | 105,2 ms | 153,5 ms | 209,6 ms |
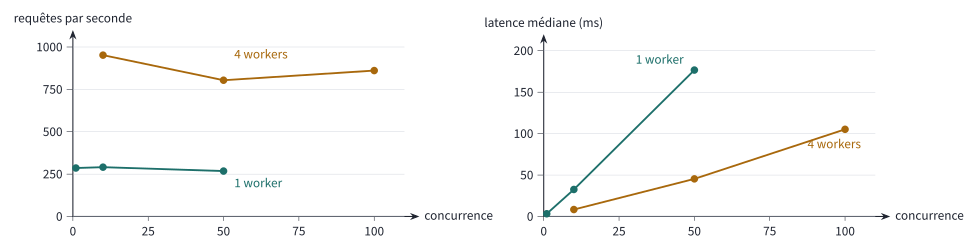
Débit et latence mesurés. Passé le point de saturation, le débit n'augmente plus : seule la latence croît, proportionnellement au nombre de requêtes en vol.
PDF vectoriel5. Protéger le service
Un service de prédiction est un composant sur le chemin critique d'une application. Il doit se défendre.
- Limiter les tailles.
max_length=200sur le titre, 256 titres par lot : sans cela, un client peut envoyer un lot de 100 000 titres et bloquer un worker pendant des minutes. C'est une limite de contrat, pas une optimisation. - Fixer des délais d'attente. Côté client (le backend Listify), un délai court : au-delà, on renonce à la suggestion (chapitre 30, §6.1). Côté serveur, l'option
--timeoutde Gunicorn tue un worker bloqué. - Refuser plutôt que subir. Quand la file dépasse un seuil, mieux vaut répondre 429 ou 503 immédiatement que d'accepter des requêtes dont la réponse arrivera trop tard : c'est le délestage (load shedding) décrit par le livre SRE de Google, qui évite l'effondrement en cascade 1.
- Isoler les ressources. Un service de prédiction qui partage son pod avec le backend fait de la lenteur du modèle la lenteur de l'application : c'est l'argument du chapitre 30, §7.
6. Observer le service
Le chapitre 26 a instrumenté Listify avec les signaux RED (débit, erreurs, durée). Un service de modèle a besoin des mêmes, plus de signaux propres au ML :
| Signal | Exemple de métrique | Ce qu'il détecte |
|---|---|---|
| Débit, erreurs, durée (RED) | http_requests_total, histogramme des durées | Saturation, panne, régression de performance |
| Version servie | modele_version_info{version="..."} | Une réplique qui sert encore l'ancien modèle après une promotion |
| Distribution des classes prédites | predictions_total{categorie="courses"} | Un modèle qui se met à tout classer pareil (chapitre 27) |
| Confiance moyenne | Histogramme de la confiance | Une entrée qui s'éloigne de l'entraînement |
| Taux de rejet à la validation | erreurs_422_total | Un client qui change de format sans prévenir |
Les trois dernières lignes sont la matière première du chapitre 35 : la surveillance de la dérive. Une pratique s'impose dès maintenant : journaliser un échantillon des prédictions (entrée, sortie, confiance, version du modèle, horodatage). Sans ce journal, aucune détection de dérive ni réentraînement supervisé n'est possible plus tard. Avec lui, attention aux données personnelles : un titre de tâche en est une (chapitre 38).
7. Conteneuriser
Le service devient une image OCI, construite par la chaîne du semestre 2 :
FROM docker.io/library/python:3.13-slim

ENV PYTHONDONTWRITEBYTECODE=1 PYTHONUNBUFFERED=1
WORKDIR /app

COPY requirements.txt .
RUN pip install --no-cache-dir -r requirements.txt

COPY service.py .

RUN useradd --create-home --uid 10001 service
USER service

EXPOSE 8000
CMD ["gunicorn", "service:app", "-k", "uvicorn.workers.UvicornWorker", \
     "-w", "2", "-b", "0.0.0.0:8000", "--timeout", "60"]
8. Changer de modèle sans changer de code
Le service charge models:/listify-categorie@champion au démarrage. Que se passe-t-il quand le chapitre 31 déplace l'alias vers une nouvelle version ?
- Rien, tant que les répliques tournent : elles servent le modèle chargé. C'est un avantage (la promotion ne casse rien) et une contrainte (il faut agir pour qu'elle prenne effet).
- Le déclenchement le plus simple est un redéploiement (
kubectl rollout restart), qui recrée les répliques une à une : chacune recharge l'alias, le déploiement progressif du chapitre 24 s'applique tel quel, et le retour arrière consiste à remettre l'alias puis à redéployer. - Une alternative est une route d'administration
POST /recharger, ou un rechargement périodique. Elle évite le redéploiement, mais introduit deux difficultés : des répliques qui servent des modèles différents pendant quelques secondes, et une route qui change le comportement du service en production, donc à protéger. - La version servie doit être exposée (
/sante) et journalisée avec chaque prédiction. Sans cela, on ne peut pas relier un incident à un modèle, ni vérifier qu'une promotion a bien pris effet partout.
Le TP 25 déploiera ce service sur le cluster du semestre 2, et le TP 27 reliera promotion et déploiement dans une seule chaîne.
Ce qu'il faut retenir
- Servir un modèle, c'est publier et tenir un contrat : entrées validées, sorties typées, erreurs distinctes (422 pour une entrée invalide, 503 pour un modèle absent), objectif de latence, version exposée.
- FastAPI + Pydantic transforment ce contrat en code : la validation renvoie l'emplacement exact du problème, et le
response_modelgarantit la forme de la réponse. - Le modèle se charge au démarrage (5 à 6 s mesurées), jamais par requête. La sonde de disponibilité attend ce chargement ; la sonde de vivacité doit être plus patiente que lui.
- Un service se mesure avec un tir de charge et des percentiles. Passé la saturation, le débit plafonne et seule la latence croît : , vérifié à quelques pour cent (34 ms prédites, 32,6 mesurées).
- Le parallélisme rend moins que promis : 4 workers ont donné 3,3 fois le débit d'un seul, pour environ 220 Mio de mémoire chacun.
- Le traitement par lot est la plus grande économie disponible : 25 fois plus de prédictions par seconde avec des lots de 32, pour 2 ms de latence en plus.
- Un service se protège : tailles bornées, délais d'attente, délestage (429/503) plutôt qu'effondrement, isolation des ressources.
- On observe RED plus des signaux de ML (version servie, distribution des classes, confiance, rejets), et l'on journalise un échantillon des prédictions : c'est la matière du chapitre 35.
- L'image d'un service de ML est grosse (922 Mo mesurés contre 151 Mo pour l'application) et lente à démarrer : ordonner les couches, alléger les dépendances, prévoir le téléchargement dans les délais de mise à l'échelle.
- Les artefacts du modèle doivent être accessibles de la même façon depuis l'entraînement et le service : stockage objet partagé, pas de chemin local ni de montage.
- Promouvoir un modèle ne change rien tant que les répliques n'ont pas rechargé : le redéploiement progressif est le déclencheur le plus simple et le plus sûr.
Regard recherche
Bibliographie du chapitre
Sources primaires
- Documentation de FastAPI et de Pydantic (validation,
response_model, cycle de vie). fastapi.tiangolo.com - Documentation de MLflow, « Deploy MLflow Model as a Local Inference Server » et « MLflow Models ».
- Betsy Beyer et al. (dir.), Site Reliability Engineering, O'Reilly, 2016, chapitres 21 et 22 (gestion de la surcharge, pannes en cascade).
Lectures recommandées
- Chip Huyen, Designing Machine Learning Systems, O'Reilly, 2022, chapitre 7 : service de prédiction, compression de modèles, matériel.
- Documentation de KServe et de BentoML, deux façons d'automatiser ce que ce chapitre construit à la main (chapitre 34).
Pour aller plus loin
- Les articles de la rubrique « Regard recherche ».
- Documentation de Gunicorn et d'Uvicorn : modèle de processus,
--timeout,--preload, signaux d'arrêt.