Du notebook au projet reproductible, avec DVC
Ce que vous allez construire
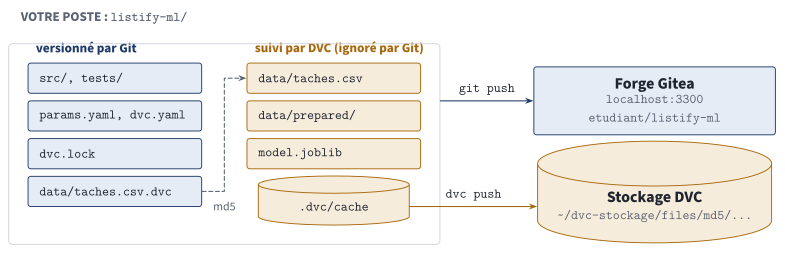
Deux outils, deux familles de fichiers, deux destinations. Git versionne ce qui est petit et écrit à la main (le code, les paramètres, les pointeurs) ; DVC versionne ce qui est gros ou calculé (les données, le modèle). Le lien entre les deux, ce sont les empreintes que contiennent les fichiers .dvc et dvc.lock.
Relisez la liste « ce qu'il aurait fallu enregistrer » de votre fiche d'autopsie. Ce TP y répond ligne à ligne :
| Entrée | Ce qui manquait au TP 22 | Ce qui en tient lieu dans ce TP |
|---|---|---|
| Code | nettoyer dans une cellule supprimée ; exécution dans le désordre | Des scripts dans src/, testés, exécutés dans un ordre fixé par dvc.yaml |
| Données | Un chemin absolu, trois fichiers concurrents | Un seul data/taches.csv, désigné par son empreinte dans data/taches.csv.dvc |
| Paramètres | seuil et C_best perdus, une note contradictoire | params.yaml, versionné, et recopié dans dvc.lock à chaque exécution |
| Environnement | « Il faut juste pandas et scikit-learn » | requirements.txt épinglé et .python-version |
| Aléa | Un découpage sans graine | Un découpage temporel, déterministe par construction |
| Modèle livré | Le classifieur sans son vectoriseur | Un Pipeline scikit-learn complet, qui accepte des titres bruts |
Étape 0 : préparer le poste (15 min)
Le TP réutilise les données du kit de Claire. Vérifiez qu'elles sont toujours là, et intactes : comparez leurs empreintes à celles que vous aviez relevées au TP 22.
ls ~/tp22/tp22-kit/data/
sha256sum ~/tp22/tp22-kit/data/export_taches_final*.csv
grep export_taches_final ~/tp22/tp22-kit/empreintes.txt
Si vous avez perdu le kit, retéléchargez-le : tp22-kit.tar.gz.
Si votre forge Gitea du TP 19 existe encore, redémarrez-la ; elle hébergera le dépôt. Sinon, le TP fonctionne aussi sans forge (voir l'étape 5.3).
podman start gitea
until curl -sf http://localhost:3300/api/healthz >/dev/null; do sleep 2; done; echo "Gitea prête"
Étape 1 : le squelette du dépôt (20 min)
mkdir -p ~/tp23/listify-ml && cd ~/tp23/listify-ml
git init -b main
mkdir -p src tests data
touch src/__init__.py
echo "3.14" > .python-version        # adaptez à votre version : python3 --version
Le fichier .python-version note la version de Python du projet ; des outils comme pyenv ou uv le lisent pour choisir l'interpréteur. Créez ensuite requirements.txt, qui épingle chaque bibliothèque à une version exacte, y compris les dépendances indirectes qui influent sur les calculs (NumPy, SciPy) :
# Environnement d'entraînement, testé avec Python 3.14.
# Mettre à jour volontairement, jamais par accident : chaque changement se commite.
dvc==3.67.1
joblib==1.6.0
numpy==2.5.3
pandas==3.0.6
PyYAML==6.0.3
scikit-learn==1.9.1
scipy==1.18.1
threadpoolctl==3.7.0
pytest==9.1.1
Puis l'environnement virtuel :
python3 -m venv .venv
source .venv/bin/activate
pip install -r requirements.txt
printf ".venv/\n__pycache__/\n" > .gitignore
Étape 2 : versionner les données avec DVC (40 min)
2.1 Initialiser DVC et suivre l'export
dvc init
git status --short
dvc init crée un dossier .dvc/ (configuration et cache) et le prépare pour Git. Copiez maintenant l'export que Claire avait réellement utilisé, sous un nom stable : le nom d'un fichier ne doit plus porter sa version (_final, _v2, _OK), c'est le rôle de l'outil.
cp ~/tp22/tp22-kit/data/export_taches_final.csv data/taches.csv
dvc add data/taches.csv
cat data/taches.csv.dvc
cat data/.gitignore
Résultat obtenu :
outs:
- md5: 543d08a111422fcac8e249bf861bc975
  size: 957149
  hash: md5
  path: taches.csv
/taches.csv
dvc add a fait trois choses : il a copié le fichier dans le cache .dvc/cache, sous un nom égal à son empreinte ; il a écrit le pointeur data/taches.csv.dvc, un fichier de cinq lignes ; et il a ajouté taches.csv au .gitignore du dossier, pour que Git ne l'avale jamais par erreur. Vérifiez que l'empreinte du pointeur est bien celle du fichier :
md5sum data/taches.csv
2.2 Le stockage distant
Le cache est local. Pour qu'un collègue, un job de CI ou vous-même sur une autre machine puissiez récupérer les données, il faut un stockage distant. En entreprise, c'est un stockage objet (S3, MinIO, Google Cloud Storage) ; ici, un simple dossier suffit, et le principe est identique.
dvc remote add -d stockage ~/dvc-stockage
cat .dvc/config
dvc push
[core]
    remote = stockage
['remote "stockage"']
    url = /home/etudiant/dvc-stockage
1 file pushed
Allez voir ce que contient ce stockage :
find ~/dvc-stockage -type f
/home/etudiant/dvc-stockage/files/md5/54/3d08a111422fcac8e249bf861bc975
Aucun nom de fichier, aucune date, aucun numéro de version : seulement l'empreinte du contenu, découpée en un dossier de deux caractères et un nom de trente. C'est le stockage adressé par le contenu du chapitre 28, visible sur disque. Deux versions identiques d'un fichier n'y occupent qu'une place ; un fichier modifié d'un seul octet y occupe une nouvelle place.
2.3 Premier commit
git add -A
git commit -m "Squelette, environnement épinglé, données suivies par DVC"
git show --stat HEAD
Vérifiez dans la sortie de git show que data/taches.csv n'apparaît pas, mais que data/taches.csv.dvc apparaît. Le dépôt Git pèse quelques kilo-octets ; les données vivent ailleurs.
Point de contrôle 2
dvc statusafficheData and pipelines are up to date.md5sum data/taches.csvdonne543d08a111422fcac8e249bf861bc975, la même valeur que le pointeur et que le nom du fichier dans~/dvc-stockage.git ls-fileslistedata/taches.csv.dvcetdata/.gitignore, pasdata/taches.csv.
Étape 3 : le code des étapes (1 h 15)
Le notebook mêlait tout dans un seul noyau. On le découpe en trois scripts, un par étape, qui ne communiquent que par des fichiers : c'est ce qui permettra à DVC de savoir ce qui a changé.
3.1 Les paramètres
Tous les réglages vivent dans un seul fichier, lu par les scripts. Plus aucune valeur ne se cache dans une cellule.
donnees:
  categories: [administratif, courses, loisirs, maison, travail]
  renommages: {}           # étiquette reçue -> étiquette officielle
  part_test: 0.2           # les 20 % de tâches les plus récentes servent au test
modele:
  min_df: 3                # un terme doit apparaître dans au moins 3 titres
  ngram_max: 2             # mots isolés et paires de mots
  C: 5
  max_iter: 500
3.2 L'étape prepare : valider, nettoyer, découper
"""Étape prepare : valide l'export, nettoie les titres, découpe dans le temps.

Usage : python src/prepare.py <export.csv> <dossier de sortie>
"""
import sys
from pathlib import Path

import pandas as pd
import yaml

COLONNES = ["cree_le", "titre", "categorie"]


def nettoyer(titre: str) -> str:
    return titre.strip().lower()


def valider(df: pd.DataFrame, categories: list[str]) -> list[str]:
    """Renvoie la liste des problèmes trouvés dans l'export (vide si tout va bien)."""
    if list(df.columns) != COLONNES:
        return [f"colonnes {list(df.columns)} au lieu de {COLONNES}"]
    problemes = []
    inconnues = sorted(set(df.categorie) - set(categories))
    if inconnues:
        problemes.append(f"catégories inconnues : {inconnues}")
    if df.titre.isna().any():
        problemes.append(f"{df.titre.isna().sum()} titres vides")
    dates = pd.to_datetime(df.cree_le, format="%Y-%m-%d", errors="coerce")
    if dates.isna().any():
        problemes.append(f"{dates.isna().sum()} dates illisibles")
    return problemes


def preparer(df: pd.DataFrame, params: dict) -> tuple[pd.DataFrame, pd.DataFrame]:
    df = df.dropna(subset=["categorie"]).copy()
    df["categorie"] = df.categorie.str.lower().replace(params["renommages"])
    problemes = valider(df, params["categories"])
    if problemes:
        raise ValueError(" ; ".join(problemes))
    df["titre"] = df.titre.map(nettoyer)
    df = df.sort_values("cree_le", kind="stable")
    coupure = int(len(df) * (1 - params["part_test"]))
    return df.iloc[:coupure], df.iloc[coupure:]


if __name__ == "__main__":
    export, sortie = sys.argv[1], Path(sys.argv[2])
    with open("params.yaml") as f:
        params = yaml.safe_load(f)["donnees"]
    try:
        train, test = preparer(pd.read_csv(export), params)
    except ValueError as e:
        sys.exit(f"Export refusé : {e}")
    sortie.mkdir(parents=True, exist_ok=True)
    train.to_csv(sortie / "train.csv", index=False)
    test.to_csv(sortie / "test.csv", index=False)
    print(f"train : {len(train)} tâches jusqu'au {train.cree_le.iloc[-1]} ; "
          f"test : {len(test)} tâches à partir du {test.cree_le.iloc[0]}")
Trois décisions méritent d'être comprises :
- La validation arrête tout. Si l'export contient une catégorie inconnue, une colonne manquante ou une date illisible, le script s'arrête avec un code d'erreur, et le pipeline avec lui. Un modèle entraîné sur des données non conformes est pire que pas de modèle : il échoue en silence (chapitre 27). Les majuscules de Claire (
Loisirs) sont corrigées avant la validation ; un renommage connu passe parparams.yaml. - Le découpage est temporel. Les 20 % de tâches les plus récentes servent au test, comme au §5.3 du TP 22 : c'est l'évaluation la plus fidèle à la production. Le tri est stable (
kind="stable") : deux tâches de même date gardent leur ordre d'origine, sans quoi l'algorithme de tri par défaut pourrait les permuter et changer la frontière entre entraînement et test. - Il n'y a pas de graine. Rien n'est tiré au hasard : ni le découpage, ni l'entraînement (le solveur
lbfgsde la régression logistique est déterministe). La meilleure graine est celle dont on n'a pas besoin. Il faudra néanmoins vérifier ce déterminisme, à l'étape 5.
3.3 L'étape train : un pipeline complet
"""Étape train : entraîne le pipeline complet (vectoriseur + classifieur) et le sauvegarde.

Usage : python src/train.py <train.csv> <modèle.joblib>
"""
import sys

import joblib
import pandas as pd
import yaml
from sklearn.feature_extraction.text import TfidfVectorizer
from sklearn.linear_model import LogisticRegression
from sklearn.pipeline import Pipeline


def construire(p: dict) -> Pipeline:
    return Pipeline([
        ("tfidf", TfidfVectorizer(min_df=p["min_df"], ngram_range=(1, p["ngram_max"]))),
        ("clf", LogisticRegression(C=p["C"], max_iter=p["max_iter"])),
    ])


if __name__ == "__main__":
    train_csv, modele_joblib = sys.argv[1], sys.argv[2]
    with open("params.yaml") as f:
        params = yaml.safe_load(f)["modele"]
    train = pd.read_csv(train_csv)
    modele = construire(params).fit(train.titre, train.categorie)
    joblib.dump(modele, modele_joblib)
    print(f"modèle entraîné sur {len(train)} tâches, vocabulaire de "
          f"{len(modele.named_steps['tfidf'].vocabulary_)} termes")
La différence avec Claire tient en un mot : Pipeline. Le vectoriseur et le classifieur sont assemblés en un seul objet, entraîné et sauvegardé d'un bloc. Le fichier model.joblib accepte directement des titres de tâches, et applique à chacun exactement la transformation apprise à l'entraînement. Le décalage entre entraînement et service du chapitre 27, et l'impasse de l'étape 6 du TP 22, deviennent impossibles.
3.4 L'étape evaluate
"""Étape evaluate : mesure le modèle sur les tâches les plus récentes.

Usage : python src/evaluate.py <modèle.joblib> <test.csv> <metrics.json>
"""
import json
import sys

import joblib
import pandas as pd
from sklearn.metrics import accuracy_score, recall_score

if __name__ == "__main__":
    modele_joblib, test_csv, metrics_json = sys.argv[1], sys.argv[2], sys.argv[3]
    modele = joblib.load(modele_joblib)
    test = pd.read_csv(test_csv)
    predit = modele.predict(test.titre)
    classes = list(modele.classes_)
    rappels = recall_score(test.categorie, predit, labels=classes, average=None)
    metrics = {
        "precision": round(accuracy_score(test.categorie, predit), 4),
        "rappel_par_categorie": {c: round(r, 4) for c, r in zip(classes, rappels)},
        "n_test": len(test),
    }
    with open(metrics_json, "w") as f:
        json.dump(metrics, f, indent=2, ensure_ascii=False)
    print(json.dumps(metrics, ensure_ascii=False))
Les métriques sont écrites dans un fichier JSON que DVC saura lire et comparer entre versions. Le rappel par catégorie complète la précision globale : un modèle peut progresser en moyenne et régresser sur une catégorie (chapitre 29, §6).
3.5 Un outil pour interroger le modèle
"""Suggère une catégorie pour des titres de tâches : python src/predire.py "titre" ["titre" ...]"""
import sys

import joblib

modele = joblib.load("model.joblib")
for titre, probas in zip(sys.argv[1:], modele.predict_proba(sys.argv[1:])):
    meilleure = probas.argmax()
    print(f"{titre!r:40} -> {modele.classes_[meilleure]} ({probas[meilleure]:.0%})")
3.6 Les tests
Le code des étapes est du code : il se teste. Les tests ci-dessous vérifient les comportements que l'autopsie a révélés comme critiques.
[pytest]
pythonpath = .
testpaths = tests
"""Tests de l'étape prepare et du pipeline : python -m pytest"""
import pandas as pd
import pytest

from src.prepare import nettoyer, preparer, valider
from src.train import construire

CATEGORIES = ["administratif", "courses", "loisirs", "maison", "travail"]
PARAMS = {"categories": CATEGORIES, "renommages": {}, "part_test": 0.25}


def export(lignes):
    return pd.DataFrame(lignes, columns=["cree_le", "titre", "categorie"])


def test_nettoyer():
    assert nettoyer("  Acheter du PAIN ") == "acheter du pain"


def test_categorie_inconnue_refusee():
    df = export([("2025-01-06", "payer le loyer", "admin")])
    assert valider(df, CATEGORIES) == ["catégories inconnues : ['admin']"]


def test_renommage_accepte():
    df = export([("2025-01-06", "payer le loyer", "admin")] * 4)
    train, test = preparer(df, {**PARAMS, "renommages": {"admin": "administratif"}})
    assert set(train.categorie) | set(test.categorie) == {"administratif"}


def test_majuscules_et_vides():
    df = export([("2025-01-06", "Payer le loyer", "Administratif"),
                 ("2025-01-07", "acheter du lait", None),
                 ("2025-01-08", "ranger le garage", "maison"),
                 ("2025-01-09", "lire un roman", "loisirs")])
    train, test = preparer(df, PARAMS)
    assert len(train) + len(test) == 3
    assert "administratif" in set(train.categorie)


def test_date_illisible_refusee():
    df = export([("06/01/2025", "payer le loyer", "administratif")])
    with pytest.raises(ValueError, match="dates illisibles"):
        preparer(df, PARAMS)


def test_decoupage_temporel():
    df = export([(f"2025-01-{j:02d}", f"tâche {j}", "travail") for j in range(20, 0, -1)])
    train, test = preparer(df, PARAMS)
    assert len(test) == 5
    assert train.cree_le.max() <= test.cree_le.min()


def test_pipeline_insensible_a_la_casse_et_aux_espaces():
    titres = ["acheter du pain", "acheter du lait", "payer le loyer", "payer les impôts"] * 3
    etiquettes = ["courses", "courses", "administratif", "administratif"] * 3
    modele = construire({"min_df": 1, "ngram_max": 2, "C": 5, "max_iter": 500}).fit(titres, etiquettes)
    brut = ["  Acheter du PAIN ", "PAYER le loyer"]
    assert list(modele.predict(brut)) == list(modele.predict([nettoyer(t) for t in brut]))
python -m pytest -q
.......                                                                  [100%]
7 passed in 1.28s
Le dernier test mérite l'attention : il vérifie que le pipeline donne la même réponse pour " Acheter du PAIN " et pour sa version nettoyée. Le vectoriseur met déjà les titres en minuscules et ignore les espaces en découpant les mots : un titre saisi tel quel dans l'application sera donc traité comme les titres d'entraînement, sans qu'il faille réécrire nettoyer dans l'API.
git add -A
git commit -m "Étapes prepare, train, evaluate et leurs tests"
Étape 4 : le pipeline (40 min)
4.1 Décrire les étapes
stages:
  prepare:
    cmd: python src/prepare.py data/taches.csv data/prepared
    deps:
      - src/prepare.py
      - data/taches.csv
    params:
      - donnees
    outs:
      - data/prepared
  train:
    cmd: python src/train.py data/prepared/train.csv model.joblib
    deps:
      - src/train.py
      - data/prepared/train.csv
    params:
      - modele
    outs:
      - model.joblib
  evaluate:
    cmd: python src/evaluate.py model.joblib data/prepared/test.csv metrics.json
    deps:
      - src/evaluate.py
      - model.joblib
      - data/prepared/test.csv
    metrics:
      - metrics.json:
          cache: false
Chaque étape déclare sa commande, ses dépendances, les sections de params.yaml qu'elle lit, et ses sorties. prepare ne dépend que de donnees, train que de modele : changer C ne relancera pas la préparation. Les métriques sont marquées cache: false : ce petit fichier est versionné directement par Git, pour qu'on puisse le lire dans l'historique sans DVC.
4.2 Exécuter
dvc repro
'data/taches.csv.dvc' didn't change, skipping
Running stage 'prepare':
> python src/prepare.py data/taches.csv data/prepared
train : 15882 tâches jusqu'au 2025-10-25 ; test : 3971 tâches à partir du 2025-10-25
Generating lock file 'dvc.lock'
Updating lock file 'dvc.lock'

Running stage 'train':
> python src/train.py data/prepared/train.csv model.joblib
modèle entraîné sur 15882 tâches, vocabulaire de 1036 termes
Updating lock file 'dvc.lock'

Running stage 'evaluate':
> python src/evaluate.py model.joblib data/prepared/test.csv metrics.json
{"precision": 0.862, "rappel_par_categorie": {"administratif": 0.8441, "courses": 0.7592, "loisirs": 0.8407, "maison": 0.9127, "travail": 0.9061}, "n_test": 3971}
Updating lock file 'dvc.lock'
La précision de 86,2 % est celle du découpage temporel du TP 22 (86,25 % ; l'écart vient du tri stable, qui déplace quelques tâches à la frontière). C'est le chiffre honnête, et désormais le chiffre officiel : il est écrit dans metrics.json, versionné, et relié à tout ce qui l'a produit.
Ouvrez dvc.lock. Pour chaque étape, il contient l'empreinte de chaque dépendance, la valeur de chaque paramètre lu, et l'empreinte de chaque sortie. Voici l'extrait de l'étape train :
  train:
    cmd: python src/train.py data/prepared/train.csv model.joblib
    deps:
    - path: data/prepared/train.csv
      hash: md5
      md5: 95f2f79873add608654c517fe6ea3ac1
      size: 764880
    - path: src/train.py
      hash: md5
      md5: 96dcaaee9f703daae7a7c327dc3aceca
      size: 1039
    params:
      params.yaml:
        modele:
          min_df: 3
          ngram_max: 2
          C: 5
          max_iter: 500
    outs:
    - path: model.joblib
      hash: md5
      md5: c6d5eafc9d0342680eaf005f54b7c863
      size: 67892
C'est la fiche d'identité complète du modèle, que Claire n'avait pas écrite. Vos empreintes de src/train.py différeront si vous avez changé ne serait-ce qu'une espace dans le script ; celles des données et du modèle doivent être identiques.
Essayez le modèle, avec un titre saisi n'importe comment :
python src/predire.py " Acheter du PAIN " "payer les impôts" "voir Kévin"
'  Acheter du PAIN '                     -> courses (98%)
'payer les impôts'                       -> administratif (97%)
'voir Kévin'                             -> courses (80%)
Le troisième titre est un titre personnel, dont les mots ne disent rien de la catégorie : le modèle répond avec assurance, et probablement à tort. Notez-le : une probabilité élevée n'est pas une garantie.
4.3 Commiter, étiqueter, pousser
git add -A
git status --short               # dvc.lock, metrics.json, les .gitignore : pas de CSV, pas de .joblib
git commit -m "Pipeline reproductible : prepare, train, evaluate"
git tag v1
dvc push                         # 4 files pushed
Sur la forge, créez un dépôt vide listify-ml (menu +, puis Nouveau dépôt, sans initialisation), puis :
git remote add forge http://localhost:3300/etudiant/listify-ml.git
git push forge main --tags
Étape 5 : prouver la reproductibilité (45 min)
Un projet « reproductible » qu'on n'a jamais reproduit n'est qu'une promesse. Deux épreuves.
5.1 Le déterminisme : réentraîner et comparer
sha256sum model.joblib
dvc repro --force
sha256sum model.joblib
e4e195fecce8ab34e20833a40116db013ae61acc699d1fbdba09c9ca3db1bfdd  model.joblib
...
e4e195fecce8ab34e20833a40116db013ae61acc699d1fbdba09c9ca3db1bfdd  model.joblib
--force réexécute toutes les étapes même si rien n'a changé. Le fichier produit est identique à l'octet près : le pipeline est déterministe. Si ce n'était pas le cas (un calcul parallèle dont l'ordre varie, un tirage aléatoire oublié), c'est ici qu'on le découvrirait.
5.2 Le clone neuf : reproduire ailleurs
Jouez le collègue qui arrive sur le projet, dans un dossier vierge et un environnement vierge :
cd ~/tp23
git clone http://localhost:3300/etudiant/listify-ml.git clone && cd clone
python3 -m venv .venv && source .venv/bin/activate
pip install -r requirements.txt
dvc status
dvc status signale des fichiers deleted et not in cache : c'est normal, le clone contient les pointeurs mais pas encore les contenus. Récupérez-les, puis demandez à DVC de vérifier l'ensemble :
dvc pull
dvc repro
sha256sum model.joblib
A       data/taches.csv
A       model.joblib
...
Data and pipelines are up to date.
e4e195fecce8ab34e20833a40116db013ae61acc699d1fbdba09c9ca3db1bfdd  model.joblib
Data and pipelines are up to date signifie que toutes les empreintes des fichiers présents correspondent à celles de dvc.lock. Allez jusqu'au bout : dvc repro --force dans le clone réentraîne le modèle dans le nouvel environnement, et doit redonner la même empreinte. Lors de la préparation, c'est le cas.
Comparez avec le TP 22 : le même résultat vous avait coûté une demi-journée d'enquête. Il en coûte maintenant quatre commandes, et aucune réflexion.
cd ~/tp23/listify-ml && deactivate && source .venv/bin/activate # retour au dépôt principal
5.3 Sans forge
Si vous n'avez pas de forge, clonez directement le dossier : git clone ~/tp23/listify-ml ~/tp23/clone. Le clone trouve le stockage DVC grâce à .dvc/config, qui est versionné. Sur une autre machine, ce chemin local n'existerait pas : c'est la raison d'être d'un stockage objet partagé.
Point de contrôle 5 (fin de la première séance)
git tagaffichev1;git log --onelinemontre trois commits.metrics.jsonindique"precision": 0.862.- Le modèle a la même empreinte SHA-256 dans le dépôt, après
dvc repro --force, et dans le clone. - Au runbook : les quatre commandes qui reproduisent le modèle sur une machine neuve.
Étape 6 : expérimenter proprement (30 min)
Claire avait « essayé 1, 5 et 10 » pour C, et n'avait gardé aucune trace des résultats. Refaites l'expérience avec DVC. Dans params.yaml, passez C à 1, puis :
dvc repro
dvc params diff
dvc metrics diff
'data/taches.csv.dvc' didn't change, skipping
Stage 'prepare' didn't change, skipping
Running stage 'train':
Running stage 'evaluate':
...
Path         Param     HEAD    workspace
params.yaml  modele.C  5       1
Path          Metric                              HEAD    workspace    Change
metrics.json  precision                           0.862   0.8628       0.0008
metrics.json  rappel_par_categorie.administratif  0.8441  0.8566       0.0125
metrics.json  rappel_par_categorie.maison         0.9127  0.8868       -0.0259
metrics.json  rappel_par_categorie.travail        0.9061  0.9207       0.0146
prepare a été ignorée : ni ses données, ni son code, ni sa section de paramètres n'ont changé. Seules les étapes concernées ont tourné. Recommencez avec C: 20 :
Path          Metric                        HEAD    workspace    Change
metrics.json  precision                     0.862   0.8708       0.0088
metrics.json  rappel_par_categorie.loisirs  0.8407  0.8791       0.0384
metrics.json  rappel_par_categorie.travail  0.9061  0.9143       0.0082
Revenez à la valeur de référence, et observez ce que fait DVC :
git checkout params.yaml
dvc repro
Stage 'train' is cached - skipping run, checking out outputs
Stage 'evaluate' is cached - skipping run, checking out outputs
DVC se souvient d'avoir déjà exécuté train avec exactement ces entrées : il restaure le modèle depuis son cache au lieu de le recalculer. C'est le run cache, possible uniquement parce que chaque exécution est identifiée par les empreintes de ses entrées.
Étape 7 : de nouvelles données arrivent (45 min)
Julien, l'ingénieur des données, a refait l'export : plus de tâches, sur une période plus longue. C'est le fichier export_taches_final_v2.csv du kit. Remplacez les données et relancez :
cp ~/tp22/tp22-kit/data/export_taches_final_v2.csv data/taches.csv
dvc status
dvc repro
Verifying data sources in stage: 'data/taches.csv.dvc'

Running stage 'prepare':
> python src/prepare.py data/taches.csv data/prepared
Export refusé : catégories inconnues : ['admin']
ERROR: failed to reproduce 'prepare': failed to run: python src/prepare.py data/taches.csv data/prepared, exited with 1
Le pipeline refuse l'export. Entre les deux extractions, une autre équipe a renommé la catégorie administratif en admin dans la base. Sans validation, le modèle aurait appris six catégories, dont deux synonymes, et l'API aurait commencé à suggérer admin à côté d'administratif : c'est la dépendance de données instable du chapitre 27. La validation l'a transformée en erreur visible, avec sa cause exacte.
La correction ne passe pas par le code, mais par la configuration. Dans params.yaml :
  renommages:              # étiquette reçue -> étiquette officielle
    admin: administratif
dvc repro
dvc params diff
dvc metrics diff v1
Running stage 'prepare':
train : 19200 tâches jusqu'au 2025-12-23 ; test : 4800 tâches à partir du 2025-12-24
Running stage 'train':
modèle entraîné sur 19200 tâches, vocabulaire de 1042 termes
Running stage 'evaluate':
{"precision": 0.875, ...}
Path         Param                     HEAD    workspace
params.yaml  donnees.renommages.admin  -       administratif
Path          Metric                              v1      workspace    Change
metrics.json  n_test                              3971    4800         829
metrics.json  precision                           0.862   0.875        0.013
...
7.1 Le piège de la comparaison
« 86,2 % → 87,5 % : le nouveau modèle est meilleur de 1,3 point. » Faux, ou du moins non démontré. Regardez la ligne n_test : les deux modèles n'ont pas été évalués sur les mêmes tâches. Le jeu de test de v1 couvre la fin de la première période ; celui de v2, la fin d'une période plus longue. Comparer deux précisions mesurées sur deux jeux différents, c'est comparer deux élèves sur deux examens différents.
Pour comparer, il faut évaluer les deux modèles sur le même jeu : le plus récent. dvc get récupère un fichier tel qu'il était à une révision donnée, sans toucher à votre espace de travail :
dvc get . model.joblib --rev v1 -o modele_v1.joblib
python src/evaluate.py modele_v1.joblib data/prepared/test.csv metrics_v1.json
rm modele_v1.joblib metrics_v1.json
{"precision": 0.7435, "rappel_par_categorie": {"administratif": 0.775, "courses": 0.7129, "loisirs": 0.6855, "maison": 0.7773, "travail": 0.7389}, "n_test": 4800}
Sur les tâches les plus récentes, le modèle v1 ne fait plus que 74,4 %, contre 87,5 % pour v2. L'écart réel n'est pas de 1,3 point mais de 13 : le modèle v1 a vieilli, parce que les tâches ont changé (nouveaux collègues, nouveaux dossiers, et un renommage de catégorie). C'est exactement la situation du chapitre 29 : un challenger évalué contre le champion sur les mêmes données récentes. Ici, la promotion ne fait pas de doute.
git add -A
git commit -m "Données v2 : export plus récent, renommage admin -> administratif"
git tag v2
dvc push
git push forge main --tags
Étape 8 : voyager dans le temps (15 min)
L'équipe produit signale un comportement étrange « depuis la dernière mise à jour du modèle » et vous demande de ressortir l'ancien pour comparer. Au TP 22, c'était impossible. Maintenant :
git checkout v1
dvc checkout
sha256sum model.joblib
wc -l data/taches.csv
M       data/prepared/
M       data/taches.csv
M       model.joblib
e4e195fecce8ab34e20833a40116db013ae61acc699d1fbdba09c9ca3db1bfdd  model.joblib
20001 data/taches.csv
Git a remis les pointeurs de v1, DVC a remis les contenus qu'ils désignent : les données, les données préparées et le modèle de v1, au bit près. Revenez au présent :
git checkout main
dvc checkout
sha256sum model.joblib            # 0f1210d3... : le modèle v2
Étape 9 : bilan et fin de séance (15 min)
Reprenez le tableau du début du TP et cochez chaque ligne au runbook, avec la commande qui le prouve. Notez aussi ce qui manque encore, et que le bloc 2 apportera :
| Ce qui manque | Pourquoi c'est un problème | Réponse au bloc 2 |
|---|---|---|
| L'environnement n'est épinglé qu'au niveau de pip | Python et les bibliothèques système peuvent différer | Image de conteneur d'entraînement (TP 25 à 27) |
| Les expériences ne laissent de trace que si on les commite | Les essais abandonnés sont perdus, on ne peut pas les comparer entre eux | Suivi d'expériences MLflow (chapitre 31, TP 24) |
dvc repro se lance à la main | Personne ne réentraîne quand les données changent | Orchestration Airflow (chapitre 32, TP 26) |
| Le modèle n'est servi par rien | predire.py n'est pas une API | Service FastAPI (chapitre 33, TP 25) |
Rangez :
deactivate
podman stop gitea            # si vous l'aviez démarrée
Gardez ~/tp23/listify-ml et ~/dvc-stockage : le bloc 2 part de ce dépôt.
Point de contrôle final
-
listify-mlsur la forge, avec les étiquettesv1etv2 -
python -m pytest -q: 7 tests verts -
dvc status:Data and pipelines are up to date. - Même empreinte du modèle v1 dans le dépôt, après
dvc repro --force, et dans un clone neuf - L'export v2 d'abord refusé par la validation, puis accepté grâce au renommage dans
params.yaml - La comparaison honnête : v1 et v2 évalués sur le même jeu de test récent
- Retour à v1 par
git checkout v1etdvc checkout, puis retour àmain - Runbook à jour
Banque de pannes du TP 23 (réservé enseignant : ne lisez pas si vous jouez le jeu)
Colonne « Origine » : vécue signifie rencontrée lors de la validation du TP ; prévisible signifie déduite de l'outil et évitée par construction dans l'énoncé.
| Symptôme | Cause | Remède | Origine |
|---|---|---|---|
ERROR: output 'data/taches.csv' is already tracked by SCM (e.g. Git). | Le fichier a été ajouté à Git avant dvc add (souvent par un git add -A prématuré) | git rm -r --cached data/taches.csv, commit, puis dvc add | vécue (provoquée) |
Dans le clone : ERROR: failed to pull data from the cloud - Checkout failed for following targets: ... Is your cache up to date? | git push fait, dvc push oublié | dvc push depuis le dépôt d'origine, puis dvc pull dans le clone | vécue (provoquée) |
Dans le clone, dvc status affiche deleted et not in cache | Normal avant dvc pull : pointeurs présents, contenus absents | dvc pull | vécue |
Des fichiers __pycache__/*.pyc apparaissent dans le deuxième commit | .gitignore limité à .venv/ : pytest a compilé les modules avant le git add -A | __pycache__/ dans .gitignore (étape 1), puis git rm -r --cached src/__pycache__ tests/__pycache__ | vécue (première version de l'énoncé) |
| À l'étape 7, l'export v2 est accepté sans erreur | Le renommage admin: administratif figure déjà dans params.yaml (fichier recopié depuis une version plus avancée du projet) | Repartir du params.yaml de l'étape 3.1, avec renommages: {} | vécue (première version de l'énoncé) |
ModuleNotFoundError: No module named 'src' dans pytest | pytest.ini absent, ou src/__init__.py manquant | Créer les deux fichiers de l'étape 3 | prévisible |
| Précision de 0,8625 au lieu de 0,862 | Tri non stable dans prepare.py | kind="stable" ; explication au §3.2 | vécue (écart entre TP 22 et TP 23) |
| Empreinte du modèle différente d'un poste à l'autre | Versions de bibliothèques différentes (environnement non recréé depuis requirements.txt), ou autre version de Python | Recréer l'environnement ; comparer pip freeze ; si la différence persiste, raisonner en reproductibilité statistique (même précision) | prévisible |
dvc repro relance prepare quand on modifie C | Étape prepare déclarée avec params: [modele] ou sans section précise | Déclarer seulement donnees pour prepare | prévisible |
metrics diff affiche des écarts « flatteurs » entre v1 et v2 | Jeux de test différents (voir n_test) | §7.1 : réévaluer v1 sur le jeu de test de v2 | vécue |
Les empreintes de src/*.py diffèrent de celles de l'énoncé | Une espace ou un commentaire différent : normal | Seules les empreintes des données et du modèle doivent coïncider | prévisible |
Panne à injecter en temps limité : dans params.yaml, remplacer part_test: 0.2 par part_test: 0.25 sans le dire, commiter, et demander d'expliquer pourquoi metrics diff v1 n'est plus interprétable, puis de retrouver la cause avec dvc params diff v1.
Pour aller plus loin (bonus)
- Un jeu de validation. Modifiez
preparepour produire trois fichiers : entraînement (70 % les plus anciens), validation (10 %), test (20 % les plus récents). Écrivez une étapetunequi choisitCparmi quelques valeurs sur la validation et écrit la meilleure dans un fichier lu partrain. Vérifiez qu'on ne touche plus au jeu de test pour choisir. - Les expériences DVC. Lisez la documentation de
dvc exp run --set-param modele.C=20etdvc exp show. Qu'apportent-elles par rapport à la modification manuelle deparams.yamlde l'étape 6 ? Que leur manque-t-il par rapport à un outil de suivi d'expériences comme MLflow (chapitre 31) ? - Un stockage objet. Lancez un conteneur MinIO, créez un compartiment, installez
dvc[s3]et configurez un second stockage distant (dvc remote add minio s3://listify-mlavecendpointurl). Poussez-y toutes les versions avecdvc push -r minio --all-tags. - Le ménage. Mesurez la taille de
~/dvc-stockage(du -sh). Que faitdvc gc --workspace? Pourquoi est-il dangereux sans--all-tags? Reliez à la discussion sur le RGPD du chapitre 28, §9.
Questions de compréhension (à préparer pour le TD et l'examen)
- Que contient le fichier
data/taches.csv.dvc, et pourquoi suffit-il à désigner sans ambiguïté un fichier de près d'un mégaoctet ? - Pourquoi le stockage distant ne contient-il aucun nom de fichier lisible ? Quel avantage en tire-t-on quand deux versions des données sont identiques ?
- Ce projet n'utilise aucune graine aléatoire. Pourquoi est-ce possible ici, et comment avez-vous vérifié que le résultat était bien déterministe ?
- Quand vous modifiez
C,dvc reprone relance pasprepare. Quelles informations dedvc.yamlet dedvc.locklui permettent de le décider ? - L'export v2 a été refusé. Pourquoi est-ce une bonne nouvelle ? Qu'aurait-il produit sans validation ?
- Pourquoi « 86,2 % → 87,5 % » ne prouve-t-il rien ? Décrivez la comparaison correcte, et le résultat que vous avez obtenu.
- Vous choisissez
Cen regardant la précision sur le jeu de test. Quel est le problème, et comment le corriger ?