Autopsie d'un notebook irreproductible
Ce que vous allez faire
Ce TP est un chaos volontaire. Le kit que vous recevez n'est pas caricatural : chacun de ses défauts se rencontre tous les jours dans les équipes de données, et l'étude de Pimentel et ses collègues sur 1,4 million de notebooks publiés sur GitHub a montré que seuls 24 % de ceux qu'on a tenté de réexécuter s'exécutaient sans erreur, et 4 % seulement redonnaient les mêmes résultats 1. Vous allez vivre ces chiffres de l'intérieur.
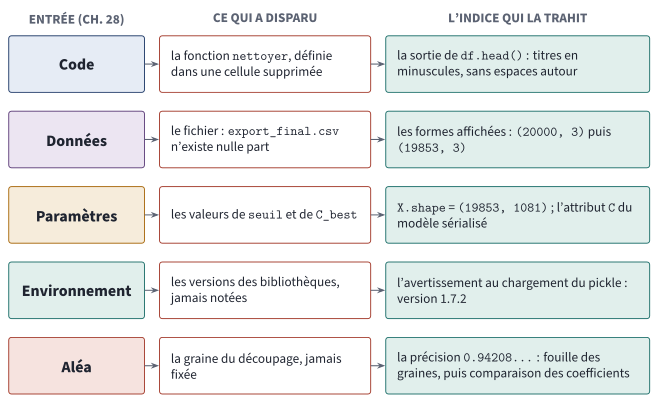
La carte de l'enquête. Chacune des cinq entrées d'un entraînement (chapitre 28) a été perdue, mais chacune a laissé une trace quelque part dans le kit. Ne la lisez pas trop tôt si vous voulez chercher par vous-même.
PDF vectorielLe TP suit l'ordre d'une vraie reprise de projet : figer la scène avant d'y toucher, lire sans exécuter, réexécuter pour voir ce qui casse, enquêter pour retrouver ce qui manque, reconstruire et prouver qu'on a retrouvé le même modèle, puis juger honnêtement le chiffre annoncé.
Étape 0 : préparer le poste (15 min)
Créez un dossier de travail, téléchargez le kit de Claire et décompressez-le :
mkdir -p ~/tp22 && cd ~/tp22
curl -LO https://menraromial.com/ingenierie-deploiement/kits/tp22-kit.tar.gz
tar xzf tp22-kit.tar.gz
ls -R tp22-kit
Résultat attendu :
tp22-kit:
data  LISEZMOI.txt  modele_final.pkl  recherche_categories.ipynb

tp22-kit/data:
export_taches.csv  export_taches_final.csv  export_taches_final_v2.csv
Le kit est aussi téléchargeable depuis cette page : tp22-kit.tar.gz (3 Mo).
Lisez LISEZMOI.txt. Claire écrit qu'« il faut juste pandas et scikit-learn ». Installez donc exactement cela, plus JupyterLab pour ouvrir le notebook, dans un environnement virtuel, comme le ferait quelqu'un qui la croit sur parole :
python3 -m venv .venv
source .venv/bin/activate
pip install jupyterlab pandas scikit-learn
pip list | grep -E "^(pandas|scikit-learn|jupyterlab) "
Notez au runbook les versions installées. Lors de la préparation du TP, on a obtenu scikit-learn 1.9.1, pandas 3.0.6 et JupyterLab 4.6.4 ; vous aurez peut-être des versions plus récentes, et c'est précisément une partie du problème.
Étape 1 : figer la scène avant d'y toucher (15 min)
Un enquêteur ne déplace rien avant d'avoir photographié la scène. Ici, la photographie, c'est Git : si l'exécution du notebook modifie un fichier du kit, vous devez pouvoir le voir et revenir en arrière.
cd tp22-kit
git init -b main
git add -A
git commit -m "Kit de Claire, tel que reçu"
sha256sum modele_final.pkl data/*.csv > empreintes.txt
cat empreintes.txt
Étape 2 : lire sans exécuter (25 min)
Lancez JupyterLab et ouvrez recherche_categories.ipynb, sans rien exécuter :
jupyter lab
Un notebook enregistré conserve le code et les dernières sorties affichées. Ces sorties sont des témoins : elles racontent ce qui s'est passé lors de la dernière exécution de Claire, même si le code qui les a produites a changé depuis. Relevez au runbook, cellule par cellule :
- Les numéros d'exécution entre crochets à gauche de chaque cellule. Dans quel ordre les cellules ont-elles été exécutées ? Que signifie le saut de
[4]à[9], puis de[9]à[14]? - Les noms utilisés mais jamais définis dans le notebook. Il y en a trois.
- Les chemins de fichiers. Existent-ils dans le kit ?
- Les sorties chiffrées : formes des tableaux, précision, messages d'avertissement.
- Ce que dit la dernière cellule de texte sur le choix de
C.
Point de contrôle : ce que la lecture devait révéler
- Ordre d'exécution :
[1],[3],[4],[9],[14],[16]à[20]. La cellule qui lit le fichier ([14]) a été exécutée après celle qui nettoie les données ([3]) : le notebook a été exécuté dans le désordre, et relu à plusieurs reprises. Les numéros manquants (2, 5 à 8, 10 à 13, 15) sont des exécutions de cellules qui n'existent plus. - Noms jamais définis :
nettoyer,seuil,C_best. Ils vivaient dans des cellules supprimées ; tant que le noyau de Claire tournait, ils restaient en mémoire, et le notebook « marchait ». - Chemin :
/home/claire/Téléchargements/export_final.csv, un chemin absolu vers le poste de Claire, et un nom de fichier qui ne correspond à aucun des trois fichiers dedata/. - Sorties :
(20000, 3),(19853, 3),(19853, 1081), unFutureWarningsurmulti_class, et0.9420800805842358. - La note affirme que
C=10« marchait mieux », puis que5a aussi été essayé : on ne sait pas quelle valeur a produit le modèle.
Ces constats illustrent l'état caché des notebooks : ce que le noyau a en mémoire n'est pas ce que le fichier contient, et l'ordre d'exécution n'est pas l'ordre de lecture. Joel Grus en a fait le cœur d'une conférence restée célèbre, « I don't like notebooks » 2.
Étape 3 : tout réexécuter (40 min)
Redémarrez le noyau et exécutez tout, du haut vers le bas : menu Kernel > Restart Kernel and Run All Cells. C'est la seule exécution qui compte, celle qu'on obtiendrait sur un poste neuf. En ligne de commande, l'équivalent est :
jupyter nbconvert --to notebook --execute recherche_categories.ipynb --output essai.ipynb
L'exécution s'arrête à la première erreur. À chaque erreur :
- notez le message exact au journal d'autopsie ;
- classez la cause dans l'une des cinq entrées du chapitre 28 : code, données, paramètres, environnement, aléa ;
- appliquez la correction minimale qui permet d'avancer, même provisoire, et notez votre degré de certitude (« certain », « probable », « au hasard ») ;
- commitez, avec l'entrée concernée dans le message :
git commit -am "Données : chemin relatif vers data/...".
Le journal d'autopsie prend la forme d'un tableau :
| # | Message d'erreur | Entrée | Correction appliquée | Certitude |
|---|---|---|---|---|
| 1 | ... | ... | ... | ... |
Pour les noms introuvables, faites le choix le plus plausible avec ce que vous avez sous les yeux, sans chercher encore à retrouver la valeur exacte : c'est l'objet de l'étape 4. Pour le fichier, choisissez celui qui vous paraît le bon.
Point de contrôle : la séquence d'erreurs obtenue lors de la préparation
Avec scikit-learn 1.9.1, les erreurs arrivent dans cet ordre :
| # | Message d'erreur | Entrée |
|---|---|---|
| 1 | ModuleNotFoundError: No module named 'tqdm' | Environnement : une dépendance importée mais absente de la liste de Claire (et inutilisée) |
| 2 | FileNotFoundError: [Errno 2] No such file or directory: '/home/claire/Téléchargements/export_final.csv' | Données |
| 3 | NameError: name 'nettoyer' is not defined | Code |
| 4 | NameError: name 'seuil' is not defined | Paramètres |
| 5 | NameError: name 'C_best' is not defined | Paramètres |
| 6 | TypeError: LogisticRegression.__init__() got an unexpected keyword argument 'multi_class' | Environnement : l'option, dépréciée depuis la 1.5, n'existe plus en 1.9.1 ; le FutureWarning affiché chez Claire annonçait son retrait |
Après ces six corrections, le notebook s'exécute jusqu'au bout. La précision obtenue change à chaque exécution : le découpage entre entraînement et test n'a pas de graine (aléa). Lors de la préparation, une exécution a donné par exemple 0.9443465122135483 ; la vôtre donnera très probablement une autre valeur, entre 92 et 95 %.
Si vous êtes allé jusqu'au bout : git status montre modele_final.pkl modifié. Restaurez-le tout de suite avec git checkout modele_final.pkl, et commentez la dernière cellule.
Vous avez un notebook qui s'exécute. Vous n'avez pas reproduit le travail de Claire : trois de vos corrections sont des suppositions, et le résultat varie à chaque exécution.
Étape 4 : l'enquête (1 h 10)
Travaillez dans un nouveau notebook enquete.ipynb, ou dans un script, à côté de celui de Claire. Pour chaque entrée perdue, trouvez la trace qu'elle a laissée, et prouvez votre conclusion.
4.1 Les données : quel fichier ?
Aucun des trois fichiers ne s'appelle export_final.csv. Mais les sorties du notebook disent combien de lignes Claire a lues, puis combien il en restait après suppression des catégories vides.
import pandas as pd

for nom in ["export_taches", "export_taches_final", "export_taches_final_v2"]:
    d = pd.read_csv(f"data/{nom}.csv")
    print(nom, d.shape, "->", d.dropna(subset=["categorie"]).shape,
          sorted(d.categorie.dropna().unique()))
Point de contrôle 4.1
export_taches (20000, 3) -> (20000, 3) ['administratif', 'courses', 'loisirs', 'maison', 'travail']
export_taches_final (20000, 3) -> (19853, 3) ['Administratif', 'Courses', 'Loisirs', 'Maison', 'Travail', 'administratif', 'courses', 'loisirs', 'maison', 'travail']
export_taches_final_v2 (24000, 3) -> (24000, 3) ['admin', 'courses', 'loisirs', 'maison', 'travail']
Seul export_taches_final.csv donne (20000, 3) puis (19853, 3). Il contient 147 catégories vides et des catégories écrites avec une majuscule, ce qui explique les deux lignes de nettoyage de la cellule [3]. Le fichier v2 est un ré-export ultérieur, plus long, dans lequel une autre équipe a renommé administratif en admin : c'est la dépendance de données instable du chapitre 27, prise sur le fait. Un modèle entraîné sur v2 n'aurait pas les mêmes classes.
4.2 Le code : que faisait nettoyer ?
La fonction a disparu, mais la sortie de df.head() montre des titres après nettoyage. Comparez-les aux mêmes lignes du fichier brut :
brut = pd.read_csv("data/export_taches_final.csv").dropna(subset=["categorie"])
print(brut.titre.head().tolist())
Écrivez la fonction la plus simple qui transforme les uns en les autres. Notez que la vérification n'est que partielle : cinq lignes ne prouvent pas que nettoyer ne faisait rien d'autre. La preuve viendra au §4.6, quand le modèle reconstruit sera comparé à celui de Claire.
4.3 Les paramètres : le seuil
seuil est passé à TfidfVectorizer(min_df=seuil, ...) : un terme n'entre dans le vocabulaire que s'il apparaît dans au moins seuil titres. Plus le seuil est haut, plus le vocabulaire est petit. Or la sortie X.shape = (19853, 1081) donne la taille exacte du vocabulaire de Claire.
from sklearn.feature_extraction.text import TfidfVectorizer

def nettoyer(titre):
    return titre.strip().lower()

df = pd.read_csv("data/export_taches_final.csv").dropna(subset=["categorie"])
df["categorie"] = df.categorie.str.lower()
df["titre"] = df.titre.apply(nettoyer)

for seuil in range(1, 7):
    vec = TfidfVectorizer(min_df=seuil, ngram_range=(1, 2)).fit(df.titre)
    print(seuil, len(vec.vocabulary_))
Point de contrôle 4.3
1 1101
2 1092
3 1081
4 1066
5 1053
6 1038
Une seule valeur redonne 1 081 termes : seuil = 3. Remarquez que cette déduction n'est possible que parce que le fichier et la fonction nettoyer sont justes : une erreur en amont aurait donné un autre vocabulaire, et aucune valeur n'aurait collé. Chaque indice confirme les précédents.
4.4 Les paramètres et l'environnement : ce que sait le modèle sérialisé
Le fichier modele_final.pkl est un objet scikit-learn sérialisé : il contient les coefficients appris, mais aussi tous les hyperparamètres de l'objet, et la version de scikit-learn qui l'a écrit.
import pickle

with open("modele_final.pkl", "rb") as f:
    clf = pickle.load(f)
print(clf)
print("C =", clf.C, "| n_features_in_ =", clf.n_features_in_, "| classes_ =", list(clf.classes_))
Point de contrôle 4.4
.../sklearn/base.py:525: InconsistentVersionWarning: Trying to unpickle estimator LogisticRegression from version 1.7.2 when using version 1.9.1. This might lead to breaking code or invalid results. Use at your own risk. ...
LogisticRegression(C=5, l1_ratio=None, max_iter=500, penalty='l2')
C = 5 | n_features_in_ = 1081 | classes_ = ['administratif', 'courses', 'loisirs', 'maison', 'travail']
Trois informations, chacune décisive :
C = 5, et non 10 comme le suggérait la note de Claire. Les notes sont des souvenirs ; l'artefact est une mesure. En cas de désaccord, on croit l'artefact.n_features_in_ = 1081: le modèle attend exactement le vocabulaire trouvé au §4.3. Confirmation indépendante du seuil.- La version 1.7.2, révélée par l'avertissement : c'est la seule trace de l'environnement de Claire dans tout le kit. Le notebook indique par ailleurs, dans ses métadonnées, Python 3.12.3.
Notez aussi ce que scikit-learn 1.9.1 a fait silencieusement : l'objet chargé n'a plus d'attribut multi_class. La bibliothèque a adapté l'ancien objet à sa nouvelle interface, en vous prévenant seulement par un avertissement que l'on ignore facilement.
4.5 L'aléa : retrouver la graine
Claire n'a pas fixé random_state : Python a tiré un découpage au hasard, qu'on ne peut plus connaître directement. Mais on connaît le résultat de ce tirage : une précision de 0.9420800805842358, affichée avec toutes ses décimales. On peut chercher parmi les graines celles qui redonnent exactement cette valeur. Créez graine.py :
"""Cherche les graines de découpage qui redonnent la précision affichée par Claire."""
import pandas as pd
from sklearn.feature_extraction.text import TfidfVectorizer
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import train_test_split

CIBLE = 0.9420800805842358


def nettoyer(titre):
    return titre.strip().lower()


df = pd.read_csv("data/export_taches_final.csv").dropna(subset=["categorie"])
df["categorie"] = df.categorie.str.lower()
df["titre"] = df.titre.apply(nettoyer)
X = TfidfVectorizer(min_df=3, ngram_range=(1, 2)).fit_transform(df.titre)
y = df.categorie

for graine in range(150):
    X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=graine)
    precision = LogisticRegression(C=5, max_iter=500).fit(X_train, y_train).score(X_test, y_test)
    if precision == CIBLE:
        print("graine candidate :", graine)
python graine.py # de une à quelques minutes selon le poste
Point de contrôle 4.5
graine candidate : 12
graine candidate : 129
Deux graines redonnent exactement la précision de Claire. Sur 3 971 tâches de test, une précision est un nombre entier de bonnes réponses divisé par 3 971 ; deux découpages différents peuvent très bien produire le même nombre de bonnes réponses. Une même précision ne prouve pas qu'on a le même modèle. Il faut un critère plus fort : c'est l'objet du §4.6.
4.6 Reconstruire et prouver
Assemblez tout ce que vous avez retrouvé, entraînez le modèle pour chaque graine candidate, et comparez ses coefficients à ceux du modèle de Claire. Deux modèles de régression logistique aux coefficients identiques font exactement les mêmes prédictions, sur toutes les entrées possibles. Créez reconstruire.py :
"""Reconstruit le modèle de Claire et le compare, coefficient par coefficient, à modele_final.pkl."""
import pickle
import warnings

import numpy as np
import pandas as pd
from sklearn.feature_extraction.text import TfidfVectorizer
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import train_test_split


def nettoyer(titre):
    return titre.strip().lower()


df = pd.read_csv("data/export_taches_final.csv").dropna(subset=["categorie"])
df["categorie"] = df.categorie.str.lower()
df["titre"] = df.titre.apply(nettoyer)
X = TfidfVectorizer(min_df=3, ngram_range=(1, 2)).fit_transform(df.titre)
y = df.categorie

with warnings.catch_warnings():
    warnings.simplefilter("ignore")          # l'avertissement de version est déjà connu (§4.4)
    with open("modele_final.pkl", "rb") as f:
        claire = pickle.load(f)

for graine in (12, 129):
    X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=graine)
    clf = LogisticRegression(C=5, max_iter=500).fit(X_train, y_train)
    ecart = np.abs(clf.coef_ - claire.coef_).max()
    print(f"graine {graine} : précision {clf.score(X_test, y_test):.6f}, "
          f"coefficients identiques : {np.array_equal(clf.coef_, claire.coef_)}, écart max {ecart:.3g}")
python reconstruire.py
Point de contrôle 4.6
graine 12 : précision 0.942080, coefficients identiques : True, écart max 0
graine 129 : précision 0.942080, coefficients identiques : False, écart max 1.56
Avec la graine 12, les coefficients sont identiques au bit près à ceux du modèle de Claire : fichier, nettoyage, seuil, C et graine sont tous confirmés d'un coup, car la moindre différence sur l'un d'eux aurait changé les coefficients. La graine 129 donne la même précision avec un modèle différent.
Remarque importante : ce résultat a été obtenu avec scikit-learn 1.9.1, alors que Claire utilisait la 1.7.2. Ici, le changement de version a cassé le code (l'option multi_class) mais pas les nombres. Ne le généralisez pas : quand une version change une valeur par défaut, les nombres changent aussi. Ainsi, scikit-learn 0.22 a remplacé le solveur par défaut de LogisticRegression, liblinear, par lbfgs, après l'avoir annoncé en 0.20 3 : un même code, exécuté avant et après, entraîne deux modèles différents.
Rédigez au journal le tableau final : pour chaque entrée, la valeur retrouvée, l'indice qui l'a trahie, et le temps qu'il vous a fallu. Faites le total. C'est le prix de cinq lignes que Claire n'a pas écrites.
4.7 (Facultatif) Rejouer avec l'environnement de Claire
Pour exécuter le notebook sans modifier la cellule multi_class, recréez l'environnement de Claire dans un second environnement virtuel :
python3 -m venv .venv-claire
.venv-claire/bin/pip install "scikit-learn==1.7.2" pandas
scikit-learn 1.7.2 s'installe sous Python 3.14, mais pas forcément toutes les anciennes versions : une bibliothèque ne publie de paquets précompilés que pour les versions de Python qui existaient à sa sortie. Figer un environnement, c'est donc figer aussi la version de Python (d'où, au bloc 2, les images de conteneur). Avec cet environnement, le code d'origine s'exécute avec son seul FutureWarning, et la graine 12 redonne 0.9420800805842358.
Étape 5 : le 94 % tient-il ? (45 min)
Vous savez refaire le modèle. Reste la question qui compte pour la mise en production : que vaut-il vraiment ? Trois mesures, sur le modèle reconstruit.
5.1 La chance
Adaptez graine.py : au lieu de chercher une valeur, mesurez la précision sur les graines 0 à 199, puis affichez le minimum, le maximum, la moyenne, l'écart-type, et le nombre de graines qui font mieux que la graine 12.
Point de contrôle 5.1
Sur 200 graines, lors de la préparation : minimum 0,9237, maximum 0,9469, moyenne 0,9356, écart-type 0,0042 ; seules 11 graines font mieux que la graine 12, et 14,5 % des graines atteignent 94 %. Claire a obtenu un découpage favorable : un résultat dans les 6 % les meilleurs. Le chiffre à annoncer n'était pas « 94 % » mais « 93,6 % ± 0,4 ». C'est le phénomène mesuré au chapitre 28 sur les graines, vécu ici sur un vrai projet.
5.2 Les doublons
Les titres de tâches se répètent beaucoup (« acheter du pain » revient sans cesse). Mesurez la part des titres du jeu de test qui figurent déjà, à l'identique, dans le jeu d'entraînement :
from sklearn.model_selection import train_test_split

titres_train, titres_test = train_test_split(df.titre, test_size=0.2, random_state=12)
print("titres distincts :", df.titre.nunique(), "sur", len(df))
print(f"titres de test déjà vus à l'entraînement : {titres_test.isin(set(titres_train)).mean():.1%}")
Point de contrôle 5.2
titres distincts : 2686 sur 19853
titres de test déjà vus à l'entraînement : 94.3%
Pour 94 % des tâches de test, le modèle a vu exactement le même titre pendant l'entraînement. L'évaluation de Claire mesure surtout sa capacité à se souvenir. Ce n'est pas faux en soi (en production aussi, les titres fréquents reviennent), mais cela ne dit rien de son comportement sur les titres nouveaux, ni sur les tâches de demain.
5.3 Le découpage temporel
En production, le modèle apprend sur le passé et prédit l'avenir. L'évaluation la plus fidèle respecte cet ordre : on entraîne sur les 80 % de tâches les plus anciennes et l'on teste sur les 20 % les plus récentes.
from sklearn.linear_model import LogisticRegression

df = df.sort_values("cree_le")
coupure = int(len(df) * 0.8)
passe, avenir = df.iloc[:coupure], df.iloc[coupure:]
print("coupure au", avenir.cree_le.iloc[0])

vec = TfidfVectorizer(min_df=3, ngram_range=(1, 2))
clf = LogisticRegression(C=5, max_iter=500).fit(vec.fit_transform(passe.titre), passe.categorie)
print(f"précision sur l'avenir : {clf.score(vec.transform(avenir.titre), avenir.categorie):.4f}")
print(f"titres de l'avenir déjà vus : {avenir.titre.isin(set(passe.titre)).mean():.1%}")
Remarquez que le vectoriseur n'est ajusté que sur le passé : ajuster le vocabulaire sur toutes les données, comme le fait le notebook, laisse fuir de l'information du test vers l'entraînement.
Point de contrôle 5.3
coupure au 2025-10-25
précision sur l'avenir : 0.8625
titres de l'avenir déjà vus : 84.5%
86 %, et non 94 %. Les tâches récentes contiennent des titres que le passé ne connaissait pas (de nouveaux collègues, de nouveaux dossiers), et le modèle se trompe sur une grande partie d'entre eux. C'est le chiffre à annoncer à l'équipe produit, et c'est déjà le début de la dérive du chapitre 35.
Étape 6 : le modèle livré est-il utilisable ? (15 min)
Claire écrit qu'« il n'y a plus qu'à brancher le modèle dans l'API ». Essayez :
clf.predict(["acheter du pain"])
Point de contrôle 6
ValueError: Expected 2D array, got 1D array instead: ...
Le fichier modele_final.pkl ne contient que la régression logistique. Elle attend un vecteur de 1 081 nombres, produit par le TfidfVectorizer ajusté dans le notebook... qui n'a pas été sauvegardé. Sans le vectoriseur, le modèle est inutilisable ; avec un vectoriseur réécrit à la main dans l'API, on fabrique le décalage entre entraînement et service du chapitre 27. La seule raison pour laquelle vous pouvez l'utiliser aujourd'hui, c'est que l'enquête du §4 vous a permis de reconstruire un vectoriseur identique. Le remède, que le TP 23 appliquera : sauvegarder un Pipeline scikit-learn qui contient le prétraitement et le modèle, en un seul objet.
Étape 7 : la fiche d'autopsie (25 min)
Rédigez, dans AUTOPSIE.md à la racine du dépôt, une fiche d'une page destinée à l'équipe :
- Constat : ce qui a été livré, ce qui ne se réexécutait pas, en combien d'erreurs.
- Le tableau des cinq entrées : valeur retrouvée, indice, temps passé.
- Le vrai chiffre : précision moyenne et dispersion sur les graines ; précision sur l'avenir.
- Ce qu'il aurait fallu enregistrer, entrée par entrée, en une ligne chacune. Ce sera le cahier des charges du TP 23.
git add AUTOPSIE.md graine.py reconstruire.py empreintes.txt
git commit -m "Autopsie du notebook de Claire"
git log --oneline
Le git log est votre journal d'enquête : un commit par correction, chacun étiqueté par l'entrée qu'il concerne.
Point de contrôle final
- Le kit est sous Git, avec le commit « tel que reçu » et les empreintes SHA-256
-
modele_final.pkln'a pas été écrasé (git statuspropre sur ce fichier, empreinte inchangée) - Journal d'autopsie : six erreurs, chacune rattachée à une entrée
- Les cinq entrées retrouvées, chacune avec son indice
-
reconstruire.pyaffichecoefficients identiques : Truepour la graine retrouvée - La précision honnête : moyenne et écart-type sur les graines, et précision sur l'avenir
-
AUTOPSIE.mdcommité
Solutions et banque de pannes du TP 22 (réservé enseignant : ne lisez pas si vous jouez le jeu)
Solutions. Fichier export_taches_final.csv ; nettoyer = strip + lower ; seuil = 3 ; C_best = 5 ; graine 12 (129 donne la même précision avec d'autres coefficients) ; scikit-learn 1.7.2, Python 3.12.3 d'après les métadonnées. Précision annoncée 0,94208 ; moyenne sur 200 graines 0,9356 ± 0,0042 ; précision temporelle 0,8625.
Fabrication du kit. Les sources sont dans kits/tp22/ du dépôt du cours : donnees.py génère les exports (titres en loi de Zipf, titres ambigus, titres personnels qui se renouvellent dans le temps, 3 % d'erreurs d'étiquetage) ; fabriquer_kit.py rejoue l'exécution d'origine avec l'état caché, écrit les sorties réelles dans le notebook et produit static/kits/tp22-kit.tar.gz. Il doit être exécuté avec scikit-learn 1.7.2 (assertion en tête de script). Pour renouveler les énigmes d'une année sur l'autre, changez SOLUTIONS et les graines de génération.
Colonne « Origine » : vécue signifie rencontrée lors de la validation du TP ; prévisible signifie déduite du kit.
| Symptôme | Cause | Remède | Origine |
|---|---|---|---|
| Toutes les vérifications du §4 échouent ou donnent des coefficients « presque » identiques | Le notebook a été exécuté jusqu'au bout : sa dernière cellule a écrasé modele_final.pkl par un modèle entraîné sur un découpage aléatoire | git checkout modele_final.pkl ; commenter la dernière cellule ; d'où l'étape 1 | vécue |
Aucun InconsistentVersionWarning au chargement du pickle, attribut multi_class absent, version introuvable | Même cause : le pickle a été réécrit par la version installée | Idem ; comparer à empreintes.txt | vécue |
| Aucun seuil ne redonne 1 081 termes | Mauvais fichier (export_taches.csv : 20 000 lignes gardées) ou nettoyer qui enlève aussi les accents | Revenir au §4.1 : les deux formes doivent correspondre | prévisible |
| La recherche de graine ne trouve rien | Vectoriseur, C ou max_iter différents de ceux de Claire, ou test_size modifié | Vérifier chaque valeur contre les sorties du notebook et les attributs du pickle | prévisible |
Les classes contiennent admin | Fichier v2 utilisé | Voir le §4.1 : c'est le renommage fait par une autre équipe | prévisible |
pip install scikit-learn==1.5.2 échoue sous Python 3.14 | Pas de paquet précompilé pour cette version de Python ; compilation depuis les sources | Utiliser 1.7.2 (celle de Claire), ou une version de Python plus ancienne | prévisible |
jupyter lab introuvable après installation | Environnement virtuel non activé dans ce terminal | source .venv/bin/activate | prévisible |
Panne à injecter en temps limité : remettre multi_class="multinomial" et demander de faire tourner le notebook sans changer une ligne de code. Attendu : l'environnement 1.7.2 du §4.7, avec la justification que la version a été lue dans l'avertissement du pickle.
Pour aller plus loin (bonus)
- Trouver la graine plus vite. La recherche entraîne 150 modèles. Pouvez-vous éliminer la plupart des graines sans rien entraîner ? Indice : la taille du jeu de test ne dépend pas de la graine, mais sa composition par catégorie, si. Comparez-la à ce que révèlerait une matrice de confusion, si Claire en avait affiché une.
- Le coût de l'enquête. À partir du tableau de l'étape 4, estimez le coût en heures-ingénieur de la reprise de ce projet. Comparez-le au temps qu'il aurait fallu à Claire pour écrire un
requirements.txt, fixer une graine et sauvegarder unPipeline. - Un outil qui aurait aidé. Installez
nbstripoutou lisez la documentation depapermill. Lequel aurait rendu ce notebook plus reproductible, et lequel aurait au contraire effacé des indices précieux pour votre enquête ?
Questions de compréhension (à préparer pour le TD et l'examen)
- Qu'appelle-t-on l'« état caché » d'un notebook ? Montrez, sur les numéros d'exécution du kit, qu'il a joué un rôle.
- Pourquoi une précision identique ne suffit-elle pas à prouver qu'on a reconstruit le même modèle ? Quel critère avez-vous utilisé, et pourquoi est-il suffisant pour une régression logistique ?
- Classez les six erreurs de l'étape 3 selon les cinq entrées du chapitre 28. Pour chacune, quel artefact versionné l'aurait évitée ?
- La note de Claire disait
C=10, le modèle ditC=5. Quelle règle générale en tirez-vous sur les sources de vérité d'un projet de ML ? - Expliquez l'écart entre 94 % (évaluation de Claire) et 86 % (découpage temporel). Laquelle des deux faut-il annoncer, et pourquoi ?
- Le modèle livré était inutilisable sans le vectoriseur. Reliez ce défaut au décalage entre entraînement et service du chapitre 27, et proposez la correction.