Observer Listify en production : métriques, tableau de bord, alerte
Ce que vous allez construire
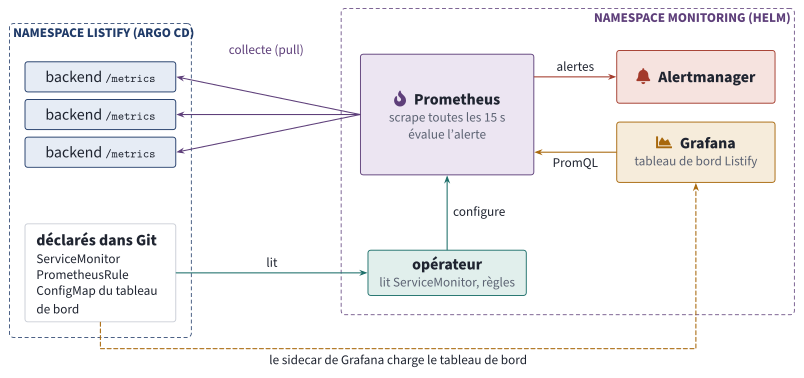
Ce que vous allez construire. La pile de supervision est installée une fois, par Helm ; tout ce qui concerne Listify (quoi collecter, quand alerter, quoi afficher) est déclaré dans le dépôt de configuration et déployé par Argo CD, comme le reste de l'application.
PDF vectorielLe principe est celui de tout le bloc : la supervision de Listify devient du code, relu, versionné et déployé par GitOps. Personne ne clique dans Grafana pour créer un tableau de bord qui disparaîtrait avec le cluster.
Étape 0 : ressources et ports (10 min)
La pile kube-prometheus-stack ajoute environ 1,5 Go de mémoire au cluster. Vérifiez que vous disposez d'au moins 4 Go libres (free -g), et arrêtez tout ce qui ne sert pas.
Le TP ouvre trois tunnels port-forward vers votre poste. Les ports ont été choisis pour éviter les conflits courants :
| Interface | Port sur votre poste | Remarque |
|---|---|---|
| Grafana | 3001 | |
| Prometheus | 9091 | et non 9090, occupé sur beaucoup de postes par Cockpit, l'outil d'administration web de Linux (c'était le cas sur le poste de validation) |
| Alertmanager | 9093 |
Étape 1 : instrumenter Listify (1 h)
1.1 Le code
Ajoutez la bibliothèque officielle au backend, avec sa version épinglée :
flask==3.0.3
gunicorn==22.0.0
psycopg2-binary==2.9.11
prometheus-client==0.26.0
Puis, en tête de backend/app.py, les métriques et leur exposition. Le reste du fichier ne change pas :
"""Listify : API REST minimale de gestion de tâches (v1.1 : tâches terminées)."""
import os
import time

import psycopg2
import psycopg2.extras
from flask import Flask, g, jsonify, request
from prometheus_client import (
    CONTENT_TYPE_LATEST,
    REGISTRY,
    CollectorRegistry,
    Counter,
    Histogram,
    generate_latest,
    multiprocess,
)

app = Flask(__name__)

# ---------- Métriques Prometheus (TP 21) ----------
REQUESTS = Counter(
    "listify_http_requests_total", "Requêtes HTTP traitées",
    ["method", "route", "status"],
)
LATENCY = Histogram(
    "listify_http_request_duration_seconds", "Durée de traitement des requêtes",
    ["route"], buckets=(0.05, 0.1, 0.25, 0.5, 1, 2.5),
)


@app.before_request
def _start_timer():
    g.start = time.perf_counter()


@app.after_request
def _record(response):
    # le modèle de route (/api/tasks/<int:task_id>), pas le chemin réel : cardinalité bornée
    route = request.url_rule.rule if request.url_rule else "non_trouvee"
    if route != "/metrics":
        REQUESTS.labels(request.method, route, str(response.status_code)).inc()
        LATENCY.labels(route).observe(time.perf_counter() - g.start)
    return response


@app.get("/metrics")
def metrics():
    if "PROMETHEUS_MULTIPROC_DIR" in os.environ:
        # Sous Gunicorn : chaque worker écrit ses valeurs dans des fichiers,
        # on agrège ici les fichiers de TOUS les workers.
        registry = CollectorRegistry()
        multiprocess.MultiProcessCollector(registry)
    else:
        registry = REGISTRY
    return generate_latest(registry), 200, {"Content-Type": CONTENT_TYPE_LATEST}
C'est le code du chapitre 26, §7, avec deux précisions. L'étiquette route prend le modèle de route (/api/tasks/<int:task_id>), jamais le chemin réel, pour que la cardinalité reste bornée (ch. 26, §5.4). Les requêtes de Prometheus sur /metrics ne sont pas comptées, pour que la mesure ne se mesure pas elle-même.
Ajoutez un test unitaire à la fin de backend/tests/test_api.py :
def test_metrics_count_requests(client):
    client.post("/api/tasks", json={"title": ""})          # une requête 400
    body = client.get("/metrics").get_data(as_text=True)
    assert 'listify_http_requests_total{method="POST",route="/api/tasks",status="400"}' in body
    assert "listify_http_request_duration_seconds_bucket" in body
1.2 Le piège de Gunicorn, vu en vrai
Le chapitre 26 annonçait qu'avec plusieurs workers, chaque processus garde ses propres compteurs. Vérifiez-le avant de le corriger. Depuis votre environnement virtuel du TP 19 :
cd ~/Github/edu/listify/backend
. ../.venv/bin/activate
pip install -r requirements.txt
gunicorn --workers 3 --bind 127.0.0.1:18000 wsgi:app &
for i in $(seq 30); do
  curl -s -o /dev/null -X POST -H 'Content-Type: application/json' -d '{"title":""}' http://127.0.0.1:18000/api/tasks
done
for i in 1 2 3 4 5 6; do
  curl -s http://127.0.0.1:18000/metrics | grep '^listify_http_requests_total{method="POST"' | awk '{print $2}'
done
kill %1
Trente requêtes ont été envoyées. Lors de la validation, les six lectures successives de /metrics ont affiché : 15 1 1 15 15 15. Chaque lecture est traitée par un worker au hasard, qui ne connaît que les requêtes qu'il a lui-même servies ; Gunicorn ne répartit d'ailleurs pas la charge équitablement, d'où ce 15 et ce 1. Une courbe Prometheus construite là-dessus serait du bruit.
1.3 Le mode multiprocessus
prometheus_client résout le problème en faisant écrire à chaque worker ses valeurs dans des fichiers d'un répertoire partagé, que /metrics agrège (c'est la branche PROMETHEUS_MULTIPROC_DIR de la fonction metrics). Il faut que ce répertoire existe et soit vide au démarrage, et qu'on oublie les workers morts : c'est le rôle de deux crochets de Gunicorn, dans son fichier de configuration.
"""Configuration de Gunicorn (TP 21) : 3 workers et métriques multiprocessus."""
import os
import shutil

from prometheus_client import multiprocess

bind = "0.0.0.0:8000"
workers = 3

# Répertoire partagé par les workers pour leurs métriques (défini dans le Containerfile)
METRICS_DIR = os.environ.get("PROMETHEUS_MULTIPROC_DIR")


def on_starting(server):
    # Le répertoire doit exister et être VIDE au démarrage du master.
    if METRICS_DIR:
        shutil.rmtree(METRICS_DIR, ignore_errors=True)
        os.makedirs(METRICS_DIR)


def child_exit(server, worker):
    # Un worker meurt : ses fichiers de métriques « vivantes » ne doivent plus compter.
    if METRICS_DIR:
        multiprocess.mark_process_dead(worker.pid)
Gunicorn lit automatiquement un fichier gunicorn.conf.py placé dans le dossier courant. C'est pourquoi le code ne fait rien si la variable n'est pas définie : sans cette précaution, la moindre commande gunicorn lancée dans backend/ plantait lors de la validation (KeyError: 'PROMETHEUS_MULTIPROC_DIR'). Refaites l'expérience avec la variable :
export PROMETHEUS_MULTIPROC_DIR=/tmp/listify-metrics
gunicorn --config gunicorn.conf.py --bind 127.0.0.1:18000 wsgi:app &
# ... mêmes 30 requêtes et 6 lectures que ci-dessus ...
kill %1; unset PROMETHEUS_MULTIPROC_DIR
Résultat de la validation : 30 30 30 30 30 30. Le répertoire contient un fichier par worker et par type de métrique (counter_<pid>.db, histogram_<pid>.db).
Enfin, l'image : la variable est fixée dans le Containerfile, et Gunicorn prend sa configuration dans le fichier.
FROM python:3.12-slim

# Un utilisateur non-root (moindre privilège, ch. 17 §4.2)
RUN useradd --system --no-create-home --shell /usr/sbin/nologin listify

WORKDIR /app

# Dépendances AVANT le code : le cache de build (ch. 17 §2)
COPY requirements.txt .
RUN pip install --no-cache-dir -r requirements.txt

# Le code applicatif ensuite
COPY app.py wsgi.py gunicorn.conf.py ./

# Métriques Prometheus partagées entre les workers de Gunicorn (TP 21)
ENV PROMETHEUS_MULTIPROC_DIR=/tmp/prometheus

# Exécution en non-root, sur toutes les interfaces DU CONTENEUR
USER listify
EXPOSE 8000
CMD ["gunicorn", "--config", "gunicorn.conf.py", "wsgi:app"]
1.4 Livrer
cd ~/Github/edu/listify
pytest -m "not integration" backend -q      # 4 passed
git add -A && git commit -m "Backend : métriques Prometheus (mode multiprocessus Gunicorn)"
git push forge main
Vous ne déployez rien vous-même : le pipeline du TP 20 construit, scanne et commit le nouveau tag, Argo CD déploie. Pendant ce temps, installez la pile de supervision.
Étape 2 : la pile kube-prometheus-stack (40 min)
Ce chart Helm installe, en une commande, tout ce que décrit le chapitre 26 : l'opérateur Prometheus, un serveur Prometheus, Alertmanager, Grafana déjà relié à Prometheus, kube-state-metrics (l'état des objets Kubernetes) et node-exporter (les métriques des nœuds), ainsi que des dizaines de tableaux de bord et de règles d'alerte pour le cluster lui-même.
# Valeurs de kube-prometheus-stack pour le TP 21 (le reste : valeurs par défaut du chart)
prometheus:
  prometheusSpec:
    # Surveiller TOUS les ServiceMonitor et PrometheusRule du cluster,
    # pas seulement ceux qui portent l'étiquette de cette installation Helm
    serviceMonitorSelectorNilUsesHelmValues: false
    ruleSelectorNilUsesHelmValues: false
    retention: 2d            # un poste de TP n'a pas besoin de semaines d'historique

grafana:
  adminPassword: grafana-tp21
  sidecar:
    dashboards:
      searchNamespace: ALL   # charger les tableaux de bord déclarés dans n'importe quel namespace
Les deux lignes de prometheusSpec sont essentielles. Par défaut, le Prometheus installé par ce chart ne surveille que les ServiceMonitor et les règles qui portent l'étiquette de sa propre installation Helm ; ceux de Listify, déployés par Argo CD, seraient ignorés en silence.
helm repo add prometheus-community https://prometheus-community.github.io/helm-charts
helm repo update
helm install monitoring prometheus-community/kube-prometheus-stack --version 91.4.1 \
  --namespace monitoring --create-namespace -f ~/forge/monitoring-values.yaml
kubectl -n monitoring get pods --watch        # six pods Running, en quelques minutes
Pourquoi Helm et non Argo CD, cette fois ? La pile de supervision est une infrastructure partagée du cluster, installée une fois et rarement modifiée, alors que Listify change à chaque commit. Le bonus 3 la place elle aussi sous Argo CD, ce qu'on ferait en entreprise.
Ouvrez les deux interfaces, chacune dans son terminal :
kubectl -n monitoring port-forward service/monitoring-kube-prometheus-prometheus 9091:9090
kubectl -n monitoring port-forward service/monitoring-grafana 3001:80
# Prometheus : http://localhost:9091   Grafana : http://localhost:3001 (admin / grafana-tp21)
Dans Grafana, le menu Dashboards propose déjà des tableaux de bord du cluster (nœuds, pods, API server) : explorez « Kubernetes / Compute Resources / Namespace (Pods) » pour le namespace listify.
Étape 3 : dire à Prometheus de collecter Listify (30 min)
Prometheus ne connaît pas Listify. On le lui déclare par un ServiceMonitor, un objet de l'opérateur qui décrit quels Services collecter (ch. 26, §7). Il rejoint le chart, dans le dépôt de configuration :
# Dit à Prometheus quoi collecter : les Services étiquetés backend de Listify,
# sur leur port nommé « http », au chemin /metrics, toutes les 15 secondes.
apiVersion: monitoring.coreos.com/v1
kind: ServiceMonitor
metadata:
  name: listify-backend
spec:
  selector:
    matchLabels: { app: listify, tier: backend }
  endpoints:
    - port: http
      path: /metrics
      interval: 15s
Le sélecteur désigne le Service backend, qui porte depuis le TP 20 les étiquettes app: listify et tier: backend et un port nommé http : c'est pour cela qu'on les avait prévus.
cd ~/Github/edu/listify-config
git pull --rebase                  # la CI commit aussi dans ce dépôt : toujours récupérer avant de pousser
git add chart/templates/servicemonitor.yaml
git commit -m "Supervision : ServiceMonitor de Listify"
git push
kubectl -n argocd annotate application listify argocd.argoproj.io/refresh=normal --overwrite
Dans Prometheus, menu Status, Targets (ou Target health) : une section serviceMonitor/listify/listify-backend apparaît, avec vos trois pods.
Point de contrôle n° 1 : trois cibles « up »
- Les trois pods backend sont
updans la page des cibles. - Dans l'onglet Query de Prometheus,
listify_http_requests_totalrenvoie des séries, avec les étiquettesmethod,route,statuset celles ajoutées par Prometheus (namespace,pod,instance...). - Au runbook : pourquoi les requêtes
/api/healthsont-elles déjà nombreuses alors que personne n'utilise l'application ? (Indice : ch. 22.)
Étape 4 : interroger avec PromQL (45 min)
Il faut du trafic. Lancez un pod qui interroge Listify sans relâche, par l'intermédiaire du frontend, comme un navigateur :
kubectl -n listify run charge --image=docker.io/curlimages/curl:8.10.1 --restart=Never -- sh -c \
  'while true; do
     curl -s -o /dev/null http://frontend/api/tasks
     curl -s -o /dev/null -X POST -H "Content-Type: application/json" -d "{\"title\":\"\"}" http://frontend/api/tasks
     sleep 0.2
   done'
Chaque tour envoie une lecture (réponse 200) et une création au titre vide (réponse 400, rejetée par la validation). Argo CD n'y touchera pas : ce pod n'est pas décrit dans Git, il n'appartient donc pas à l'application.
Attendez une minute, puis exécutez ces requêtes dans l'onglet Query de Prometheus, en mode Graph :
# Débit par route et par statut, hors sondes de Kubernetes
sum by (route, status) (rate(listify_http_requests_total{route!="/api/health"}[1m]))

# Latence p95 par route (ch. 26, §6.4)
histogram_quantile(0.95, sum by (le, route) (rate(listify_http_request_duration_seconds_bucket{route!="/api/health"}[1m])))

# Taux d'erreurs des requêtes des utilisateurs
  sum(rate(listify_http_requests_total{route!="/api/health", status=~"5.."}[1m]))
/ sum(rate(listify_http_requests_total{route!="/api/health"}[1m]))
Lors de la validation, le débit était d'environ 4,1 requêtes par seconde en 200 et 4,3 en 400, et la latence p95 de 47,5 ms. Et la troisième requête a renvoyé... un résultat vide, pas zéro.
C'est une subtilité de PromQL qui piège tout le monde : tant qu'aucune réponse 5xx n'a jamais eu lieu, la série des erreurs n'existe pas, la somme d'un ensemble vide est vide, et diviser le vide par un nombre donne le vide. Pour afficher 0, on complète par un vecteur constant :
  (sum(rate(listify_http_requests_total{route!="/api/health", status=~"5.."}[1m])) or vector(0))
/ sum(rate(listify_http_requests_total{route!="/api/health"}[1m]))
Pourquoi exclure /api/health ? Parce que les sondes de Kubernetes l'interrogent toutes les 5 secondes sur chaque pod : ce trafic ne vient pas des utilisateurs, et il noierait le signal. Un SLI mesure ce que vivent les utilisateurs (ch. 26, §9).
Point de contrôle n° 2 : calculer, puis vérifier
- Prenez la valeur brute d'un compteur à deux instants (onglet Table, en changeant l'heure d'évaluation), et calculez le débit à la main comme au chapitre 26, §6.2. Comparez au résultat de
rate(). - Pourquoi le taux d'erreurs vaut-il 0 alors que la moitié des requêtes reçoivent un code 400 ? Est-ce le bon choix ?
- Notez les trois requêtes au runbook, avec leur valeur.
Étape 5 : le tableau de bord, versionné (40 min)
Plutôt que de dessiner un tableau de bord à la souris, on le déclare. Le Grafana de kube-prometheus-stack embarque un sidecar, un conteneur annexe (ch. 18) qui surveille les ConfigMap portant l'étiquette grafana_dashboard et charge leur contenu comme tableau de bord. Le fichier JSON du tableau de bord rejoint le chart :
# Tableau de bord Grafana, versionné et déployé comme le reste :
# le « sidecar » de Grafana charge tout ConfigMap portant l'étiquette grafana_dashboard.
apiVersion: v1
kind: ConfigMap
metadata:
  name: listify-dashboard
  labels:
    grafana_dashboard: "1"
data:
  listify.json: |-
{{ .Files.Get "dashboards/listify.json" | indent 4 }}
Le fichier complet chart/dashboards/listify.json (4 panneaux)
{
  "title": "Listify",
  "uid": "listify",
  "schemaVersion": 39,
  "refresh": "10s",
  "time": {
    "from": "now-30m",
    "to": "now"
  },
  "tags": [
    "listify"
  ],
  "panels": [
    {
      "id": 1,
      "type": "timeseries",
      "title": "Débit par route (requêtes/s)",
      "datasource": {
        "type": "prometheus",
        "uid": "prometheus"
      },
      "gridPos": {
        "x": 0,
        "y": 0,
        "w": 12,
        "h": 8
      },
      "fieldConfig": {
        "defaults": {
          "unit": "reqps"
        },
        "overrides": []
      },
      "targets": [
        {
          "refId": "A",
          "datasource": {
            "type": "prometheus",
            "uid": "prometheus"
          },
          "expr": "sum by (route) (rate(listify_http_requests_total{route!=\"/api/health\"}[1m]))",
          "legendFormat": "{{route}}"
        }
      ]
    },
    {
      "id": 2,
      "type": "timeseries",
      "title": "Taux d'erreurs (requêtes des utilisateurs)",
      "datasource": {
        "type": "prometheus",
        "uid": "prometheus"
      },
      "gridPos": {
        "x": 12,
        "y": 0,
        "w": 12,
        "h": 8
      },
      "fieldConfig": {
        "defaults": {
          "unit": "percentunit"
        },
        "overrides": []
      },
      "targets": [
        {
          "refId": "A",
          "datasource": {
            "type": "prometheus",
            "uid": "prometheus"
          },
          "expr": "(sum(rate(listify_http_requests_total{route!=\"/api/health\", status=~\"5..\"}[1m])) or vector(0)) / sum(rate(listify_http_requests_total{route!=\"/api/health\"}[1m]))",
          "legendFormat": "erreurs"
        }
      ]
    },
    {
      "id": 3,
      "type": "timeseries",
      "title": "Latence p95 par route",
      "datasource": {
        "type": "prometheus",
        "uid": "prometheus"
      },
      "gridPos": {
        "x": 0,
        "y": 8,
        "w": 12,
        "h": 8
      },
      "fieldConfig": {
        "defaults": {
          "unit": "s"
        },
        "overrides": []
      },
      "targets": [
        {
          "refId": "A",
          "datasource": {
            "type": "prometheus",
            "uid": "prometheus"
          },
          "expr": "histogram_quantile(0.95, sum by (le, route) (rate(listify_http_request_duration_seconds_bucket{route!=\"/api/health\"}[1m])))",
          "legendFormat": "{{route}}"
        }
      ]
    },
    {
      "id": 4,
      "type": "timeseries",
      "title": "Pods backend prêts",
      "datasource": {
        "type": "prometheus",
        "uid": "prometheus"
      },
      "gridPos": {
        "x": 12,
        "y": 8,
        "w": 12,
        "h": 8
      },
      "fieldConfig": {
        "defaults": {
          "unit": "none"
        },
        "overrides": []
      },
      "targets": [
        {
          "refId": "A",
          "datasource": {
            "type": "prometheus",
            "uid": "prometheus"
          },
          "expr": "sum(kube_pod_status_ready{namespace=\"listify\", pod=~\"backend-.*\", condition=\"true\"})",
          "legendFormat": "prêts"
        }
      ]
    }
  ]
}
Les quatre panneaux suivent la méthode RED en haut (débit, erreurs) et la durée et les ressources en bas (ch. 26, §10). Le taux d'erreurs utilise or vector(0), découvert à l'étape précédente. Le dernier panneau vient de kube-state-metrics, installé avec la pile : c'est ce que Kubernetes pense de la santé du backend. Gardez-le à l'œil, il jouera un rôle à l'étape suivante.
cd ~/Github/edu/listify-config
git pull --rebase
git add chart/templates/dashboard.yaml chart/dashboards/listify.json
git commit -m "Supervision : tableau de bord Listify"
git push
kubectl -n argocd annotate application listify argocd.argoproj.io/refresh=normal --overwrite
Dans Grafana, menu Dashboards : un tableau de bord « Listify » est apparu tout seul, en quelques secondes. Si le cluster était reconstruit, il réapparaîtrait avec le reste : c'est du code.
Étape 6 : l'alerte, et un incident que Kubernetes ne voit pas (1 h)
6.1 La règle
# Alerte sur un SYMPTÔME (ch. 26, §8.2) : la part de requêtes des utilisateurs en erreur.
# On exclut /api/health : ces requêtes viennent des sondes de Kubernetes, pas des utilisateurs.
apiVersion: monitoring.coreos.com/v1
kind: PrometheusRule
metadata:
  name: listify
spec:
  groups:
    - name: listify
      rules:
        - alert: ListifyTauxErreursEleve
          expr: |
            sum(rate(listify_http_requests_total{route!="/api/health", status=~"5.."}[2m]))
              /
            sum(rate(listify_http_requests_total{route!="/api/health"}[2m]))
              > 0.05
          for: 2m
          labels:
            severity: critical
          annotations:
            summary: "Plus de 5 % des requêtes des utilisateurs de Listify échouent"
            description: "Taux d'erreurs actuel : {{`{{ $value | humanizePercentage }}`}}"
C'est l'alerte du chapitre 26, §8.1, sur un symptôme : la part de requêtes des utilisateurs en erreur. Trois remarques :
- la fenêtre
[2m]et la clausefor: 2msont courtes pour qu'on voie l'alerte vivre pendant la séance ; en production, on les allongerait ou on passerait à une alerte sur le taux de consommation du budget d'erreur (ch. 26, §9.3) ; - l'expression de l'annotation est entourée de
{{`et`}}: ce fichier est un template Helm, qui interpréterait sinon lui-même les doubles accolades destinées à Prometheus ; - dans un bloc YAML
|, c'est la première ligne qui fixe l'indentation. Une ligne moins indentée casse tout le fichier : lors de la validation,helm linta refusé une première version où l'opérateur/était décalé vers la gauche (did not find expected key).
Commitez et poussez comme aux étapes précédentes, puis vérifiez dans Prometheus, menu Alerts : ListifyTauxErreursEleve est présente, à l'état inactive.
6.2 L'incident
Laissez tourner le pod de charge et ouvrez le tableau de bord Grafana. Simulez maintenant une migration ratée, qui renomme la table des tâches :
kubectl -n listify exec db-0 -- psql -U listify -d listify -c 'ALTER TABLE tasks RENAME TO tasks_ancienne;'
Observez, sans rien toucher, et relevez l'heure de chaque événement. Voici la chronologie mesurée lors de la validation :
| Instant | Événement |
|---|---|
| 13:50:22 | La table est renommée : toute lecture de /api/tasks renvoie désormais 500 |
| 13:50:42 | Le taux d'erreurs mesuré dépasse 12 % et grimpe (la fenêtre rate se remplit) |
| 13:50:54 | L'alerte passe pending : la condition est vraie, le délai for commence |
| 13:51:22 | Le taux d'erreurs se stabilise autour de 50 % |
| 13:53:03 | L'alerte passe firing (deux minutes après pending) et part vers Alertmanager |
Pourquoi 50 % et non 100 % ? Parce que les créations au titre vide sont rejetées avant tout accès à la base (réponse 400, qui n'est pas une erreur du serveur) ; seules les lectures échouent. Vérifiez qu'Alertmanager a bien reçu l'alerte :
kubectl -n monitoring port-forward service/monitoring-kube-prometheus-alertmanager 9093:9093
# autre terminal :
curl -s http://localhost:9093/api/v2/alerts | jq '.[] | {etat: .status.state, gravite: .labels.severity, resume: .annotations.summary}'
Et regardez maintenant ce que Kubernetes pense de la situation :
kubectl -n listify get pods -l tier=backend
Les trois pods sont 1/1 Running, parfaitement « prêts ». Le panneau « Pods backend prêts » est resté plat à 3 pendant tout l'incident. La sonde de disponibilité interroge /api/health, qui exécute SELECT 1 : la base répond, donc tout va bien du point de vue de Kubernetes. Seule l'observabilité a vu que les utilisateurs ne pouvaient plus lire leurs tâches.
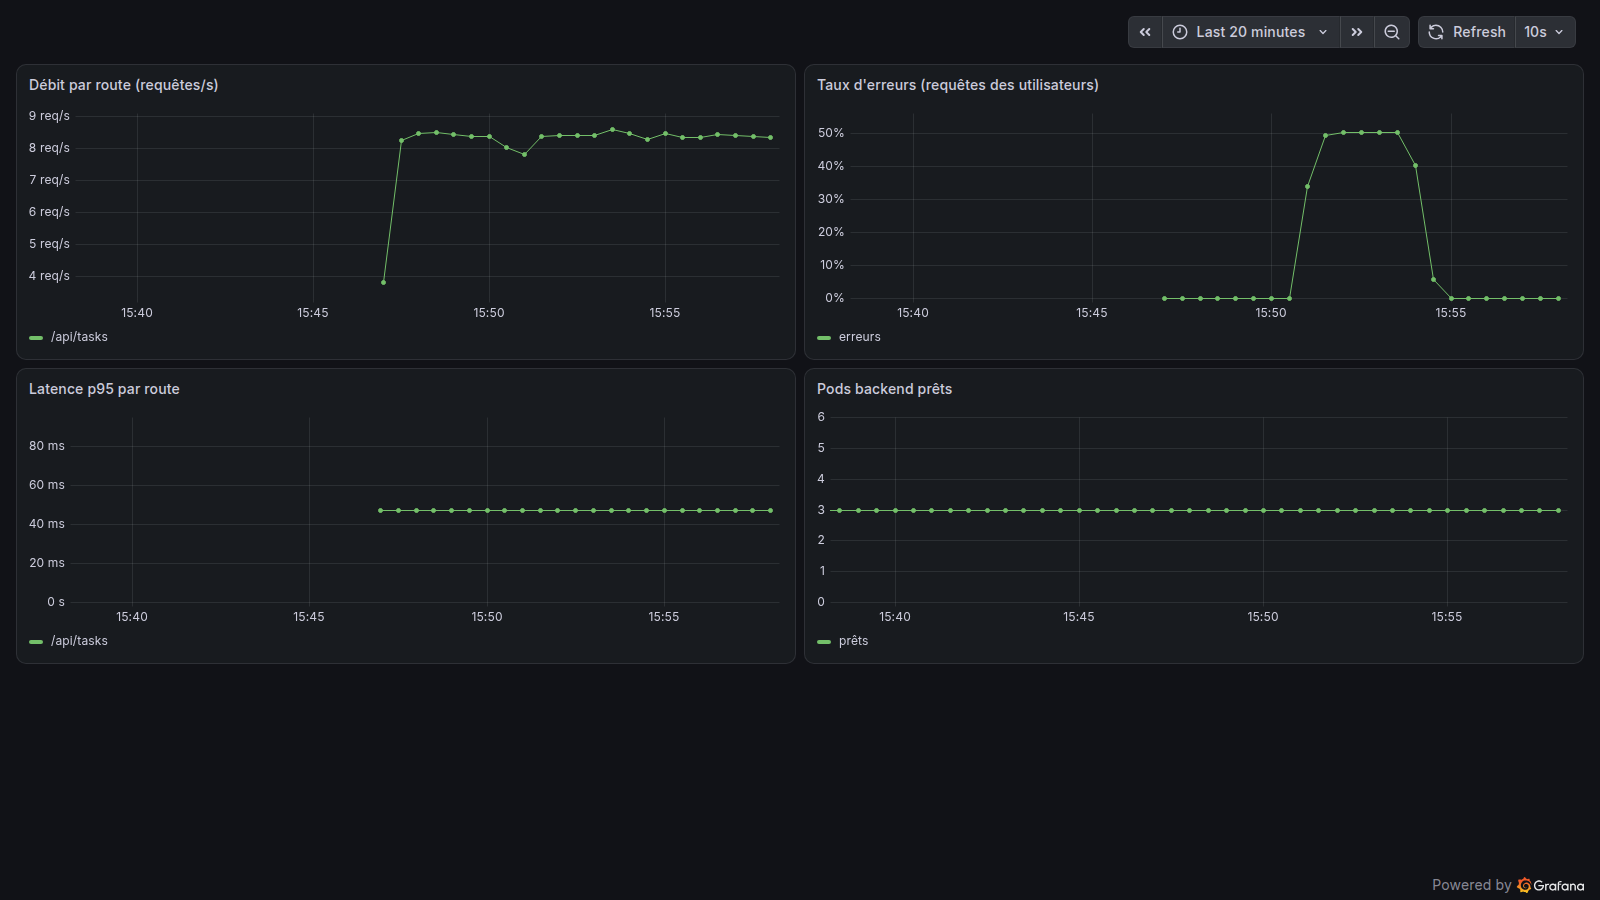
Le tableau de bord pendant l'incident, capture réelle de la validation du TP. Le taux d'erreurs grimpe à 50 % puis redescend après la réparation ; la courbe des pods prêts ne bouge pas.
6.3 Réparer, et regarder l'alerte se résoudre
kubectl -n listify exec db-0 -- psql -U listify -d listify -c 'ALTER TABLE tasks_ancienne RENAME TO tasks;'
Lors de la validation, réparation à 13:53:46 et retour de l'alerte à l'état inactive à 13:55:57 : un peu plus de deux minutes, le temps que la fenêtre [2m] du rate ne contienne plus d'erreurs. Arrêtez ensuite le pod de charge : kubectl -n listify delete pod charge.
Point de contrôle n° 3 : le compte rendu d'incident
Rédigez au runbook un court compte rendu d'incident, au format d'un postmortem sans reproche : chronologie (vos heures), impact (quelle part des requêtes, pendant combien de temps), détection (qui a vu quoi, et pourquoi Kubernetes n'a rien vu), résolution, et une action pour que cela ne se reproduise pas (par exemple : une sonde qui vérifie aussi l'existence de la table, ou une migration testée en préproduction).
Étape 7 : ce que l'incident a coûté (20 min)
Reprenez le SLO du chapitre 26 : 99,9 % des requêtes des utilisateurs réussies sur 30 jours. Combien de budget d'erreur l'incident a-t-il consommé ? Prometheus compte les requêtes sur une période avec increase() :
sum(increase(listify_http_requests_total{route!="/api/health", status=~"5.."}[30m]))
sum(increase(listify_http_requests_total{route!="/api/health"}[30m]))
Lors de la validation, sur une fenêtre de 30 minutes contenant l'incident : environ 862 requêtes en erreur sur 6 241. Deux remarques. Les valeurs ne sont pas entières (861,54 par exemple) : increase() extrapole à partir des points collectés toutes les 15 secondes, c'est une estimation. Et le taux d'erreurs de la fenêtre, 862 / 6 241, soit environ 13,8 %, dépasse à lui seul de très loin les 0,1 % autorisés : rapporté à un mois de ce trafic (8 requêtes par seconde, soit environ 20,7 millions de requêtes), le budget vaut environ 20 700 requêtes en erreur, et cet incident de trois minutes et demie en a consommé à peu près 4 %. Faites le calcul avec vos propres chiffres.
Étape 8 : fin du bloc et du semestre (15 min)
C'est le dernier TP du semestre 2. Avant de tout arrêter, notez au runbook la procédure complète de reconstruction de votre production locale, dans l'ordre (TP 19, TP 20, puis TP 21), et vérifiez qu'elle tient en une page : c'est la preuve que votre infrastructure est du code.
Pour libérer le poste :
export KIND_EXPERIMENTAL_PROVIDER=podman
systemd-run --user --scope --property=Delegate=yes kind delete cluster --name listify
podman stop act-runner gitea            # la forge garde ses données dans ses volumes
La forge, ses dépôts, ses images et le runner resteront utiles au semestre 3 : ne supprimez pas leurs volumes.
Point de contrôle final
-
/metricscompte juste sous Gunicorn (démonstration 15/1/1 puis 30/30/30 au runbook) - kube-prometheus-stack installé ; Grafana et Prometheus accessibles
- ServiceMonitor, règle d'alerte et tableau de bord dans
listify-config, déployés par Argo CD - Trois cibles
up; requêtes PromQL de débit, de latence et d'erreurs, avecor vector(0)compris - Incident provoqué : alerte pending puis firing, reçue par Alertmanager, puis résolue
- Compte rendu d'incident et calcul du budget consommé au runbook
Banque de pannes du TP 21 (réservé enseignant : ne lisez pas si vous jouez le jeu)
| Symptôme | Cause | Remède | Origine |
|---|---|---|---|
| Les compteurs sautent d'une lecture à l'autre (15, 1, 1, 15...) | Mode multiprocessus absent : chaque worker a ses compteurs | PROMETHEUS_MULTIPROC_DIR et gunicorn.conf.py | vécue |
KeyError: 'PROMETHEUS_MULTIPROC_DIR' au lancement de gunicorn | gunicorn.conf.py lu automatiquement, variable absente | Crochets qui ne font rien sans la variable | vécue |
port-forward vers 9090 : une page « Loading... » qui n'est pas Prometheus | Port 9090 occupé par Cockpit | Utiliser 9091 | vécue |
Cibles down, 404 NOT FOUND | Ancienne image sans /metrics encore déployée | Attendre le déploiement, vérifier le tag | vécue |
| Taux d'erreurs vide (« No data ») au lieu de 0 | Aucune série 5xx n'existe encore | or vector(0) | vécue |
git push refusé dans listify-config | La CI a commité entre-temps | git pull --rebase avant de pousser | vécue |
helm lint : did not find expected key sur la règle | Indentation du bloc expr: | | Indentation uniforme | vécue |
| Aucune cible Listify dans Prometheus | serviceMonitorSelectorNilUsesHelmValues laissé à sa valeur par défaut | Valeurs de l'étape 2, puis helm upgrade | prévisible |
Argo CD en erreur sur ServiceMonitor : type inconnu | Pile de supervision absente (cluster recréé sans elle) : le type n'existe pas | Installer kube-prometheus-stack avant | prévisible |
| Tableau de bord absent de Grafana | Étiquette grafana_dashboard manquante ou searchNamespace non réglé | Valeurs de l'étape 2 | prévisible |
Panne à injecter en temps limité : pendant la charge, supprimer la clause route!="/api/health" de la règle et renommer la table. L'alerte se déclenche-t-elle encore ? Plus tard, plus tôt ? Faire justifier par le poids relatif du trafic des sondes.
Pour aller plus loin (bonus)
- Recevoir l'alerte. Configurez dans Alertmanager un récepteur de type webhook vers un petit serveur local (par exemple
python3 -m http.serverne suffit pas, il refuse les POST : écrivez-en un de dix lignes), et affichez la charge utile JSON reçue. - Alerter sur le budget. Remplacez la règle par une alerte sur le taux de consommation du budget d'erreur, sur deux fenêtres (1 h et 5 min), comme le propose le Site Reliability Workbook (ch. 26, §9.3). Quel seuil pour un SLO de 99,9 % ?
- La supervision sous Argo CD. Créez une Application Argo CD qui installe kube-prometheus-stack à partir de son dépôt Helm, avec vos valeurs dans
listify-config. L'étape 2 disparaît de la procédure de reconstruction. - Une meilleure sonde. Faites échouer
/api/healthquand la tabletasksmanque. Rejouez l'incident : que fait maintenant Kubernetes, et est-ce souhaitable ? (Pensez à ce que deviennent les requêtes quand tous les pods sont retirés du Service.)
Questions de compréhension (à préparer pour le TD et l'examen)
- Pendant l'incident, Kubernetes considérait les pods comme prêts. Expliquez pourquoi, et pourquoi c'est à la fois une limite de la sonde et une propriété voulue.
- Pourquoi Prometheus tire-t-il les métriques ? Qu'aurait-on perdu, dans ce TP, avec un modèle où l'application pousse ses métriques ?
- Justifiez l'exclusion de
/api/healthdu taux d'erreurs. Dans quel cas voudrait-on au contraire surveiller cette route ? - Pourquoi
sum(rate(...))et jamaisrate(sum(...))? (Indice : ch. 26, §6.2, et les redémarrages de pods.) - L'alerte est passée firing plus de deux minutes et demie après le début de l'incident, et s'est résolue deux minutes après la réparation. D'où viennent ces délais, et comment les réduire ? Qu'y perdrait-on ?
- Le tableau de bord et l'alerte sont dans Git. Citez deux avantages concrets par rapport à un tableau de bord créé à la main dans Grafana.