Bloc 3 : CI/CD et observabilité
Semaines 11 à 14. À la fin du bloc 2, Listify tourne sur un cluster Kubernetes, décrit par des manifests et packagé en chart Helm. Mais regardez honnêtement le chemin qui mène d'une modification du code à sa mise en production : vous reconstruisez l'image à la main, vous changez le tag dans un fichier, vous lancez kubectl apply ou helm upgrade depuis votre poste, et vous vérifiez à l'œil que « ça a l'air de marcher ». Chaque étape est une occasion d'oubli, et la dernière n'est pas une vérification du tout. Ce bloc automatise ce chemin de bout en bout, puis donne des yeux au système en production.
Deux questions, un seul bloc
Le bloc répond à deux questions complémentaires, qu'une équipe mature se pose en permanence :
- Comment une modification arrive-t-elle en production, de façon sûre et répétable ? C'est l'objet de l'intégration continue (ch. 23), de la livraison et du déploiement continus (ch. 24) et du GitOps (ch. 25).
- Comment sait-on que la production va bien, et que la dernière modification ne l'a pas dégradée ? C'est l'objet de l'observabilité (ch. 26).
Les deux sont indissociables. Déployer vite sans observer, c'est conduire vite dans le brouillard ; observer finement un système qu'on ne sait pas corriger rapidement, c'est regarder l'accident sans pouvoir freiner. La recherche empirique menée par le programme DORA sur des dizaines de milliers d'équipes montre d'ailleurs que la fréquence de déploiement et la capacité à rétablir le service vont ensemble chez les équipes les plus performantes, au lieu de s'opposer 1.
Le fil conducteur : l'état désiré, une troisième fois
Vous retrouverez l'idée centrale du parcours sous une forme nouvelle. Au S1, Ansible et Terraform faisaient converger des machines vers un état décrit dans des fichiers ; au bloc 2, Kubernetes faisait converger un cluster vers les manifests appliqués. Le GitOps (ch. 25) pousse la logique jusqu'au bout : l'état désiré de toute la production vit dans un dépôt Git, et un agent dans le cluster réconcilie en continu la réalité avec ce dépôt. Le kubectl apply manuel disparaît ; il ne reste que des commits relus.
L'architecture cible du bloc
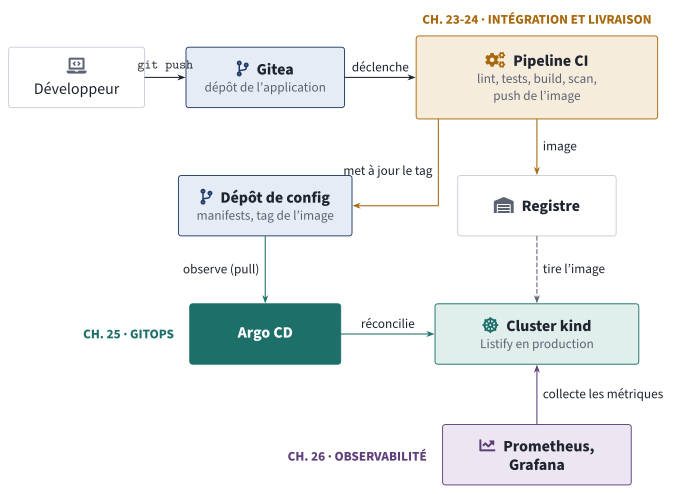
L'architecture cible du bloc. Un git push suffit à produire une image vérifiée, à la déployer par réconciliation et à la placer sous surveillance ; aucune commande n'est plus tapée à la main contre la production.
À la fin du bloc, un commit sur la branche principale de Listify part en production locale sans intervention humaine, et un tableau de bord Grafana montre en direct le trafic, le taux d'erreurs et la latence de l'application, avec une alerte qui se déclenche quand le taux d'erreurs dépasse un seuil.
Organisation du bloc
| Semaine | CM | TP |
|---|---|---|
| 11 | Ch. 23 : L'intégration continue | TP 19 : forge locale Gitea, runner, premier pipeline (lint et tests) |
| 12 | Ch. 24 : Livraison et déploiement continus | TP 20 (partie A) : pipeline complet, build, push, scan, commit du tag |
| 13 | Ch. 25 : GitOps | TP 20 (partie B) : Argo CD, un commit met à jour la production |
| 14 | Ch. 26 : Observabilité | TP 21 : Prometheus, Grafana et une alerte sur le taux d'erreurs |
Ce que vous saurez faire à la fin du bloc
- Expliquer pourquoi l'intégration fréquente réduit le risque, et concevoir un pipeline dont l'ordre des étapes minimise le temps de retour.
- Définir rigoureusement intégration, livraison et déploiement continus, et justifier le choix entre les deux derniers pour un contexte donné.
- Versionner des artefacts (SemVer, tags, digests), les promouvoir d'un environnement à l'autre sans les reconstruire, et argumenter le choix d'une stratégie de branches.
- Comparer les stratégies de déploiement (rolling, blue-green, canary) selon le risque, le coût et la vitesse de retour arrière.
- Mettre en place une chaîne GitOps : dépôt de configuration, agent de réconciliation, correction automatique de la dérive.
- Distinguer logs, métriques et traces ; écrire des requêtes PromQL de base ; définir un SLI, un SLO et raisonner en budget d'erreur.
Environnement de travail
- Forge locale : Gitea en conteneur Podman, qui sert aussi de registre d'images, avec son runner (act_runner) qui exécute des workflows au format GitHub Actions. Aucune dépendance à un service en ligne.
- Un cluster kind, recréé au TP 20 pour qu'il sache tirer les images du registre de Gitea.
- Argo CD et kube-prometheus-stack (Prometheus, Alertmanager, Grafana), installés dans le cluster avec Helm.