Casser pour comprendre, le diagnostic de pannes
La méthode de diagnostic Kubernetes
Avant les pannes, la méthode. Elle découle du chapitre 20 : une panne, c'est un endroit où le réel diverge du désiré et où un contrôleur n'arrive pas à corriger. Quatre commandes, dans cet ordre, répondent à presque tout :
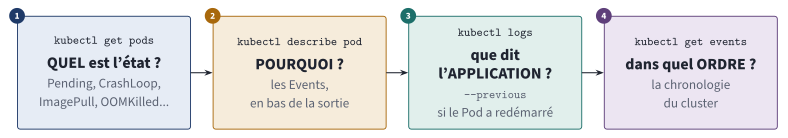
La méthode de diagnostic en quatre questions. On passe à l'étape suivante seulement quand la précédente n'a pas suffi.
PDF vectoriel| Commande | Ce qu'elle révèle |
|---|---|
kubectl get pods -n listify | L'état de chaque Pod : le statut nomme souvent déjà la panne |
kubectl describe pod <nom> -n listify | Les Events (en bas) : ce que le kubelet/scheduler ont tenté et pourquoi ça échoue |
kubectl logs <nom> -n listify [--previous] | Ce que dit l'application ; --previous pour un conteneur qui a redémarré |
kubectl get events -n listify --sort-by=.lastTimestamp | La chronologie des événements du namespace |
Apprenez à lire le statut d'un Pod, il nomme la panne :
| Statut | Signification | Piste |
|---|---|---|
Pending | Pas encore placé/démarré | Ressources insuffisantes (scheduler), PVC non lié, image en cours de pull |
ImagePullBackOff / ErrImagePull | Image introuvable | Nom/tag erroné, image non chargée dans kind, registre inaccessible |
CrashLoopBackOff | Le conteneur démarre et meurt en boucle | Erreur applicative, mauvaise config, liveness trop stricte |
OOMKilled | Tué pour dépassement mémoire | limits.memory trop basse (code de sortie 137, ch. 15 !) |
Running mais 0/1 READY | Vivant mais pas prêt | La readiness échoue (une dépendance manque) |
Partie A : les pannes injectées (2 h)
L'enseignant applique une panne (vous ne savez pas laquelle). Pour chacune, produisez un post-mortem au runbook :
- Symptôme : ce que voit l'utilisateur / ce que montre
kubectl get pods. - Méthode : les commandes lancées, dans l'ordre, et ce qu'elles ont montré.
- Cause racine : la phrase précise.
- Correction : la commande, et la preuve que c'est réparé.
- Prévention : qu'est-ce qui aurait évité, détecté plus tôt, ou auto-corrigé ?
Banque de pannes du bloc 2 (réservé enseignant, ne pas lire si vous jouez le jeu)
Chaque panne s'injecte en une commande, sur le Listify du TP 16. À rejouer en soutenance.
- Image inexistante :
kubectl set image deployment/backend backend=localhost/listify-backend:2.0 -n listify. →ImagePullBackOff. Les Events le disent. (L'exemple travaillé ci-dessus.) - Probe readiness cassée : porter la readiness sur un mauvais chemin (
/nope) ou un mauvais port. → PodsRunningmais0/1 READY, retirés du Servicebackend→ l'appli répond 502/503.describe:Readiness probe failed. Piège pédagogique : le Pod n'est PAS malade, il est juste jugé « pas prêt ». - Limite mémoire trop basse :
resources.limits.memory: 16Misur le backend. →OOMKilled,CrashLoopBackOff, code 137. Relie au cgroupmemorydu bloc 1. - Service sans endpoints : casser le
selectordu Servicebackend(tier: backendd). → le Service n'a plus d'Endpoints (kubectl get endpoints backend -n listifyest vide), l'appli tombe, mais tous les Pods sont sains ! Diagnostic le plus subtil : le problème est le lien label/selector, pas les Pods. Leçon centrale du chapitre 21. - Secret manquant : supprimer le Secret
listify-db. → nouveaux Pods backend enCreateContainerConfigError(describe:secret "listify-db" not found). La config référencée n'existe pas. - PVC / base :
kubectl delete pod db-0 -n listifypendant une écriture, ou saturer le stockage. → réapparition de db-0, données intactes (PVC) ; vérifier que le backend revient via readiness. - Requests trop hautes :
resources.requests.memory: 100Gi. → PodPendingindéfiniment ;describe:Insufficient memory, le scheduler ne trouve aucun nœud. Relie requests ↔ placement (ch. 22).
Partie B : l'épreuve chronométrée (1 h, notée)
En temps limité, l'enseignant injecte deux pannes simultanées sur votre cluster. Vous devez, en 30 minutes : les identifier, les corriger, et remettre Listify en marche, en commentant votre démarche à voix haute (comme en soutenance). La note porte sur la méthode (avez-vous suivi get → describe → logs → events ?), pas seulement sur le résultat. Un diagnostic juste mais chanceux vaut moins qu'une méthode rigoureuse qui converge.
Partie C : rendre le système plus diagnosticable (1 h)
Un bon opérateur ne fait pas que réparer : il rend les pannes plus lisibles pour la prochaine fois. Améliorez votre Listify :
- Des probes justes : vérifiez que readiness et liveness testent la bonne chose (readiness = dépendances, liveness = soi-même). Une mauvaise probe crée des pannes.
- Des ressources déclarées : sans requests/limits, le scheduler place mal et l'OOM frappe au hasard. Ajoutez-les partout et justifiez les valeurs.
- Des messages clairs : votre
/api/healthrenvoie-t-il un message utile quand la base manque (rappel du TP 4 du S1) ? Un health check bavard accélère le diagnostic.
Point de contrôle final
- La méthode get → describe → logs → events appliquée systématiquement (au runbook)
- Au moins quatre pannes de la partie A diagnostiquées avec post-mortem complet
- Épreuve chronométrée réussie, méthode commentée
- Chaque statut de Pod (Pending, ImagePullBackOff, CrashLoop, OOMKilled, 0/1 Ready) rencontré et compris
- Partie C : probes et ressources améliorées, justifiées
Pour aller plus loin (bonus)
kubectl debug: attachez un conteneur éphémère de débogage à un Pod problématique pour l'inspecter de l'intérieur, sans le modifier. Un outil moderne puissant.- Les événements en continu :
kubectl get events -A --watchpendant que vous cassez et réparez : vous voyez les contrôleurs réagir en temps réel. La réconciliation, filmée. - k9s : installez ce tableau de bord terminal ; il rend
get/describe/logsinteractifs. Comparez le confort aukubectlbrut (mais maîtrisezkubectld'abord : c'est lui qui est à l'examen).
Questions de compréhension (à préparer pour le TD et l'examen)
- Un Service « sans endpoints » alors que tous les Pods sont
Running: expliquez la cause (label/selector) et pourquoi c'est le diagnostic le plus trompeur. Quelle commande le révèle immédiatement ? - Distinguez
CrashLoopBackOff(le conteneur meurt en boucle) et0/1 Running(vivant mais pas prêt). Quelle probe est en cause dans chaque cas, et quelle est la bonne correction ? - Un Pod reste
Pendingindéfiniment. Donnez trois causes possibles et la commande qui départage. Reliez au rôle du scheduler (ch. 20) et aux requests (ch. 22). - Pourquoi la méthode (get → describe → logs → events) est-elle plus fiable que l'intuition ? Reliez au modèle de réconciliation : que cherche-t-on, exactement, à chaque étape ?