Exploiter un cluster, et packager avec Helm
1. Requests et limits : dire au cluster ce dont on a besoin
Chaque conteneur peut déclarer ses besoins en ressources, et c'est essentiel pour que le cluster fonctionne bien :
resources:
  requests:            # ce dont le conteneur a BESOIN (garanti)
    cpu: "100m"        # 100 millicœurs = 0,1 cœur
    memory: "128Mi"
  limits:              # ce qu'il ne peut PAS dépasser
    cpu: "500m"
    memory: "256Mi"
Deux rôles distincts, à ne pas confondre (question d'examen) :
- requests = la réservation garantie. Le scheduler (ch. 20) s'en sert pour placer le Pod : il ne le met que sur un nœud ayant au moins ce libre. Sous-estimer les requests, c'est risquer de surcharger un nœud ; les surestimer, c'est gaspiller.
- limits = le plafond. Un conteneur qui dépasse sa limite CPU est freiné (throttled) ; un qui dépasse sa limite mémoire est tué par l'OOM killer : le fameux OOMKilled, code de sortie 137 (bloc 1, ch. 15 !). La panne mémoire de Kubernetes vient exactement du contrôleur cgroup
memoryque vous avez manipulé au TP 11. Rien de neuf sous le soleil, tout est réassemblé.
2. Les probes : la santé, vue par Kubernetes
Le kubelet (ch. 20) surveille chaque conteneur avec jusqu'à trois sondes. Elles répondent à des questions différentes, et les confondre cause des pannes vicieuses (TP 17) :
| Probe | Question | Si elle échoue |
|---|---|---|
| liveness | « Le conteneur est-il vivant (non bloqué) ? » | Kubernetes redémarre le conteneur |
| readiness | « Est-il prêt à recevoir du trafic ? » | Kubernetes le retire des Services (pas de trafic), sans le tuer |
| startup | « A-t-il fini de démarrer ? » | Protège les deux autres pendant un démarrage lent |
livenessProbe:
  httpGet: { path: /api/health, port: 8000 }
  initialDelaySeconds: 5
  periodSeconds: 10
readinessProbe:
  httpGet: { path: /api/health, port: 8000 }
  periodSeconds: 5
La distinction liveness/readiness est subtile et centrale. Reprenez votre /api/health du S1 (TP 2) : il vérifiait l'API et la base. Utilisé en liveness, c'est dangereux : si la base tombe, la liveness échoue, Kubernetes redémarre le backend... qui échouera encore, en boucle, alors que le backend n'a rien de cassé. Utilisé en readiness, c'est correct : le backend est retiré du trafic tant que la base est absente, puis réintégré quand elle revient, sans redémarrage inutile. Règle : liveness = suis-je cassé (redémarre-moi) ; readiness = puis-je servir maintenant (envoie-moi du trafic ou pas). Une readiness qui teste les dépendances, une liveness qui ne teste que soi-même.
3. Les stratégies de déploiement
Comment passer de la v1 à la v2 ? Le Deployment offre deux stratégies natives, et deux autres se construisent par-dessus :
| Stratégie | Principe | Compromis |
|---|---|---|
| RollingUpdate (défaut) | Remplace les Pods progressivement (maxSurge, maxUnavailable) | Zéro coupure, mais v1 et v2 coexistent un moment |
| Recreate | Tue tout le v1, puis lance le v2 | Coupure brève, mais jamais de coexistence (utile si v1/v2 incompatibles, ex. schéma de base) |
| Blue-green (concept) | Deux environnements complets ; on bascule le trafic d'un coup | Rollback instantané, mais double les ressources |
| Canary (concept) | On envoie d'abord un petit % du trafic vers la v2, on observe, on généralise | Détecte les régressions sur peu d'utilisateurs ; demande de l'outillage (Ingress avancé, service mesh) |
Le rolling update est le « déploiement sans coupure » du reverse proxy S1, désormais géré par le Deployment controller : il fait décroître l'ancien ReplicaSet et croître le nouveau, en respectant les probes de readiness (il n'envoie du trafic à un nouveau Pod que quand il est prêt). Et le rollback est immédiat (kubectl rollout undo), car l'ancien ReplicaSet est conservé à zéro. Blue-green et canary, plus avancés, relèvent du bloc 3 (progressive delivery) et sont à connaître en concepts.
4. RBAC : qui a le droit de faire quoi (en survol)
Le RBAC (Role-Based Access Control) contrôle les autorisations dans le cluster : qui (un utilisateur, un ServiceAccount) peut faire quelle action (get, create, delete) sur quelles ressources (Pods, Secrets...) dans quel namespace. C'est le moindre privilège du S1 (chapitre 5), appliqué à l'API Kubernetes : un composant ne reçoit que les verbes dont il a strictement besoin.
On le mentionne en survol au S2 (un Role + un RoleBinding qui accorde des droits précis à un ServiceAccount), mais retenez le principe : dans un cluster de production, tout passe par l'API server, et le RBAC est ce qui empêche un Pod compromis d'y faire n'importe quoi. C'est la défense en profondeur du S1, au niveau du plan de contrôle.
5. Helm : l'apt-get de Kubernetes
5.1 Le problème
Au TP 16, Listify sera une dizaine de manifests YAML (Deployment backend, frontend, Service ×3, Ingress, ConfigMap, Secret, PVC, StatefulSet...). Les redéployer pour un autre environnement (dev/prod) suppose de dupliquer et d'éditer tout cela à la main : la duplication d'information du chapitre 9 du S1, revenue au niveau des manifests. Helm est la réponse.
5.2 Le modèle Helm
Helm est le gestionnaire de paquets de Kubernetes. Ses notions :
- Chart : un paquet, c'est-à-dire un ensemble de templates de manifests (avec des trous à remplir) plus des valeurs par défaut.
- Values : les paramètres (
values.yaml) qui remplissent les templates. On les surcharge par environnement. - Release : une installation d'un chart avec un jeu de valeurs, suivie et versionnée par Helm (avec rollback).
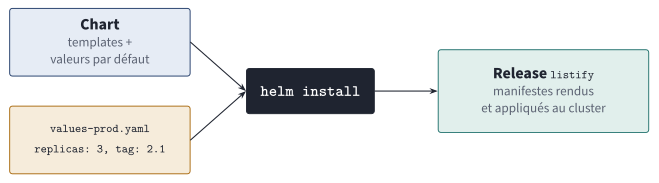
Chart, valeurs, release. Le même chart produit des releases différentes selon les valeurs : c'est l'équivalent Kubernetes d'un rôle Ansible paramétré.
PDF vectorielL'analogie du chapitre : Helm est à Kubernetes ce qu'APT était au S1 (chapitre 2). Un chart s'installe (helm install), se met à jour (helm upgrade), se retire (helm uninstall), et l'écosystème publie des milliers de charts prêts à l'emploi (comme les dépôts APT) : au bloc 3, vous installerez tout le stack de monitoring d'une seule commande helm install.
5.3 Un template Helm, concrètement
spec:
  replicas: {{ .Values.backend.replicas }}
  template:
    spec:
      containers:
        - name: backend
          image: "{{ .Values.backend.image }}:{{ .Values.backend.tag }}"
backend:
  replicas: 2
  image: listify-backend
  tag: "1.0"
Vous reconnaissez exactement les templates Jinja2 + inventaire d'Ansible (S1, TP 8) : la configuration se calcule à partir de valeurs séparées. helm install listify ./chart -f values-prod.yaml déploie la version « prod » sans toucher aux templates. Un seul chart, N environnements : la promesse « code séparé des données » tenue au niveau Kubernetes. C'est le TP 18.
Ce qu'il faut retenir
- requests = réservation garantie (base du placement par le scheduler) ; limits = plafond (dépassement mémoire → OOMKilled 137, le cgroup
memorydu bloc 1). Bien les déclarer conditionne le bon fonctionnement et la priorité de survie (QoS). - Probes : liveness (vivant ? sinon redémarre, ne teste que soi-même), readiness (prêt ? sinon retiré du trafic, peut tester les dépendances), startup (démarrage lent). Ne jamais mettre un check de dépendance en liveness (boucle de redémarrage).
- Stratégies : RollingUpdate (défaut, sans coupure, coexistence v1/v2 → migrations compatibles), Recreate (coupure, pas de coexistence), blue-green et canary en concepts (bloc 3). Rollback instantané (
rollout undo). - RBAC : moindre privilège appliqué à l'API Kubernetes.
- Helm = l'APT de Kubernetes : chart (templates + valeurs), values (paramètres par env), release (installation suivie). Même idée que les templates Ansible du S1 : un chart, N environnements.
Regard recherche
Bibliographie du chapitre
Sources primaires
- Documentation Kubernetes : « Managing Resources for Containers » (requests/limits), « Configure Liveness, Readiness and Startup Probes », « Deployments » (stratégies), « Using RBAC Authorization ». kubernetes.io/docs.
- Documentation Helm : helm.sh/docs : « Charts », « Values Files », « Chart Template Guide ». La référence du TP 18.
Lectures recommandées
- Betsy Beyer et al., Site Reliability Engineering, chapitres sur les SLO et la gestion de la charge : le « pourquoi » exploitation derrière requests/limits et probes. Gratuit en ligne.
- Marko Lukša, Kubernetes in Action, chapitres sur les probes et les ressources : très pédagogiques, avec des exemples de pannes.
Pour aller plus loin
- Le Horizontal Pod Autoscaler et le Vertical Pod Autoscaler : documentation Kubernetes, pour prolonger la section « échelle » du chapitre 19.
- Helm : écrire ses propres fonctions de template (
_helpers.tpl), les hooks, les tests de chart. Le chart de kube-prometheus-stack (bloc 3) est un cas d'étude avancé.