Bloc 2 : orchestration, Kubernetes
Semaines 6 à 10. Vous savez maintenant conteneuriser une application (bloc 1). Mais lancer trois conteneurs à la main sur votre poste ne fait pas une production. Que se passe-t-il quand vous avez cinquante conteneurs sur dix machines ? Qui décide où les placer ? Qui les redémarre quand ils meurent ? Qui les met à l'échelle un mardi soir de forte charge ? Qui remplace une version par la suivante sans coupure ? Ce sont les questions de l'orchestration, et la réponse dominante de l'industrie s'appelle Kubernetes.
Le fil conducteur : la réconciliation, déjà rencontrée
Vous n'abordez pas Kubernetes en terrain inconnu. Son idée centrale, la boucle de réconciliation (comparer un état désiré à l'état réel et agir pour les faire coïncider), vous l'avez déjà vue trois fois au S1 :
- Terraform :
plancompare la configuration au state,applyconverge. - Ansible : le playbook compare l'état des machines à l'état voulu, et corrige.
- Même le pool Nginx du TP 6, qui réintégrait tout seul un backend guéri.
Kubernetes généralise ce principe à un système entier, et le fait tourner en continu, pas seulement quand vous lancez une commande. C'est la différence décisive, et le cœur théorique du bloc.
L'architecture cible du bloc
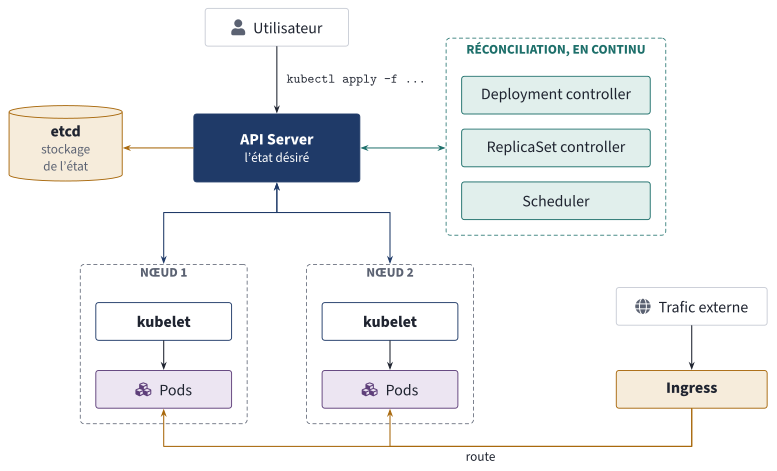
L'architecture cible du bloc : vous déclarez un état désiré, le cluster le réalise et le maintient. Tout passe par l'API Server.
PDF vectorielÀ la fin du bloc, Listify tourne sur un cluster Kubernetes local (kind), décrit par des manifests déclaratifs, avec auto-réparation, mises à l'échelle, mises à jour sans coupure, et packagé en chart Helm réutilisable.
Organisation du bloc
| Semaine | CM | TP |
|---|---|---|
| 6 | Ch. 19 : Le problème de l'orchestration | TP 15 (début) : cluster kind, premier Pod |
| 7 | Ch. 20 : Le modèle mental de Kubernetes (réconciliation) | TP 15 (fin) : Deployment, auto-réparation vue en direct |
| 8 | Ch. 21 : Les objets fondamentaux | TP 16 : Listify complet (Ingress, ConfigMap, Secret, PVC, probes) |
| 9 | Ch. 22 : Exploiter un cluster + Helm | TP 17 : casser pour comprendre (pannes injectées) |
| 10 | Synthèse + révisions | TP 18 : packager le fil rouge en chart Helm |
Ce que vous saurez faire à la fin du bloc
- Expliquer pourquoi l'orchestration est nécessaire et situer Kubernetes dans son histoire (Borg, Mesos, Swarm).
- Décrire le modèle de Kubernetes : API déclarative, boucles de réconciliation, etcd, scheduler, kubelet, controllers.
- Créer et relier les objets fondamentaux : Pod, ReplicaSet, Deployment, Service, Ingress, ConfigMap, Secret, PV/PVC, StatefulSet.
- Exploiter : requests/limits, probes (liveness/readiness/startup), stratégies de déploiement (rolling, recreate), RBAC en survol.
- Diagnostiquer méthodiquement une panne (
kubectl describe/logs/events) : la compétence la plus évaluée du semestre. - Packager une application en chart Helm avec des valeurs par environnement.
Environnement de travail
- Cluster local : kind (
KIND_EXPERIMENTAL_PROVIDER=podman), léger et jetable, idéal pour apprendre et casser sans risque. minikube (pilote Podman) ou k3s en VM Vagrant sont des solutions de repli. - kubectl, la ligne de commande de Kubernetes, et Helm pour le packaging.
- Tout tourne sur votre poste, sans aucun compte cloud.
Le débat honnête : faut-il tout mettre dans Kubernetes ?
Kubernetes est puissant, mais complexe, et cette complexité a un coût réel (exploitation, courbe d'apprentissage, ressources). Ce bloc vous apprend Kubernetes ; il vous apprend aussi à savoir quand ne pas l'utiliser. La question « faut-il mettre sa base de données dans Kubernetes ? » (chapitre 21, StatefulSet) est le cas d'école de cet esprit critique, attendu à l'examen (compétence C1). Un ingénieur mûr connaît l'outil et ses limites.